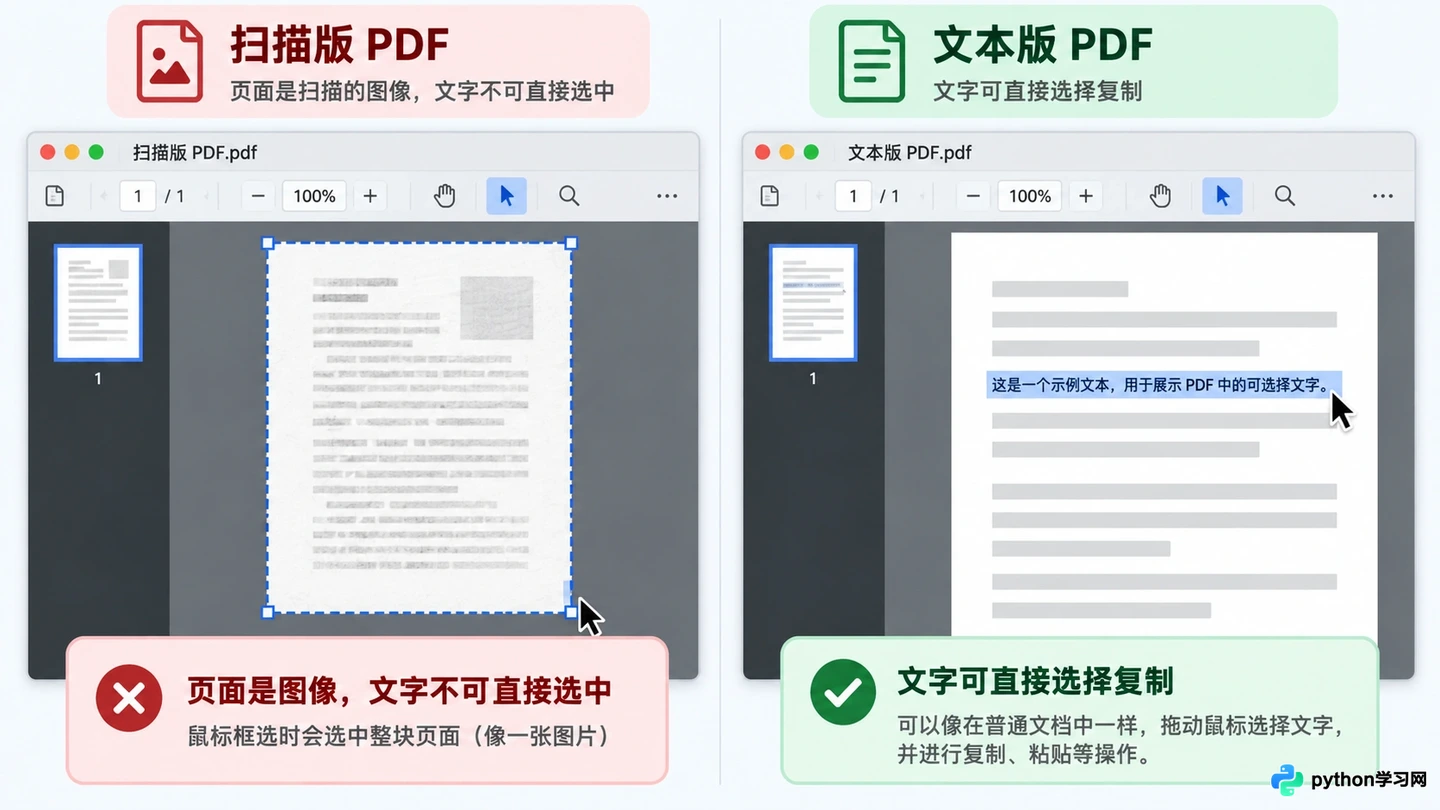
扫描版PDF怎么翻译?结合OCR与AI实现高精度图文转换
针对无法直接复制文字的扫描版PDF,本教程演示如何结合OCR识别与AI大模型,实现保留排版的高精度图文翻译。通过提取文本、调用AI翻译及重新排版,解决图片型文档的跨语言阅读难题。
2026-11-01
19

针对无法直接复制文字的扫描版PDF,本教程演示如何结合OCR识别与AI大模型,实现保留排版的高精度图文翻译。通过提取文本、调用AI翻译及重新排版,解决图片型文档的跨语言阅读难题。
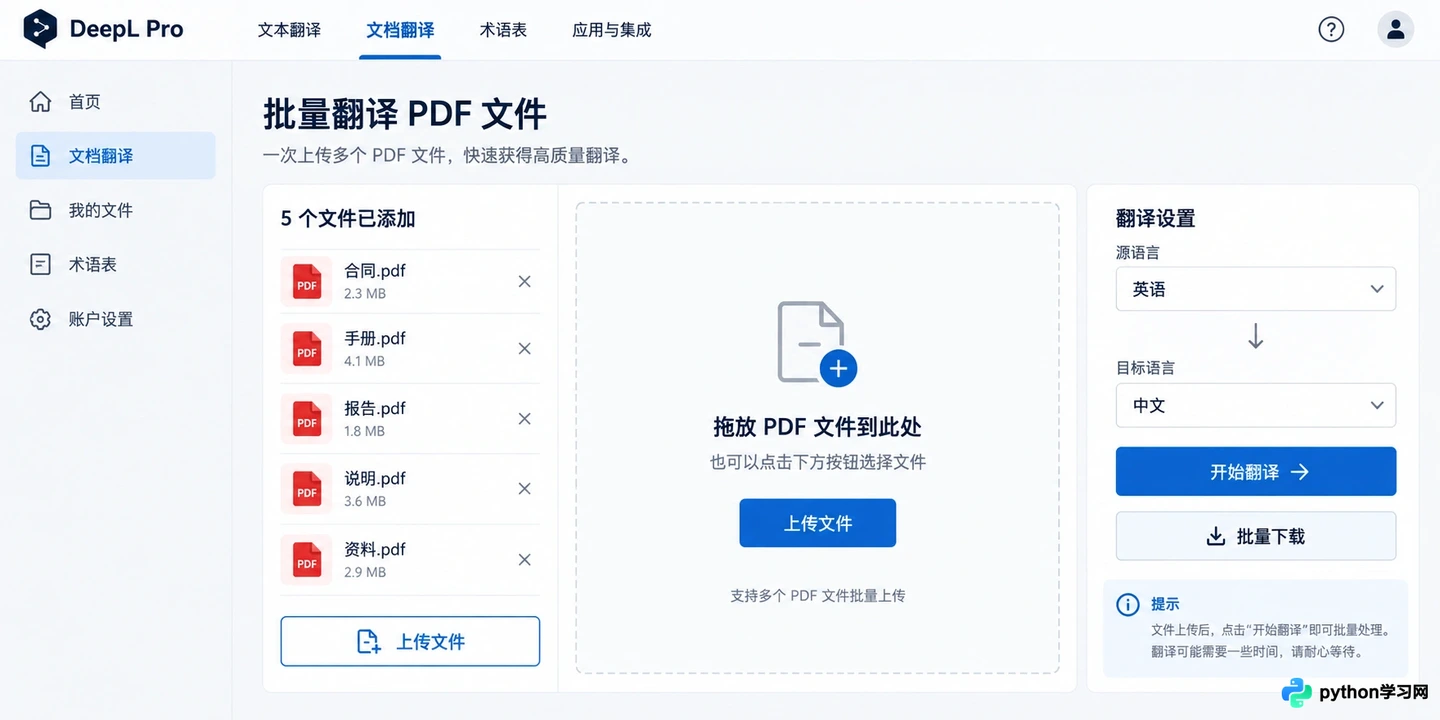
面对堆积如山的PDF文档,手动复制粘贴不仅低效还容易出错。本文介绍如何利用DeepL、彩云小译等支持批量的AI工具,结合OCR技术,快速完成多语言文档的精准翻译,同时保持原有排版格式。
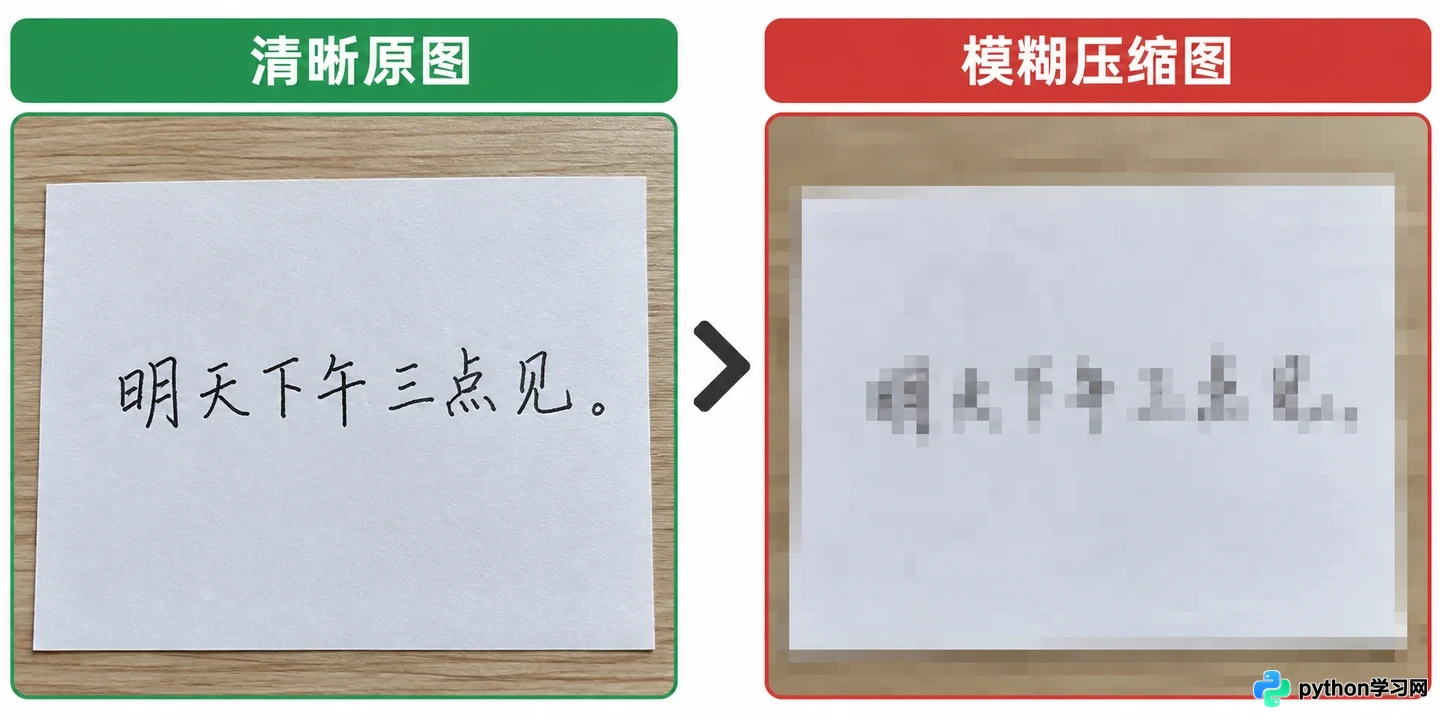
针对AI图片翻译中手写体识别错误或模糊文字乱码的问题,本文从源头图片质量、OCR原文校对、语言设置及工具验证四个维度提供实用排查技巧。强调先确保识别原文准确再进行翻译,并建议在处理敏感数据时注意隐私安全,帮助用户在复杂场景下获得更可靠的翻译结果。
本文详解RAGFlow如何通过深度文档理解模型处理PDF中的复杂表格和扫描件。通过配置视觉模型与OCR引擎,实现从图片到结构化数据的精准提取,解决传统RAG工具在非结构化文档解析上的痛点,提升知识库检索准确率。
本文介绍如何利用Python从包含文字和图片的PDF文件中提取文本。通过安装tika、wand和pytesseract库,结合Tika进行基础文本解析与Pytesseract进行OCR图像识别,实现完整的内容提取。文章提供了完整的代码示例、中文语言包配置方法及命令行执行步骤,帮助开发者快速处理复杂PDF文档。
本文介绍 Python 轻量级 OCR 库 muggle_ocr 的安装与使用方法。通过 pip 安装后,可初始化 SDK 选择 ModelType.OCR(常规文本)或 ModelType.Captcha(验证码)。文章提供读取图片、调用 predict 函数获取识别结果的完整代码示例,并简述自定义模型的使用方式。
本文介绍如何利用豆包电脑版的桌面端优势,通过拖拽上传实现百页PDF快速摘要,利用分屏布局进行代码调试与解释,以及使用全局快捷键完成屏幕内容的即时识别与提取,提升办公与开发效率。
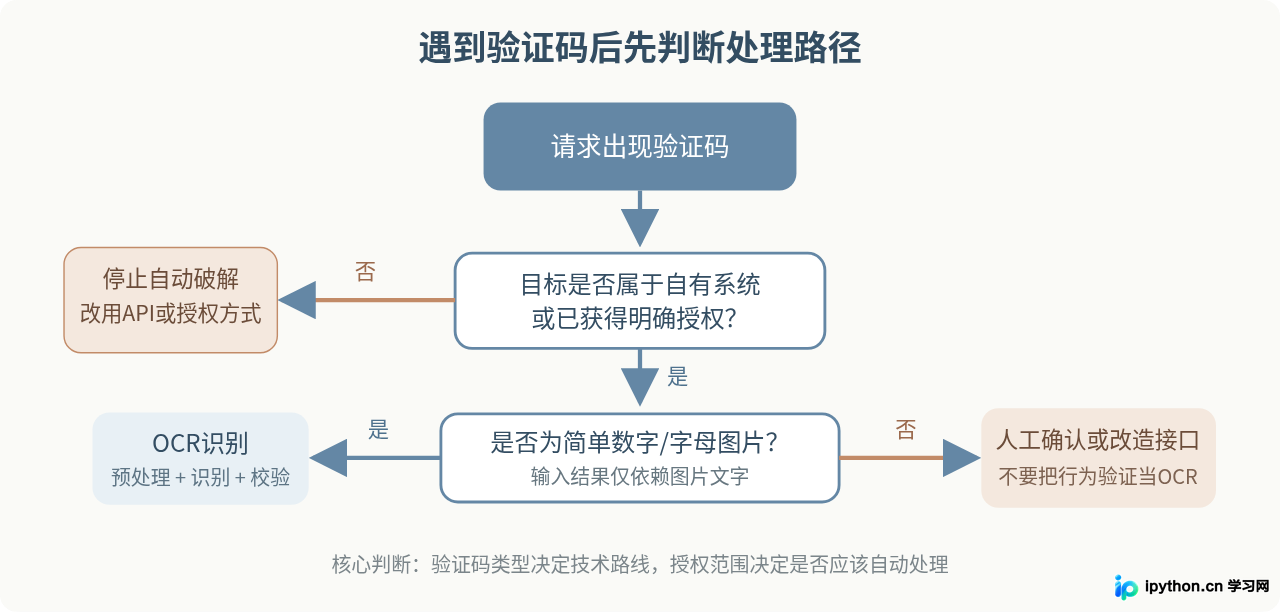
讲解Python爬虫遇到验证码时的处理思路,包括验证码类型判断、OCR识别、图像预处理、人工打码平台接口设计、失败重试和合规边界,并提供可运行的Python示例。