

Python基于Numpy手动实现K-Means聚类算法详解
本文详细介绍如何使用Python和Numpy库从零实现K-Means聚类算法。内容涵盖聚类基本概念、K-Means算法流程、距离度量方式(欧氏、曼哈顿、余弦),以及利用手肘法确定最佳聚类数K值的原理与代码实现。通过完整示例代码和可视化结果,展示如何计算误差平方和并绘制聚类图与手肘图,帮助读者深入理解算法逻辑与工程落地。
2026-10-12
6

本文详细介绍如何使用Python和Numpy库从零实现K-Means聚类算法。内容涵盖聚类基本概念、K-Means算法流程、距离度量方式(欧氏、曼哈顿、余弦),以及利用手肘法确定最佳聚类数K值的原理与代码实现。通过完整示例代码和可视化结果,展示如何计算误差平方和并绘制聚类图与手肘图,帮助读者深入理解算法逻辑与工程落地。
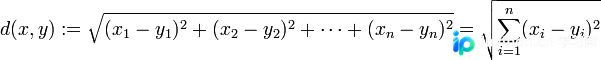
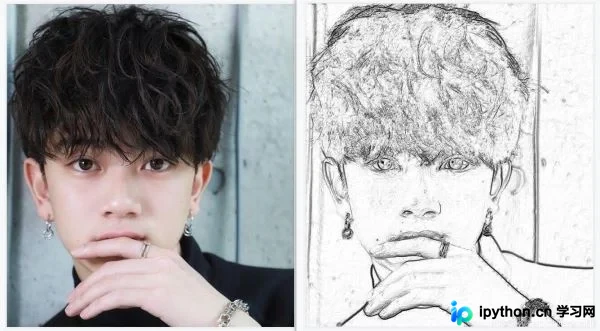
本文介绍如何利用Python的Numpy和PIL库将普通图片转换为手绘风格。通过读取图像数组、计算梯度并归一化,再结合模拟光源效果调整像素值,最终保存为手绘图片。
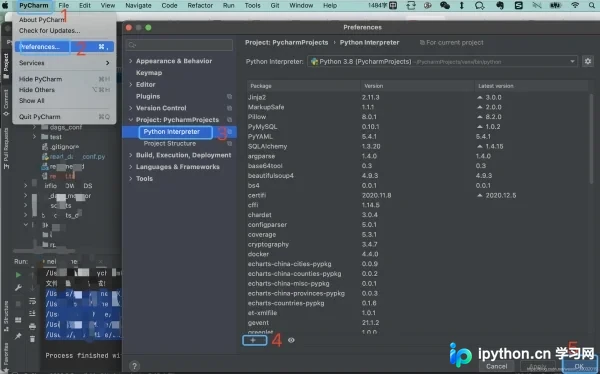
本文系统介绍Python数据分析生态中的七个核心库,涵盖NumPy、SciPy、Pandas、Scikit-learn及Matplotlib等可视化工具。详细解析各库功能特性,并提供Anaconda发行版、pip命令及PyCharm环境下的多种安装指南,最后通过NumPy的vdot函数示例展示基础应用,助力开发者快速构建数据处理工作流。
本文详解Python中NumPy库的核心对象ndarray。涵盖数组的多种创建方式(如arange、linspace、ones等)、索引切片技巧、基础与矩阵运算方法,以及内置数据类型。通过具体代码示例,帮助开发者高效掌握NumPy在科学计算中的基础应用。
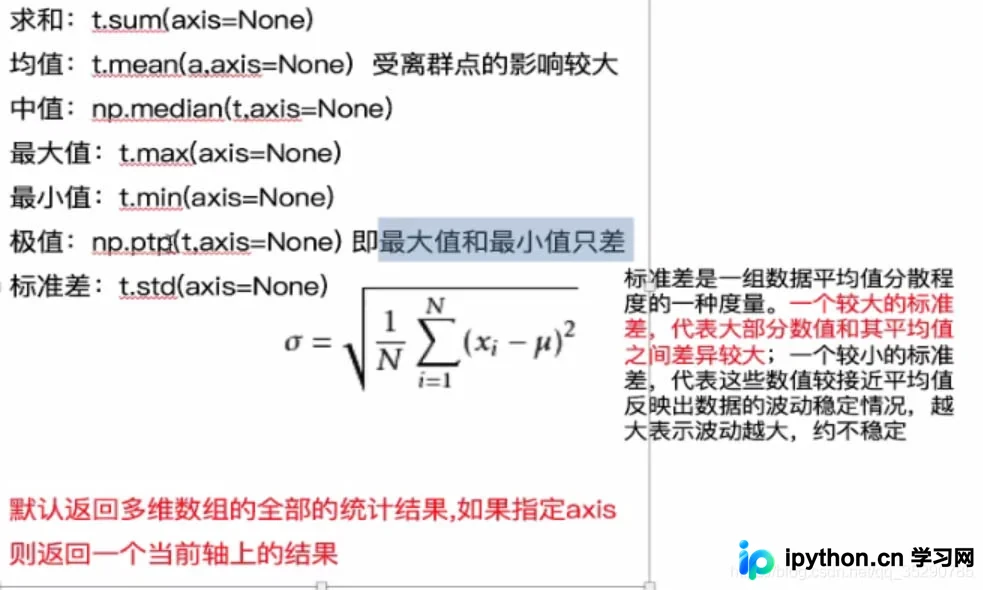
在数据分析与科学计算中,处理包含缺失值(NaN)的数值数组时,直接调用最大值或均值函数极易返回意外结果。本文深度对比np.nanmax与数组.max()的底层差异,解析自动过滤NaN的计算逻辑,提供多场景执行效率参考,并系统梳理常见统计函数的正确调用方式,帮助开发者规避数据处理陷阱。
详细介绍Python h5py库的核心操作,涵盖HDF5文件的读写模式配置、一维及多维数据集的创建与NumPy数据对接,以及组的嵌套管理与路径映射机制。提供完整代码示例与运行结果对照,适用于数据存储与科学计算场景的快速上手。
本文详解Python科学计算库NumPy的配置与核心用法。涵盖从命令行安装到环境验证的流程,通过代码演示一维至多维数组的创建方法、常用属性查看技巧,以及元素级算术运算、统计函数应用与索引切片操作,助您快速建立数据分析与矩阵计算的基础工作流。
本文详细对比Python原生列表与NumPy数组在多维数据处理上的核心差异。通过转置、形状查询、切片边界、乘法与等号运算等代码实例,说明二者在属性支持、运算逻辑与底层存储机制上的不同,助你在科学计算中高效选型。
介绍如何使用Python的NumPy与Matplotlib库生成标准数学函数图像。涵盖环境配置、一维数组构建方法,并提供一元一次、二次、指数、三角函数及高级坐标轴定制的具体代码与参数说明,快速掌握科学计算可视化的核心操作。
在NumPy数据处理中,经常需要生成或提取矩阵对角线上的数值。许多开发者容易将生成函数与提取函数混淆。本文将直接演示 numpy.diag() 的双向用法:传入一维数组自动构建对角矩阵,传入二维矩阵精准提取指定偏移的对角线元素,附带核心参数解析与标准代码示例。
在Python数据处理中,经常需要根据特定规则对NumPy数组进行筛选或批量赋值。本文演示三种常用方法:直接条件索引、np.where()函数映射以及布尔掩码逻辑运算,帮助开发者快速定位符合条件的位置并实现值替换。
本文详细介绍 Python NumPy 库中数组的集合操作方法。区别于内置类型,NumPy 数组需使用专用 API(如 np.intersect1d、np.union1d)实现交集、并集、差集与对称差集计算。文章涵盖函数用法、重复元素处理机制、多数组批量运算技巧及性能注意事项,帮助开发者准确高效地进行数组集合运算。