

NumPy ndarray 核心属性详解与实战调用
NumPy 作为 Python 数据分析的基石,其核心数据结构 ndarray 封装了大量元数据属性,便于快速掌握数组的维度、内存布局与类型特征。本文将系统演示 ndarray.ndim、shape、size、dtype、itemsize、flags 等核心属性的实际调用方式,结合完整代码与运行结果输出,帮助开发者在数据处理与模型调试中高效进行结构分析与内存评估。
2026-10-12
7

NumPy 作为 Python 数据分析的基石,其核心数据结构 ndarray 封装了大量元数据属性,便于快速掌握数组的维度、内存布局与类型特征。本文将系统演示 ndarray.ndim、shape、size、dtype、itemsize、flags 等核心属性的实际调用方式,结合完整代码与运行结果输出,帮助开发者在数据处理与模型调试中高效进行结构分析与内存评估。
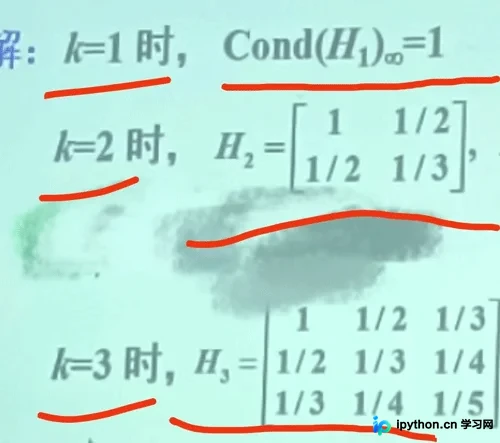
本文详细讲解利用Python与NumPy库生成Hilbert矩阵的核心逻辑。通过解析行列下标与元素值的对应规律,提供基础构造代码,并演示如何扩展生成包含行求和结果的增广矩阵。附完整源码、运行结果及关键参数说明,帮助开发者快速掌握矩阵计算技巧。
在 Python 数据处理中,NumPy 是最核心的科学计算库之一。本文详解如何使用整数索引访问一维、二维及三维数组元素,并结合负索引语法实现从末尾向前取值,附带完整代码运行结果与参数对照说明。
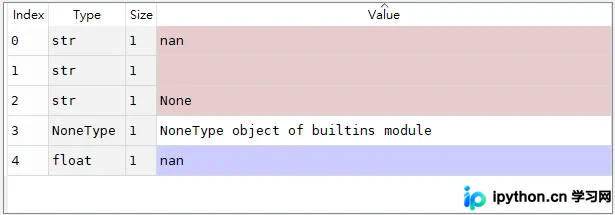
在NumPy数据处理流程中,NaN缺失值的判定存在明确的语法陷阱。直接使用等号比较或布尔条件会引发逻辑误判。本文系统梳理基于np.isnan()、身份运算符的标准验证方案,并结合Pandas内置函数演示如何高效过滤混合数据源,同时厘清None与空字符串的类型边界。
本文详解 NumPy 内置的 numpy.concatenate 函数,讲解如何沿指定轴将多个数组高效拼接为新数组。核心要点包括数组形状匹配条件、axis 参数的三种取值逻辑(默认行合并、按列合并及展平拼接),以及修复 TypeError 的正确传参格式,帮助开发者快速掌握多维数据合并技巧。
本文详解NumPy库中unique()函数的核心参数与实操流程,涵盖一维与多维数组去重、首次出现索引提取、输入矩阵重建及元素频次统计方法。提供可直接运行的代码示例与避坑指南,帮助开发者高效完成数据清洗、重复值过滤与分布特征查询。
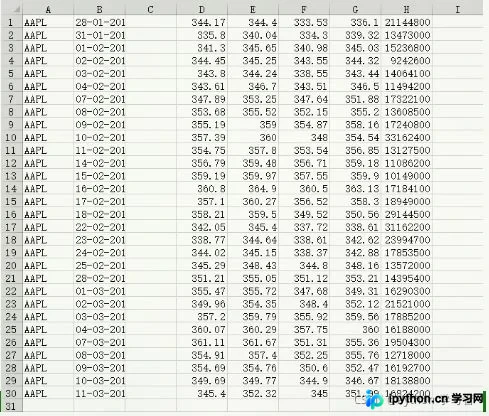
本文以Python NumPy库为核心,展示如何从TXT与CSV文件中加载数据,并演示如何利用内置函数完成单位矩阵生成、加权平均价格(VWAP/TWAP)、基础统计量(均值、中位数、方差、极差)以及股票收益率与波动率的量化计算。代码已适配Python 3环境,可直接应用于金融数据预处理与统计分析场景。
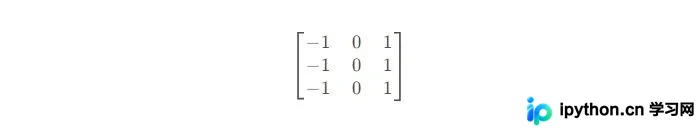
本文详细解析Python中常用的卷积函数,对比全量、同尺寸及有效交叠三种输出模式,图解scipy.ndimage的边界填充策略,并通过基准测试验证各方案的性能差异,最后演示如何利用卷积核完成图像纵向边缘提取。
本文介绍Python中实现图片灰度化的三种核心算法:最大值法、平均值法及加权平均法。重点解析基于matplotlib和numpy的代码实现,说明scipy.misc.imread已弃用的现状,并对比不同算法在视觉效果上的差异,特别是加权平均法因符合人眼敏感度而带来的更优体验。
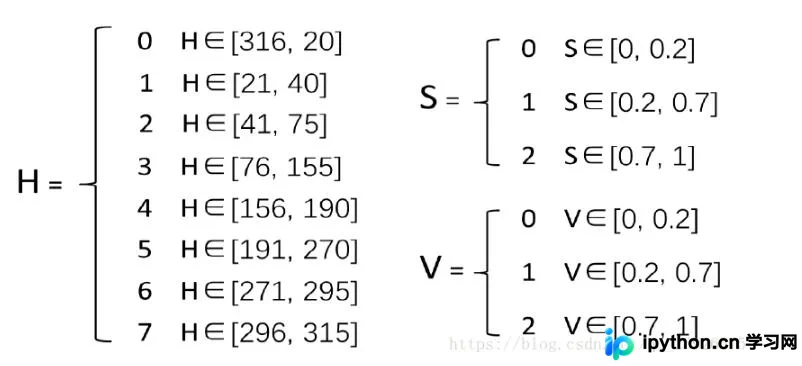
本文介绍在Python中如何对HSV颜色空间进行量化操作以提取颜色特征。通过对比双重for循环与NumPy的ufunc函数,展示了利用自定义ufunc加速颜色量化的方法。文章包含将RGB转换为HSV、基于人眼感知特性进行分量量化、合成72维矢量及绘制直方图的完整代码示例,并提供了性能优化前后的时间对比数据。
本文详细解析Python NumPy中两种常见索引方式的区别。通过具体代码示例,对比`array[0][0]`(链式索引)与`array[0,0]`(元组索引)的执行机制与性能差异,帮助开发者理解底层原理并选择更高效的访问方式。
在数据处理中,将 DataFrame 某一列的数据向下顺移一位是常见需求。直接通过 loc 赋值或使用循环替换不仅容易报错,且处理大量数据时效率极低。本文介绍利用 Pandas 内置的 shift 方法,以及通过 Numpy 数组切片转换实现高效顺移的正确方案,解决首行变为 NaN 的问题。