

Python基于Numpy手动实现K-Means聚类算法详解

本文详细介绍如何使用Python和Numpy库从零实现K-Means聚类算法。内容涵盖聚类基本概念、K-Means算法流程、距离度量方式(欧氏、曼哈顿、余弦),以及利用手肘法确定最佳聚类数K值的原理与代码实现。通过完整示例代码和可视化结果,展示如何计算误差平方和并绘制聚类图与手肘图,帮助读者深入理解算法逻辑与工程落地。
K-Means聚类算法概述
1. 聚类的基本概念
聚类是指将物理对象或抽象对象的集合划分为多个由相似对象组成的类的过程。生成的簇(Cluster)是一组数据对象的集合,这些对象在同一个簇内彼此相似,而与其他簇中的对象存在显著差异。
2. K-Means算法详解
定义说明
K-Means算法,又称K均值算法。其中,'k'代表将数据聚类为k个簇,'means'表示取每个聚类中数据值的均值作为该簇的中心,即质心(Centroid)。算法通过每个类的质心来描述和代表该簇。
主要执行步骤
- 设定初始的类别中心点和类别数量k。
- 根据当前的类别中心对所有数据进行分类:将每个数据点划分到距离其最近的类别中。
- 重新计算当前分类下每个类别的中心点:例如,取每个类别中所有点的坐标平均值作为新的中心。计算多个点的平均值方法是分别计算X坐标和Y坐标的平均值,从而得到新的点坐标。需要注意的是,类的中心点可以是虚拟点,不一定非要是数据集中的真实数据点,这不影响算法运行。
- 基于新的类别中心点继续进行数据分类;
- 如果连续两次迭代的分类结果完全一致,则停止算法;否则,重复执行步骤2至5。例如,当类的中心点不再发生显著变化时,跳出循环。
K-Means的距离度量方式
欧氏距离(Euclidean Distance)
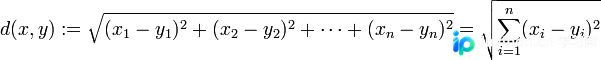
曼哈顿距离(Manhattan Distance)
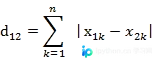
余弦相似度(Cosine Similarity)
假设向量A为(x1, y1),向量B为(x2, y2)。计算公式中,分子为A与B的点积(Dot Product),分母为两者各自L2范数(L2 Norm)的乘积,即所有维度值的平方和开方后的结果相乘。
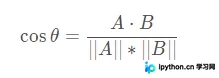
3. 如何确定最佳的K值(类别数)
本文采用手肘法(Elbow Method)进行确定
手肘法原理
对于每一个可能的k值,计算其对应的误差平方和(SSE, Sum of Squared Errors):
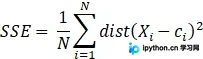
其中,N表示数据点的总个数,Xi代表第i个数据点,ci代表Xi所属簇的中心点。
- 随着聚类数k的增大,样本划分会变得更加精细,每个簇内的聚合程度会逐渐提高,因此误差平方和SSE通常会逐渐减小。
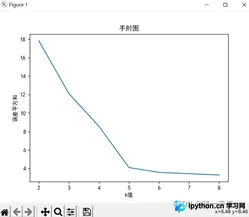
- 当k值小于真实聚类数时,随着k的增加,每个簇的聚合程度会大幅增加,导致SSE的下降幅度很大;而当k值达到真实聚类数时,继续增加k所带来的聚合程度回报会迅速变小,因此SSE的下降幅度会骤减并趋于平缓。也就是说,SSE与k的关系曲线呈现“手肘”形状,该手肘转折点对应的k值即为数据的真实聚类数。
Python代码实现K-Means算法
1. 核心代码实现
import numpy as np
import matplotlib.pyplot as plt
import math

k = eval(input("请输入想要划分的类别个数")) #规定类别数
n = eval(input("请输入要循环的次数"))#规定循环次数
sw = eval(input("请输入想要查询的元素在数据中的位置"))

def readdata():#获取data数据中坐标值
    data = np.loadtxt("E:\\Python\\Lab4\\Lab4.dat")#读取dat数据
    x_data = data[:,0]#横坐标
    y_data = data[:,1]#纵坐标
    return data,x_data,y_data

def init(k):#初始化生成k个随机类别中心
    data,x_data,y_data = readdata()
    class_center = []
    for i in range(k):
        #在数据的最大值与最小值间给出随机值
        x = np.random.randint(np.min(x_data),np.max(x_data))
        y = np.random.randint(np.min(y_data),np.max(y_data))
        class_center.append(np.array([x,y]))#以数组方式添加,方便后面计算距离
    return class_center

def dist(a,b):#计算两个坐标间的欧氏距离
    dist = math.sqrt(math.pow((a[0] - b[0]),2) + math.pow((a[1] - b[1]),2))
    return dist

def dist_rank(center,data):#得到与类中心最小距离的类别位置索引
    tem = []
    for m in range(k):
        d = dist(data, center[m])
        tem.append(d)
    loc = tem.index(min(tem))
    return loc

def means(arr):#计算类的平均值当作类的新中心
    sum_x,sum_y =0,0
    for n in arr:
        sum_x += n[0]
        sum_y += n[1]
    mean_x = sum_x / len(arr)
    mean_y = sum_y / len(arr)
    return [mean_x,mean_y]

def divide(center,data):#将每一个二维坐标分到与之欧式距离最近的类里
    cla_arr = [[]]
    for i in range(k-1):#创建与k值相同维度的空数组存取坐标
        cla_arr.append([])
    for j in range(len(data)):
        loc = dist_rank(center,data[j])
        cla_arr[loc].append(list(data[j]))
    return cla_arr

def new_center(cla):#计算每类平均值更新类中心
    new_cen = []
    for g in range(k):
        new = means(cla[g])
        new_cen.append(new)
    return new_cen

def index_element(arr,data,sw):#索引第sw个元素对应的类别
    index = []
    for i in range(len(data)):#遍历每一个数据
        for j in range(k):#遍历每一个类别
            tem = arr[j]
            for d in range(len(tem)):#遍历类别内的每一个数据
                if data[i][0] == tem[d][0] and data[i][1] == tem[d][1]:#如果横纵坐标数值都相等
                    index.append((j + 1))#归为j+1类
                else:
                    continue
    return index[sw]

def Kmeans(n,sw):#获取n次更新后类别中心以及第sw个元素对应的类别
    data, x_data, y_data = readdata()#读取数据
    center = init(k)  # 获取初始类别中心
    while n > 0:
        cla_arr = divide(center,data)# 将数据分到随机选取的类中心的里
        center = new_center(cla_arr)#更新类别中心
        n -= 1
    sse1 = 0
    for j in range(k):
        for i in range(len(cla_arr[j])):  # 计算每个类里的误差平方
            # 计算每个类里每个元素与元素中心的误差平方
            dist1 = math.pow(dist(cla_arr[j][i], center[j]), 2)
            sse1 += dist1
    sse1 = sse1 / len(data)
    index = index_element(cla_arr,data,sw)
    return center,index,sse1,cla_arr
center_l, index,sse1, cla_arr = Kmeans(n,sw)
print("类别中心为:",center_l)
print("所查元素属于类别:",index)
print('k值为{0}时的误差平方和为{1}'.format(k,sse1))#format格式化占位输出误差平方和

def visualization(cla):#聚类可视化展现
    cla_x = [[]]
    cla_y = [[]]
    for m in range(k-1):#创建与k值相同维度的空数组存取x坐标和y坐标
        cla_x.append([])
        cla_y.append([])
    for i in range(k):#遍历k次读取k个类别
        for j in cla[i]:#遍历每一类存取横纵坐标
            cla_x[i].append(j[0])
            cla_y[i].append(j[1])
    plt.rcParams['axes.unicode_minus'] = False
    plt.rcParams['font.sans-serif']=['SimHei']#解决中文不能显示的问题
    plt.figure()
    plt.xlabel("x")
    plt.ylabel("y")
    plt.title("聚类图")
    plt.scatter(cla_x[0],cla_y[0],c = 'r',marker = 'h')
    plt.scatter(cla_x[1], cla_y[1], c='y', marker='.')
    plt.scatter(cla_x[2], cla_y[2], c='g', marker='o')
    plt.scatter(cla_x[3], cla_y[3], c='b', marker=',')
    plt.scatter(cla_x[4], cla_y[4], c='k', marker='p')
    plt.show()

visualization(cla_arr)

def hand():#画出手肘图
    #sse列表是循环次数为3,改变k从2到8一个一个人工测得存入
    sse = [17.840272113687078,12.116153021227769,8.563862232332205,4.092534331364449,3.573312882789776,3.42794767600246,3.2880646083752185]
    x = np.linspace(2,8,7)#创建等间距大小为7的数组
    plt.xlabel("k值")#横坐标名称
    plt.ylabel("误差平方和")#纵坐标名称
    plt.title("手肘图")#曲线名
    plt.plot(x,sse)#画出曲线
    plt.show()
hand()
2. 代码运行结果展示
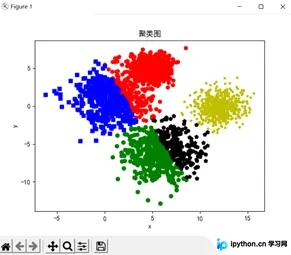
聚类结果可视化图
手肘法确定K值图
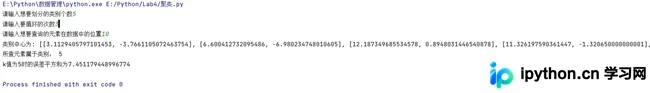
具体运行输出结果
文章参考来源
手肘法:K-means聚类最优k值的选取_qq_15738501的博客-CSDN博客_kmeans聚类k的选取
matplotlib.pyplot.scatter散点图的绘制方法
Python——plt.scatter各参数详解_yuanCruise-CSDN博客_plt.scatter
至此,关于Python使用Numpy实现K-Means算法的介绍已完成。如需了解更多Python K-Means算法相关内容,请搜索本站历史文章或继续浏览后续相关文章。希望大家今后多多支持本站!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









