Ubuntu 下 Node.js 日志如何实现自动化备份
在 Ubuntu 上给 Node.js 做日志自动化备份,常见方案主要有四类:系统自带的 logrotate、自定义 Shell 脚本配合 cron、PM2 的 pm2-logrotate,以及 rsync 异地同步。它们分别适合本机轮转、定制归档、PM2 托管应用和远程容灾,关键差异在于维护成本、灵活度与备份范围。
2026-08-24
46

在 Ubuntu 上给 Node.js 做日志自动化备份,常见方案主要有四类:系统自带的 logrotate、自定义 Shell 脚本配合 cron、PM2 的 pm2-logrotate,以及 rsync 异地同步。它们分别适合本机轮转、定制归档、PM2 托管应用和远程容灾,关键差异在于维护成本、灵活度与备份范围。
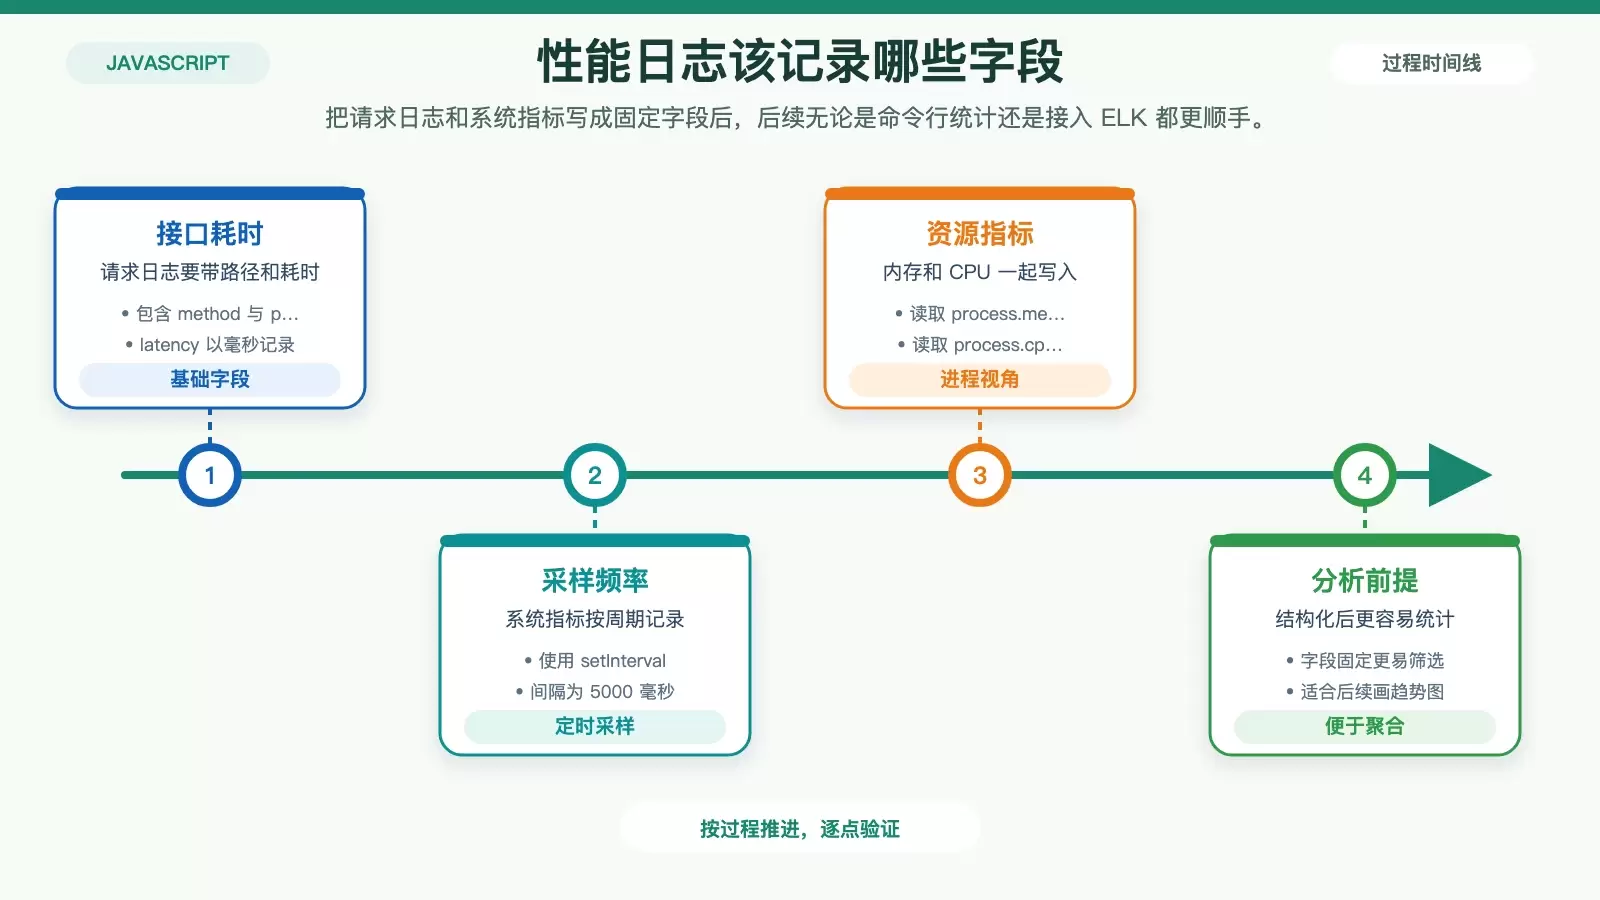
在 Ubuntu 上分析 Node.js 性能,关键不只是“把日志记下来”,而是让日志具备可检索、可统计、可追踪的能力。本文从结构化日志、核心指标埋点、命令行筛查,到 ELK、PM2、Logrotate 和 APM 的组合方式,梳理一套适合日常排障与持续监控的做法。
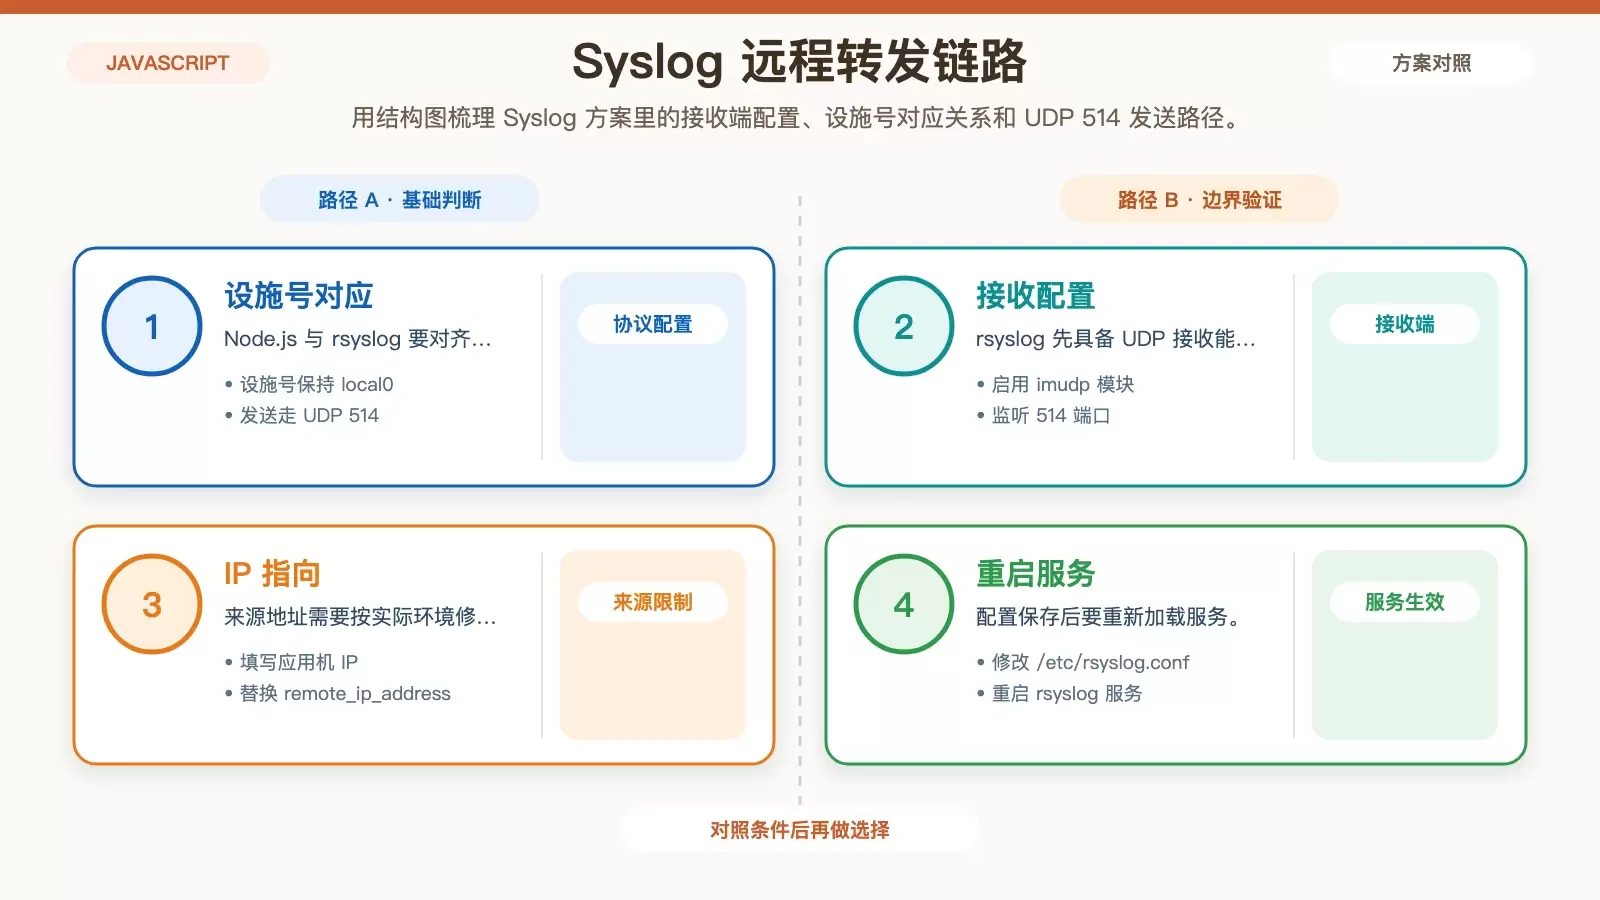
在 Ubuntu 上给 Node.js 应用做远程日志监控,常见做法主要是 Syslog 转发和 Fluentd 收集。前者依赖少、配置直接,后者更适合结构化处理和多目标转发。本文按接收端与发送端拆解步骤,并给出两种方案的适用判断。
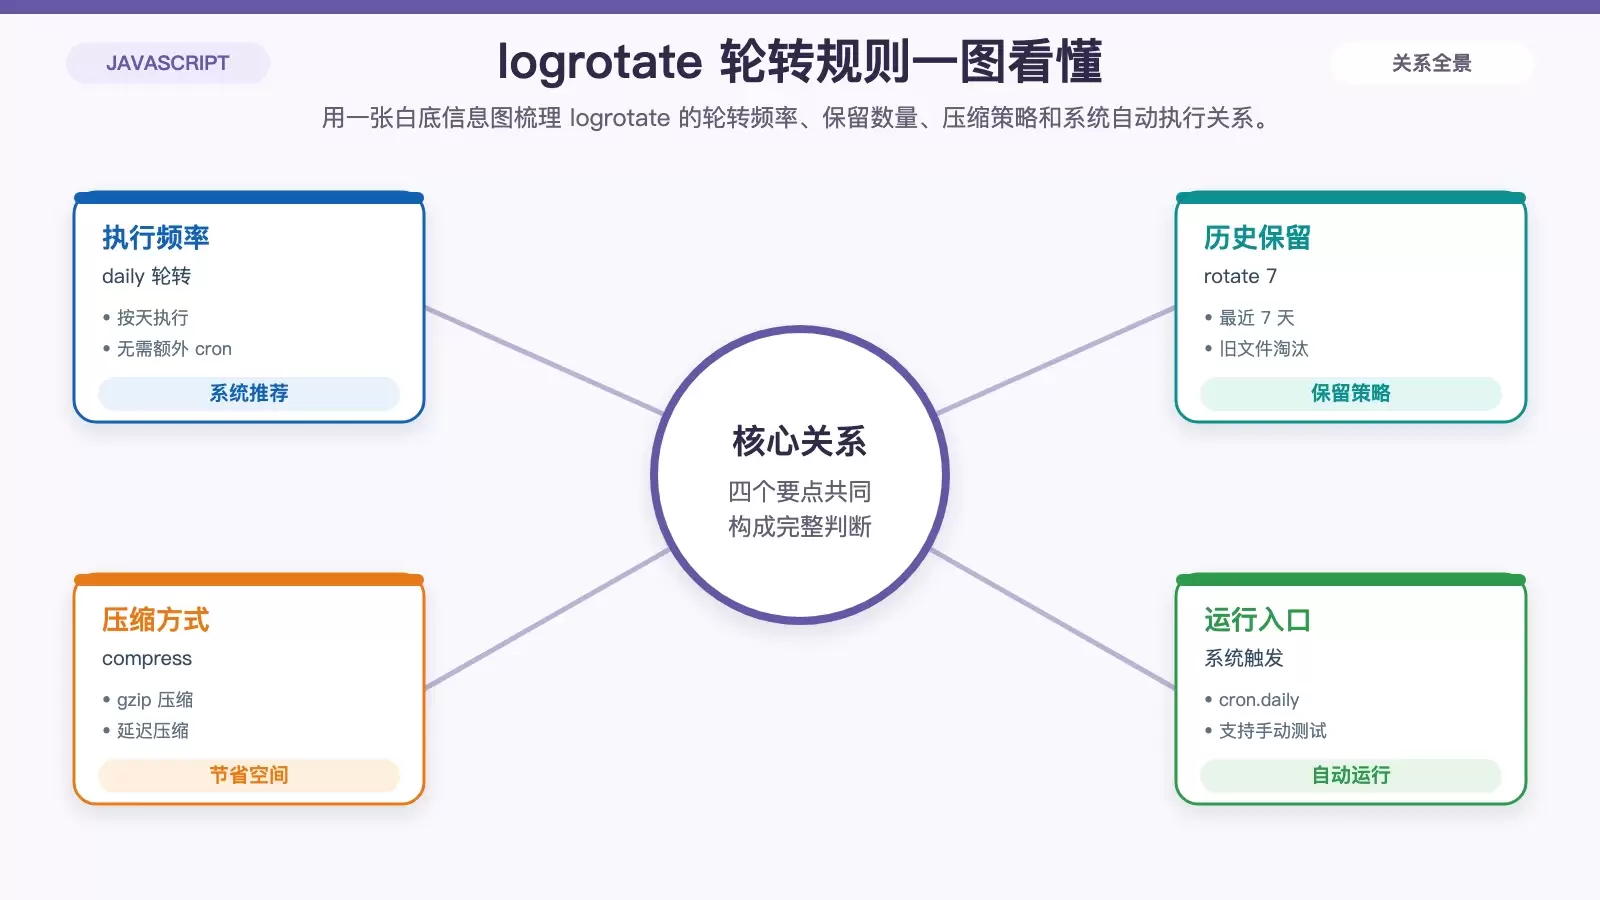
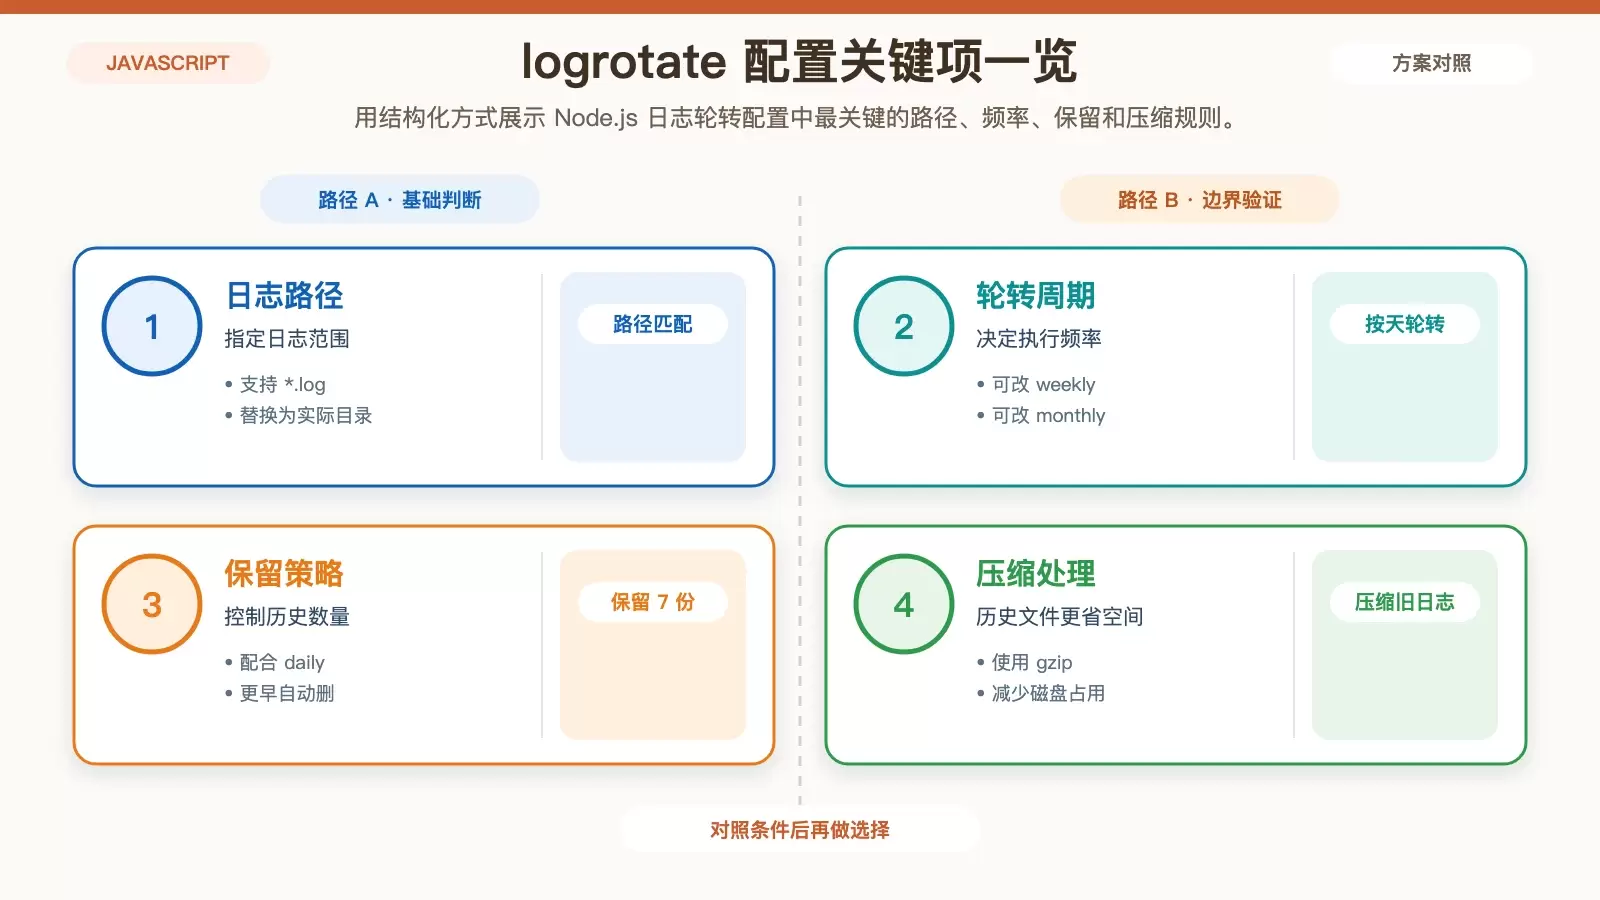
在 Ubuntu 上运行 Node.js 服务时,日志若持续增长,很容易挤占磁盘空间。本文用系统自带的 logrotate 为例,说明如何安装工具、为单个应用编写轮转规则,并通过手动触发验证配置是否真正可用。 Node.js 服务在 Ubuntu 上持续运行后,日志文件往往会先于业务本身失控,磁盘被写满时排查起来也最麻烦。
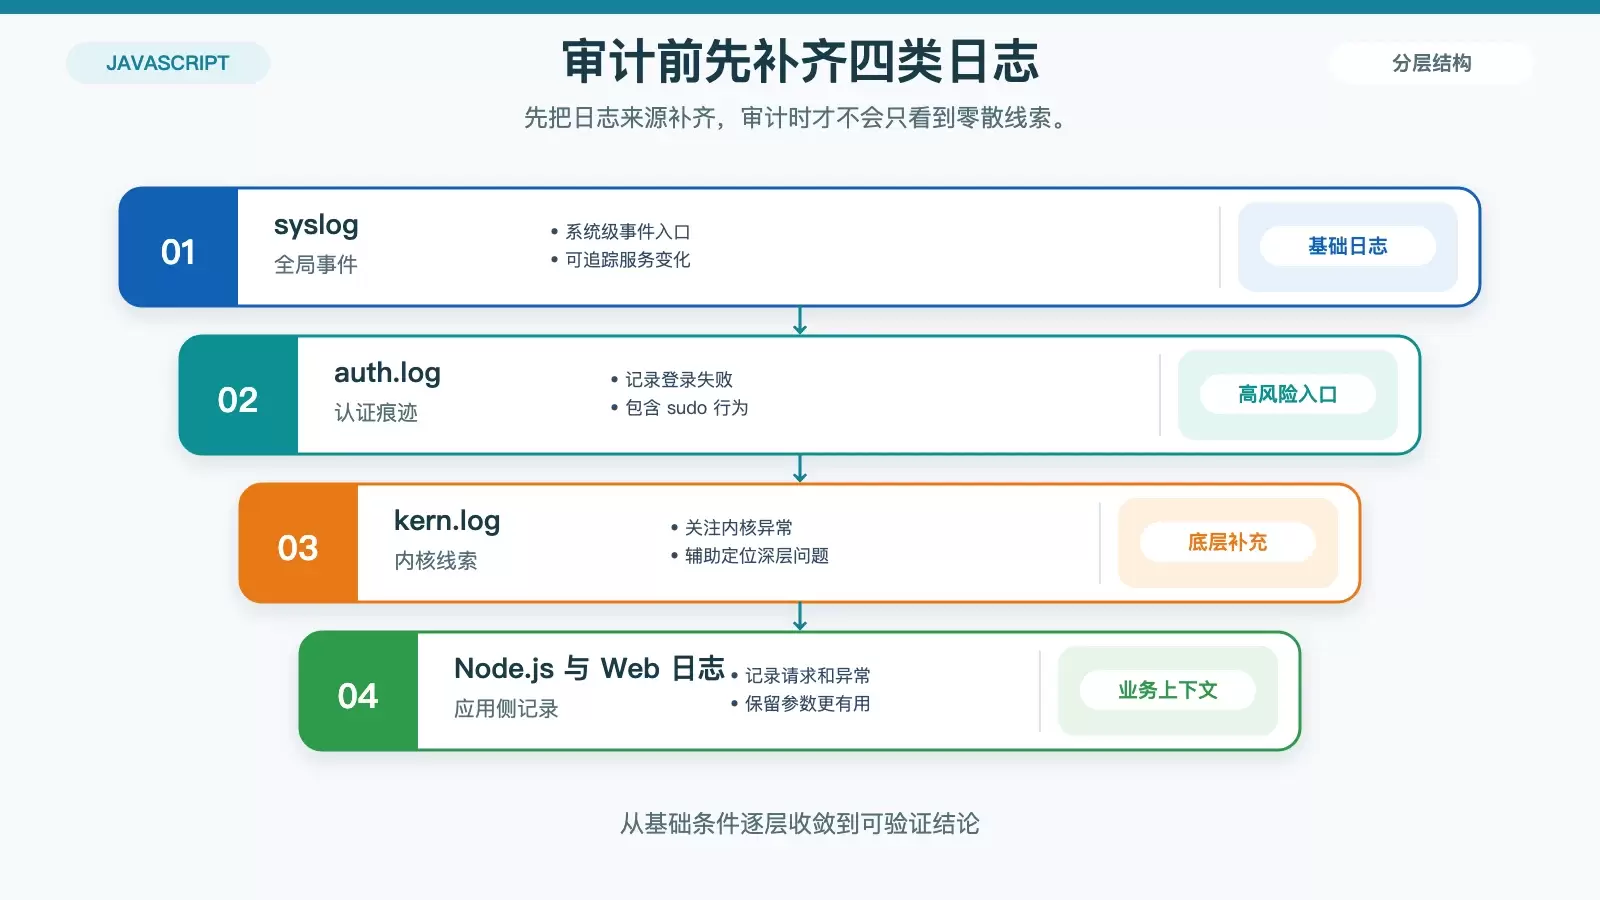
在 Ubuntu 上做 JavaScript 安全审计,日志往往比单次扫描更能还原真实攻击路径。本文按“先补齐日志、再做筛查、接入监控、形成审计闭环”的顺序,整理出一套适合 Node.js 与常见 Web 服务的实操思路,并保留可直接上手的命令示例。
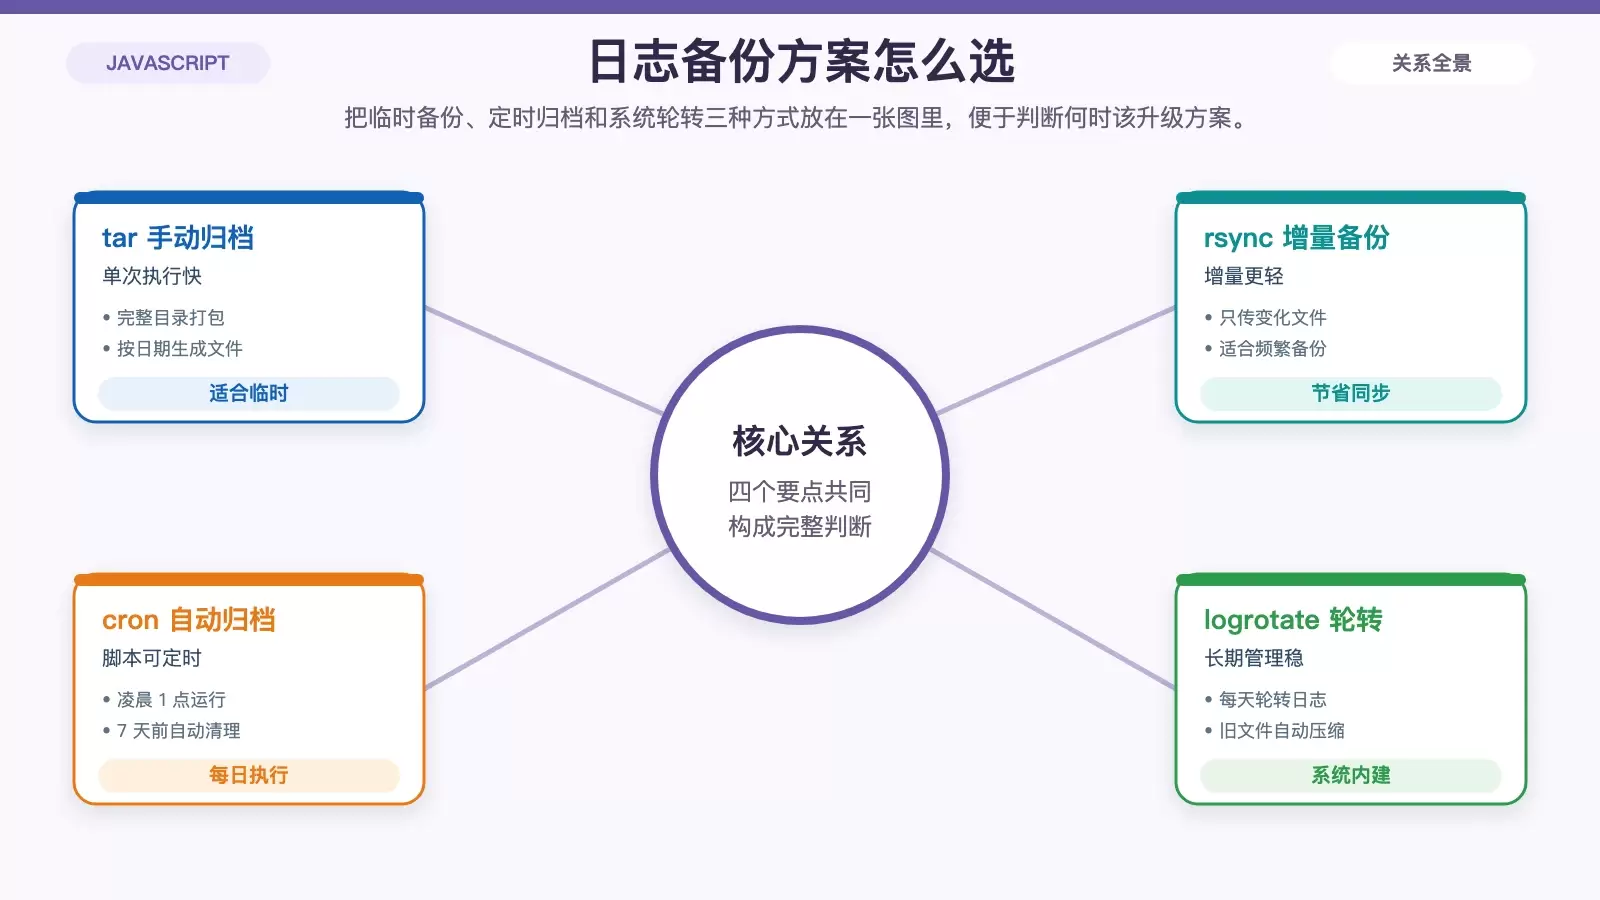
在 Ubuntu 上维护 JavaScript 应用时,日志备份不能只靠临时打包,恢复也不能等出事后再摸索。本文按手动备份、定时备份、logrotate 轮转和常见恢复场景梳理一套可落地方案,保留关键命令、配置和判断要点,方便直接套用。
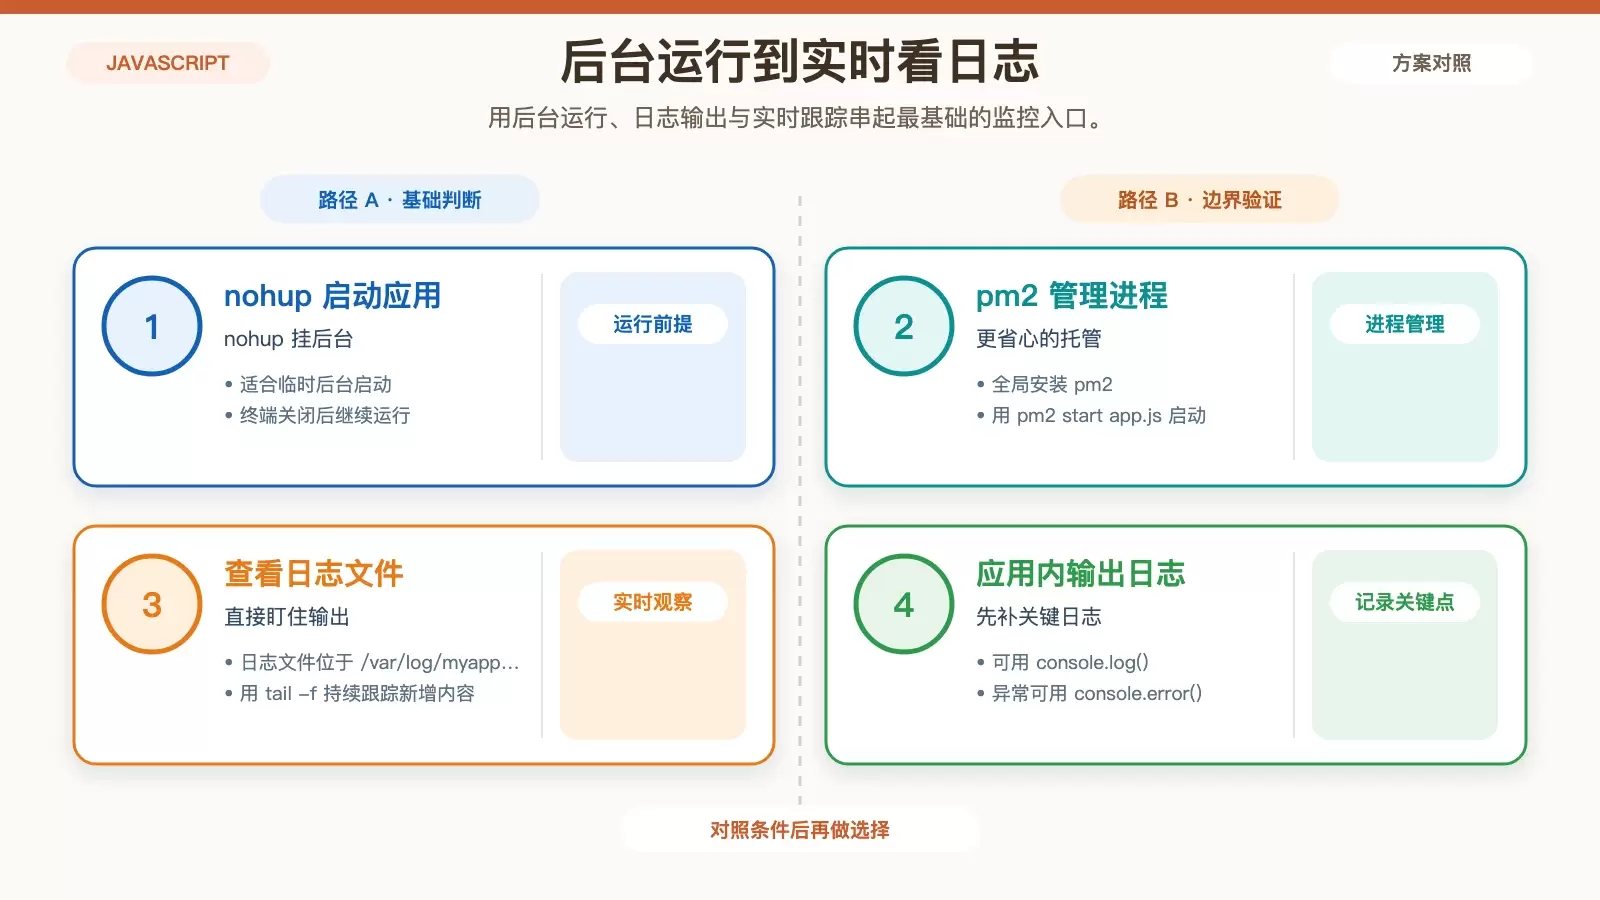
在 Ubuntu 上观察 JavaScript 应用运行状态,最实用的入口仍然是日志。文章按“先保证进程稳定运行,再建立日志查看、轮转与告警”这条线梳理常见做法,并补上系统资源监控这一层,帮助你判断应用异常究竟来自代码、进程退出,还是 CPU、内存、磁盘压力。
面对 Node.js 应用里层层叠叠的日志输出,关键不是逐字硬读,而是先建立一套筛选顺序。本文把原本分散的九个处理动作整理成一条可执行路径,帮助你从日志级别、来源、堆栈到上下文与工具选择,逐步判断问题位置并进入调试验证。
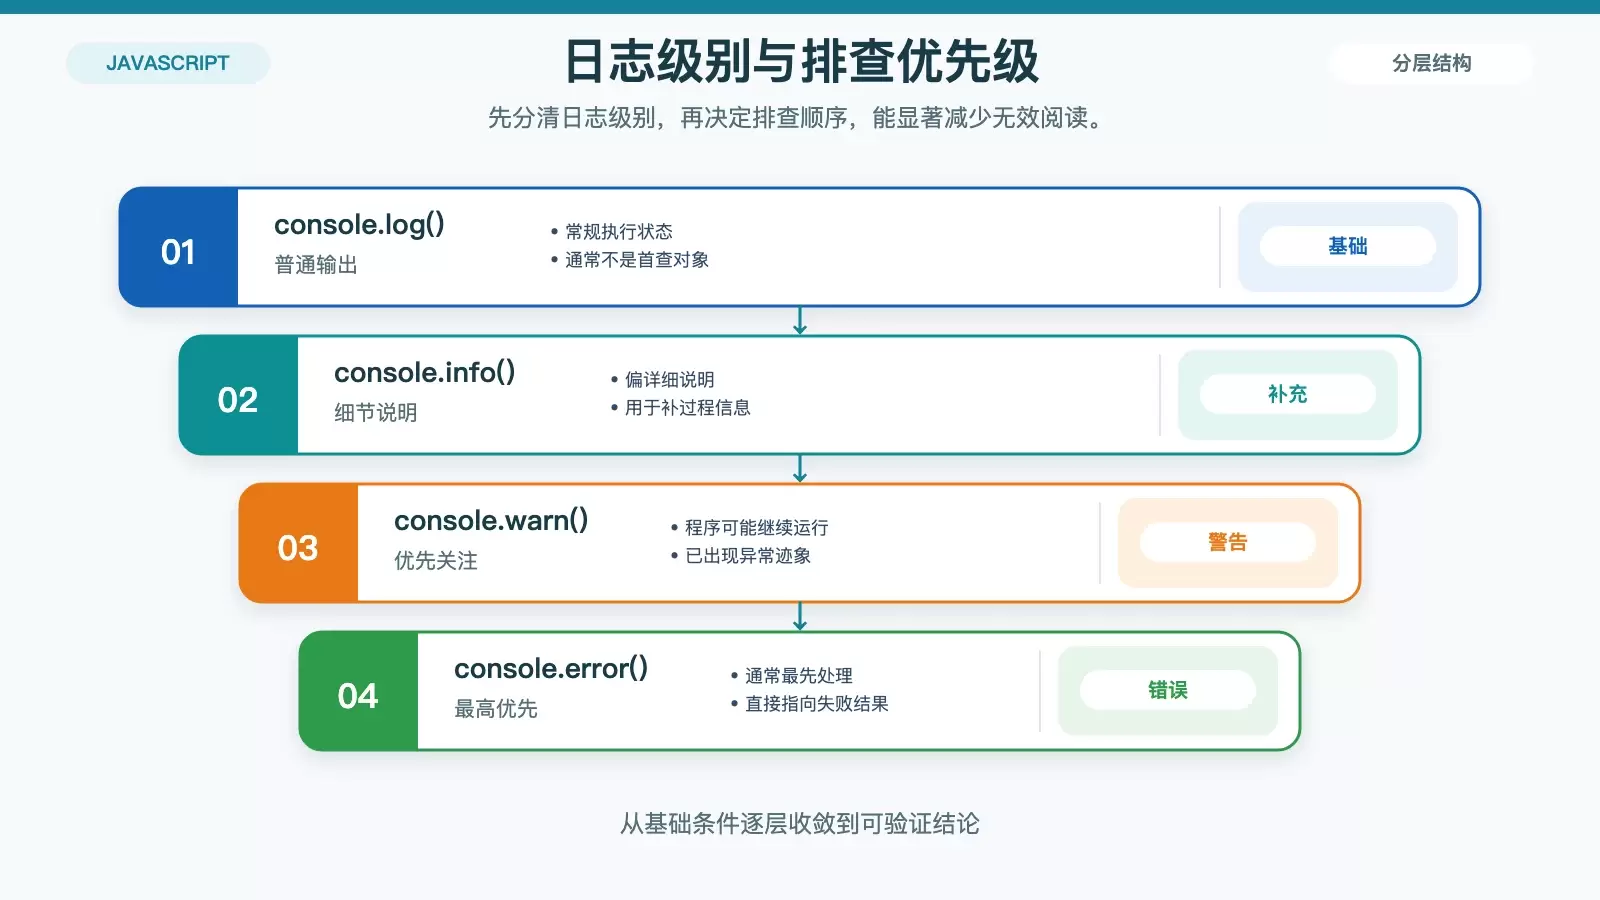
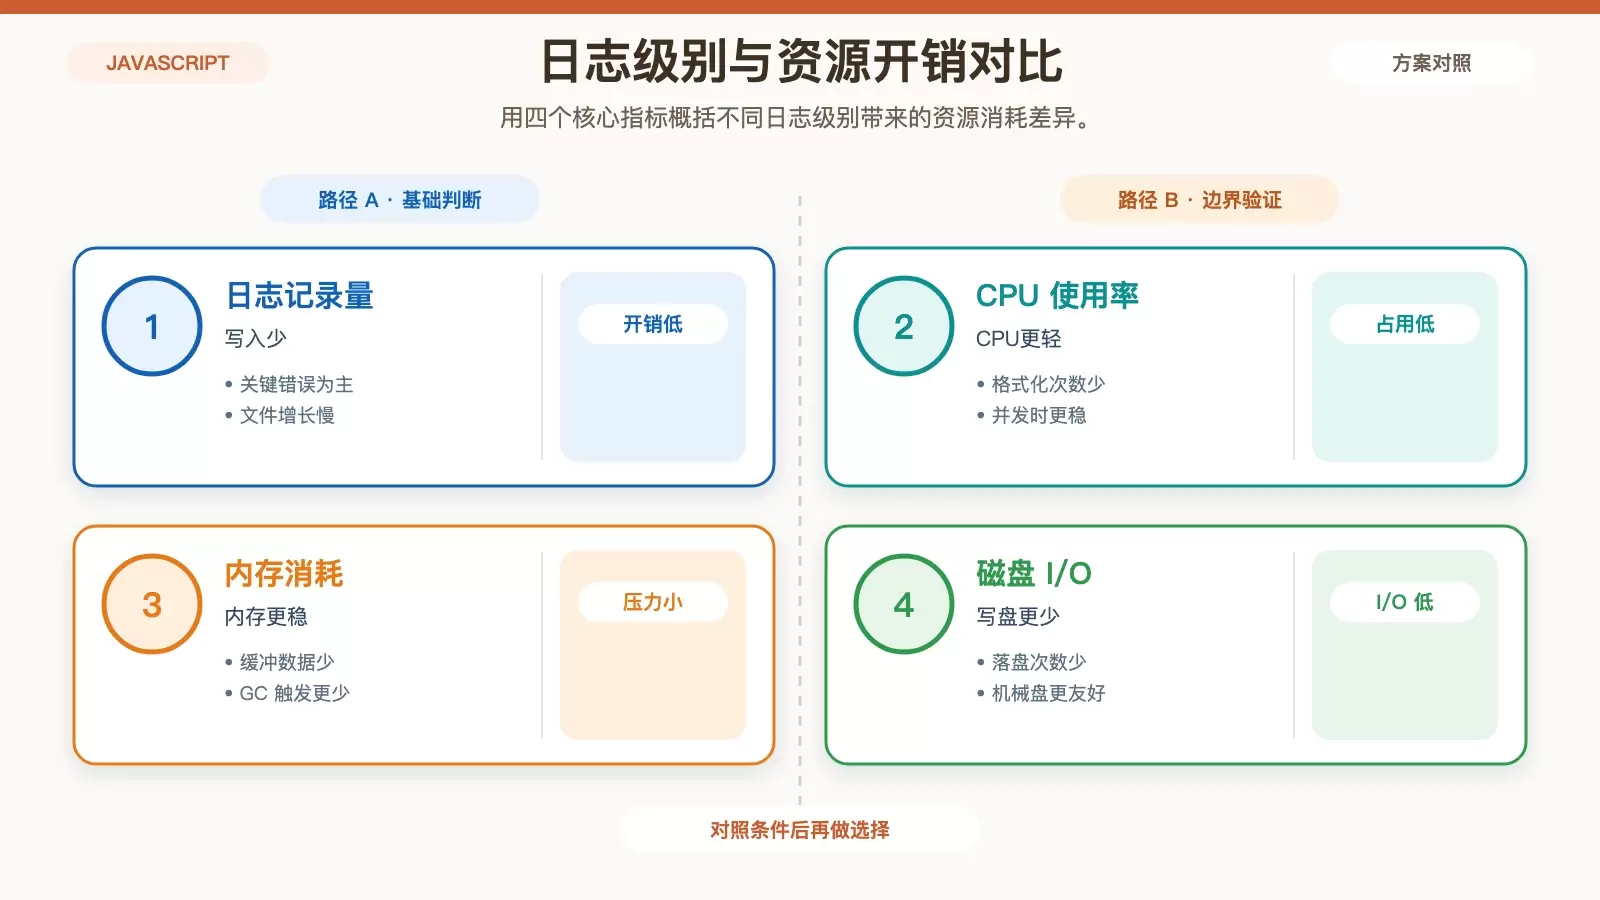
在 Ubuntu 上运行 JavaScript 应用时,日志级别会直接影响磁盘写入、CPU 占用、内存压力和接口响应时间。日志越细,排障信息越全,但系统为格式化、缓冲和落盘付出的代价也越高,生产环境需要根据场景控制级别。
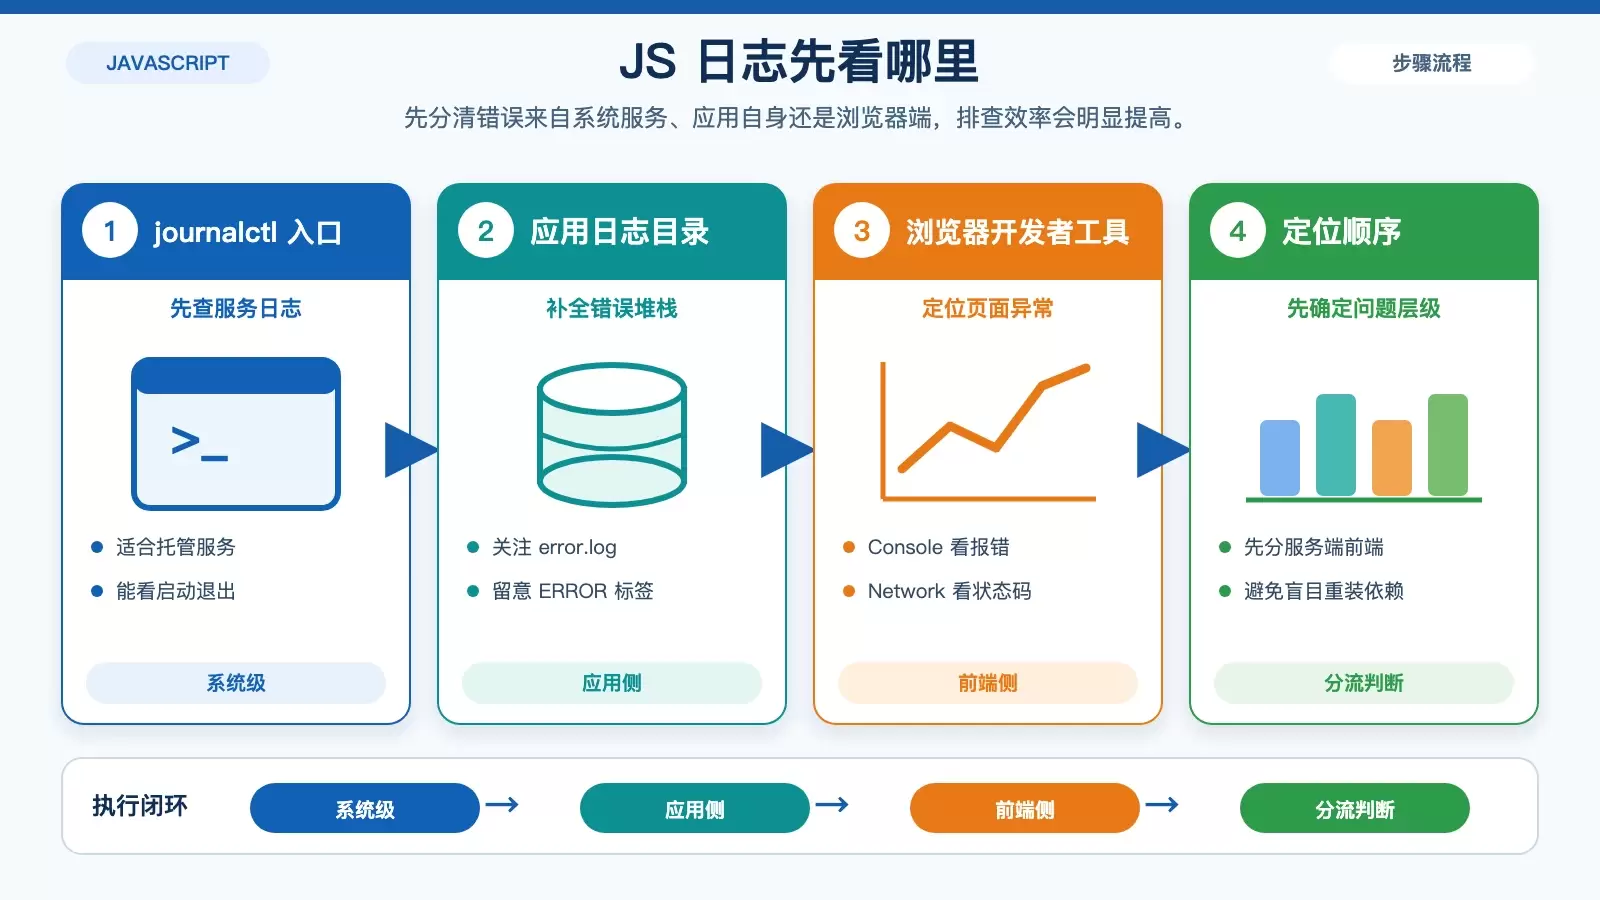
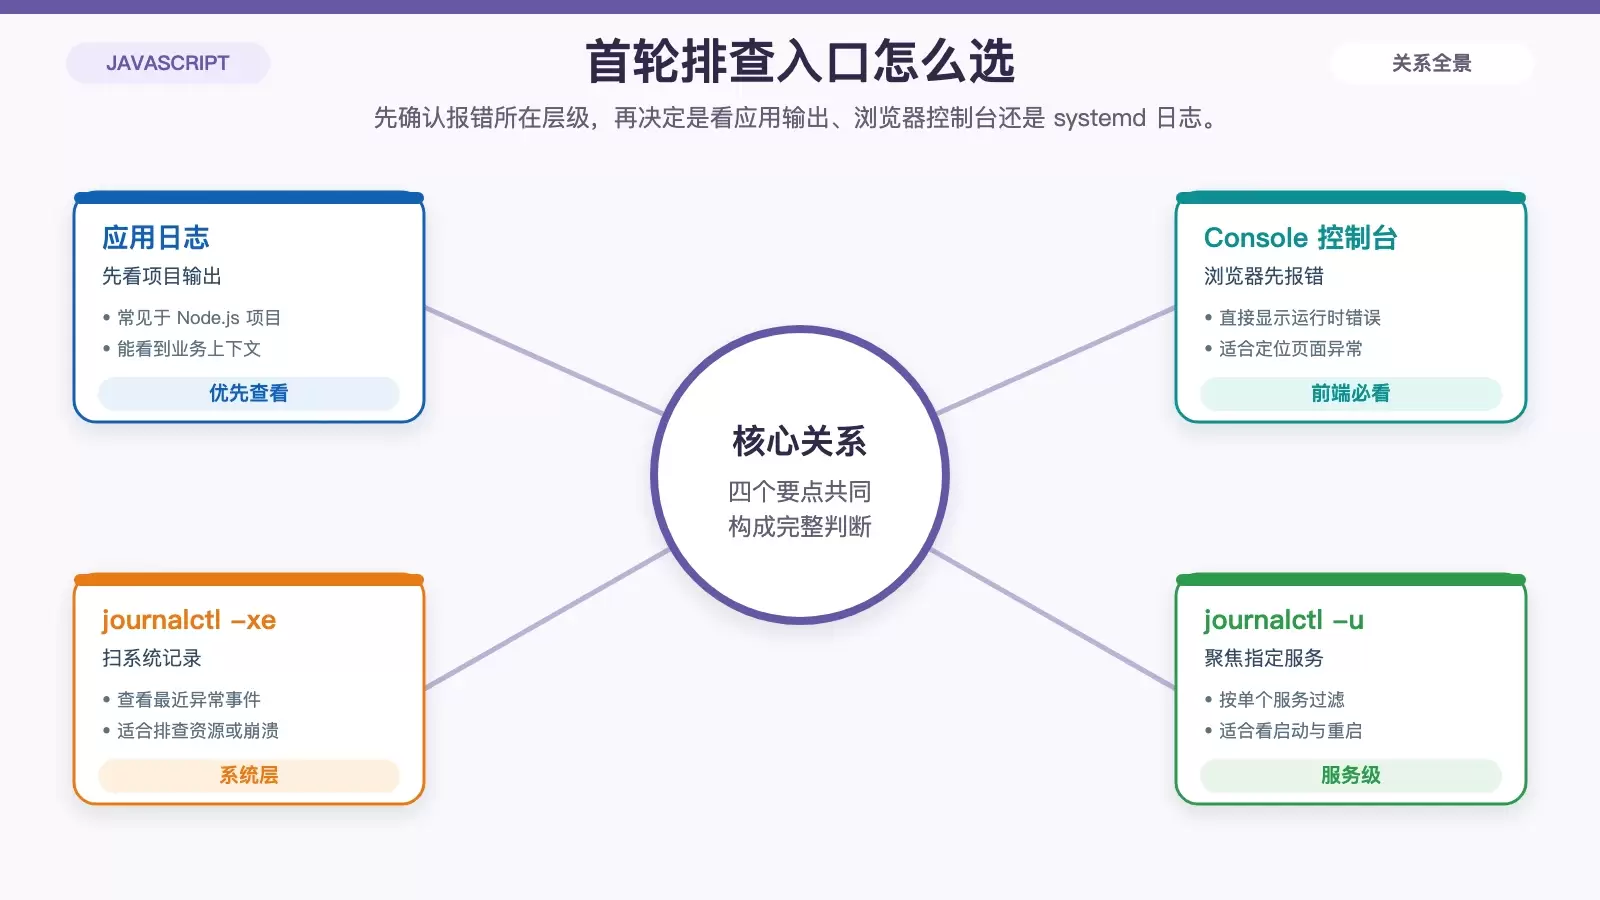
在 Ubuntu 上排查 JavaScript 问题,关键不是盲目翻日志,而是先分清错误发生在哪一层:应用本身、浏览器、systemd 服务、Web 服务器还是运行环境。本文按实际排障顺序整理常用入口、命令和判断方法,帮助你更快缩小范围。
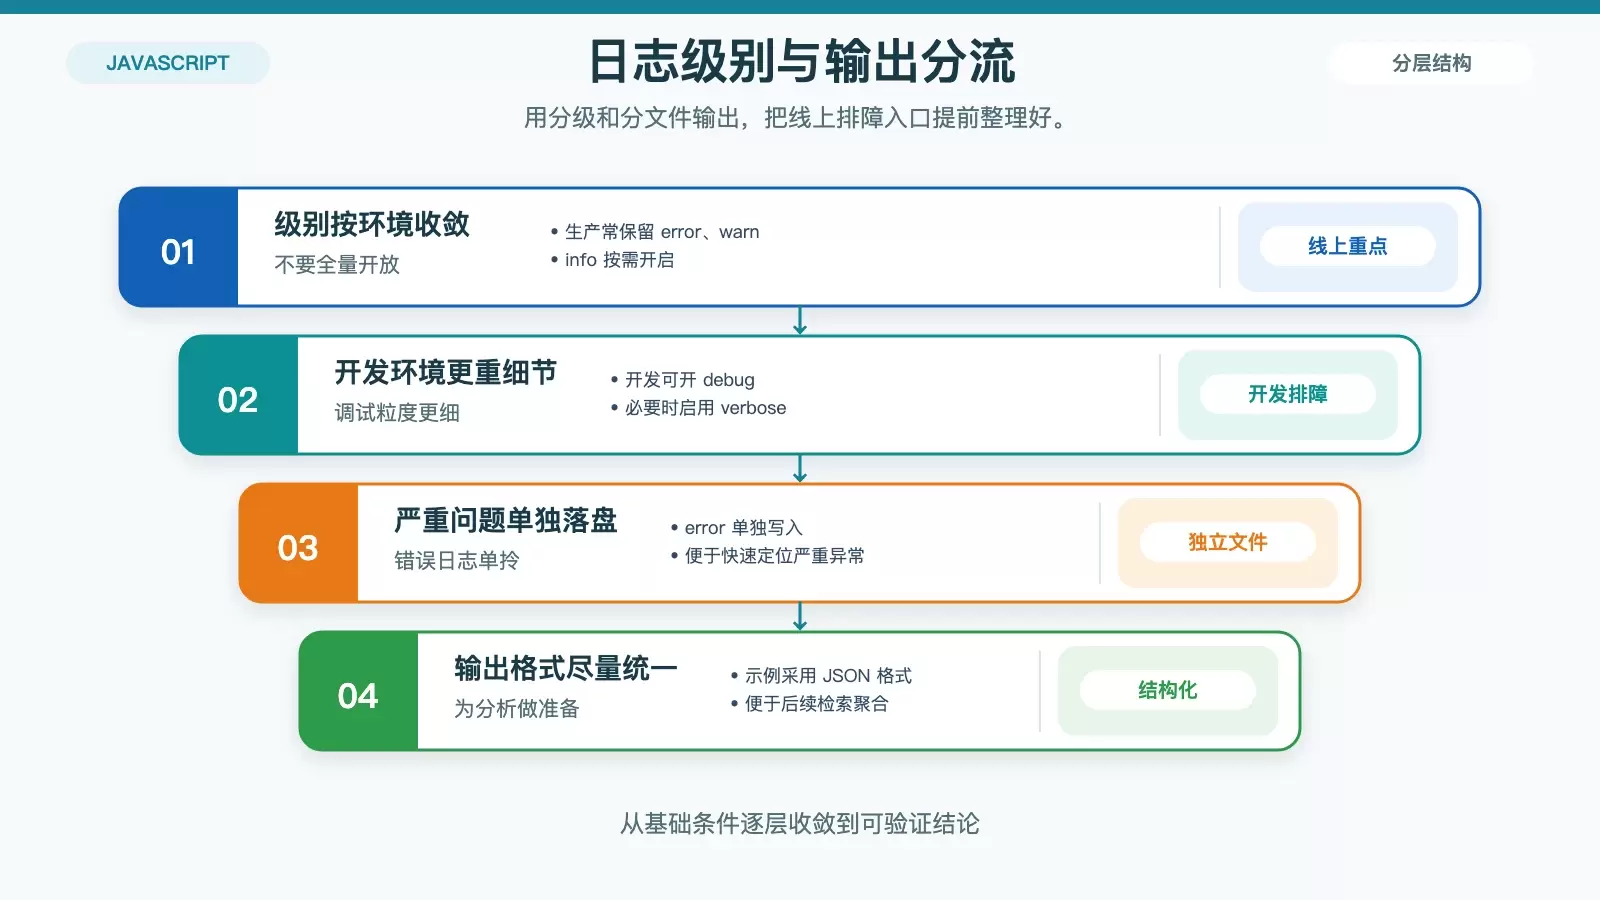
在 Ubuntu 上为 Node.js 应用设计日志策略,关键不在“有没有日志”,而在是否能兼顾性能、排障效率、磁盘占用与安全性。本文从日志库选择、级别配置、轮转分割,到监控分析和权限控制,整理出一套更适合生产环境落地的做法。
Ubuntu 下的 JavaScript 日志异常,大多可以归到权限、端口、依赖、语法、引用、类型和内存几类问题。文章按“先定位、再分类修复、最后用工具补强”的顺序,整理出一套更适合 Node.js 服务和前端项目的排查路径。