


在 Ubuntu 上排查 JavaScript 应用是否正常运行,最省力的办法通常不是先看代码,而是先把日志和进程状态理顺。下面按实际运维顺序,把后台运行、日志跟踪、资源观察和异常告警几件事串起来,方便你快速搭一套能落地的监控思路。
先让应用稳定跑在后台
要监控运行状态,前提是应用本身已经能持续运行,而不是一关终端就退出。对于 Node.js 应用,最常见的做法是直接用 nohup,或者交给进程管理器 pm2。
如果只是临时让程序挂到后台,可以这样启动:
nohup node app.js &这种方式足够简单,但更适合轻量场景。要是希望进程管理、重启和状态查看更省心,通常还是会用 pm2:
npm install pm2 -g
pm2 start app.js
这一步的意义很直接:先确保应用能稳定存在于系统里,后面的日志、资源和告警监控才有持续观察对象。
用日志持续跟踪应用状态
应用跑起来以后,日志就是判断运行是否正常的第一现场。如果项目已经把运行信息写入日志文件,最直接的办法就是实时跟踪它。
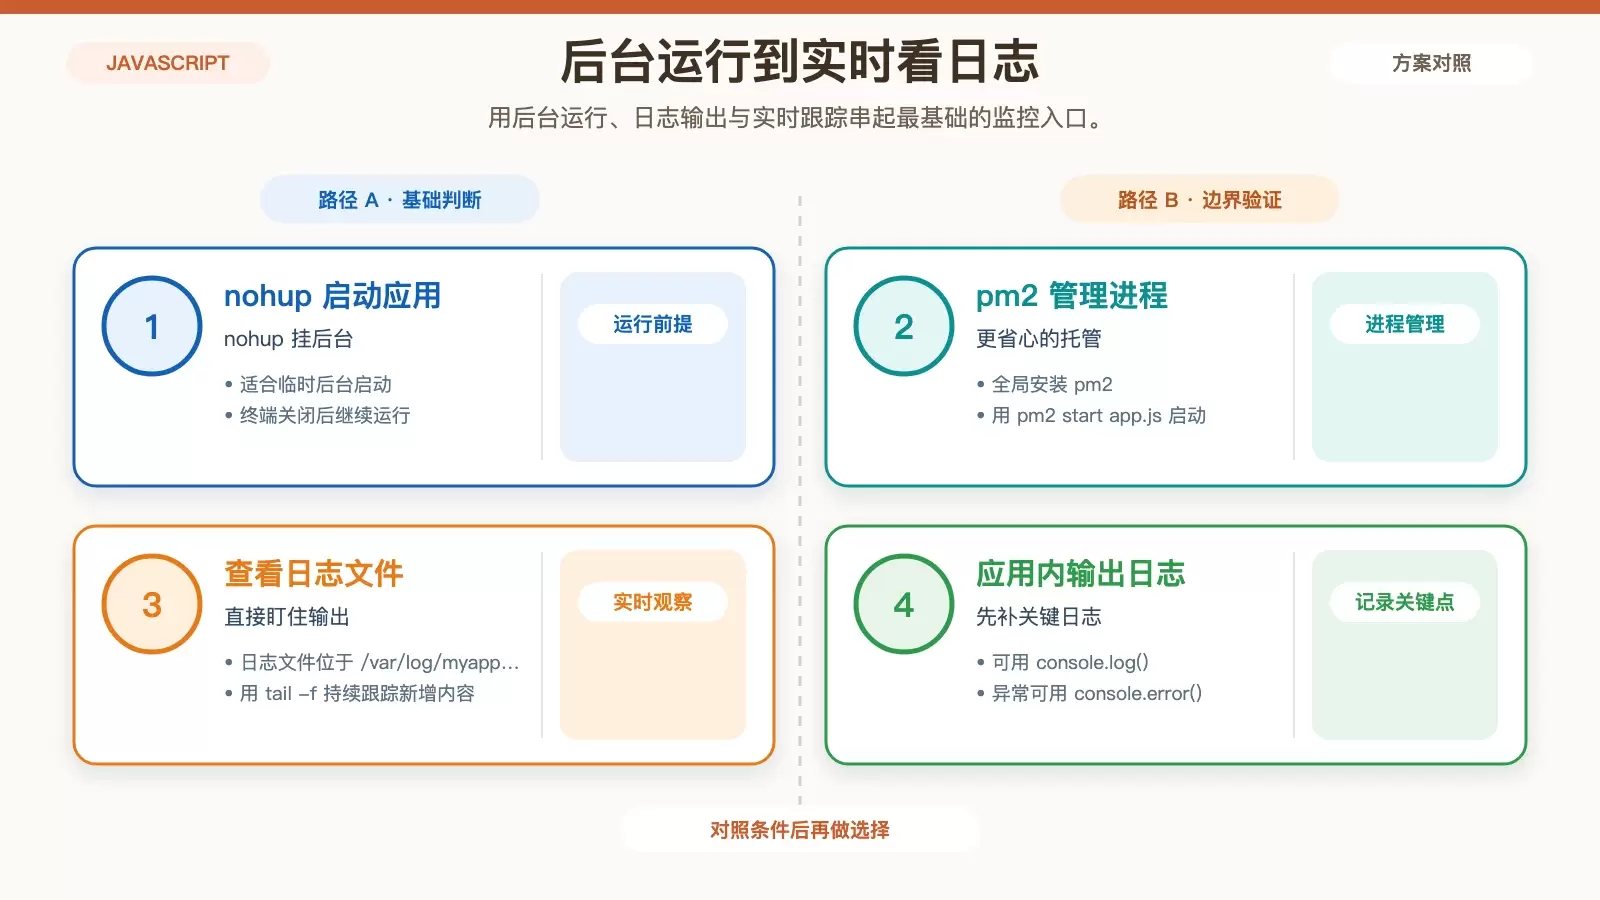
比如日志文件位于 /var/log/myapp.log,可以用下面的命令持续查看新增内容:
tail -f /var/log/myapp.log这种方式适合观察启动报错、接口异常、连接失败等即时问题。只要日志里有足够的信息,很多故障都能在第一时间被发现。
如果现有应用还没有像样的日志输出,就需要先把关键事件记下来。对 Node.js 来说,入门阶段直接使用 console.log() 和 console.error() 就够用了,至少要把启动成功、请求异常、外部依赖失败这类信息打出来。没有日志,监控基本无从谈起;日志过少,排查时也很难判断问题发生在哪一层。
日志变多后,补上轮转和集中分析
日志能帮你定位问题,但日志文件本身也会带来新的管理压力。随着运行时间拉长,日志只会越积越多,如果不处理,磁盘占用会越来越明显,查找效率也会下降。
在 Ubuntu 上,logrotate 是处理这类问题的常见工具。它可以帮你自动完成日志轮转、压缩和旧文件清理,让日志既保留下来,又不至于无限膨胀。
如果项目规模继续扩大,只靠在服务器上手动翻文件就不太够用了。这时候可以考虑把日志接入集中式平台,例如 ELK Stack(Elasticsearch、Logstash、Kibana)或者 Graylog。这类方案的价值不只是“集中保存”,更重要的是能提供搜索、分析和可视化能力,方便从大量日志里快速筛出异常模式。
别只盯应用日志,还要看系统资源和告警
只看应用层日志,往往还不够完整。很多 JavaScript 应用的问题,表面看像代码异常,实际根因可能是系统资源已经接近极限。
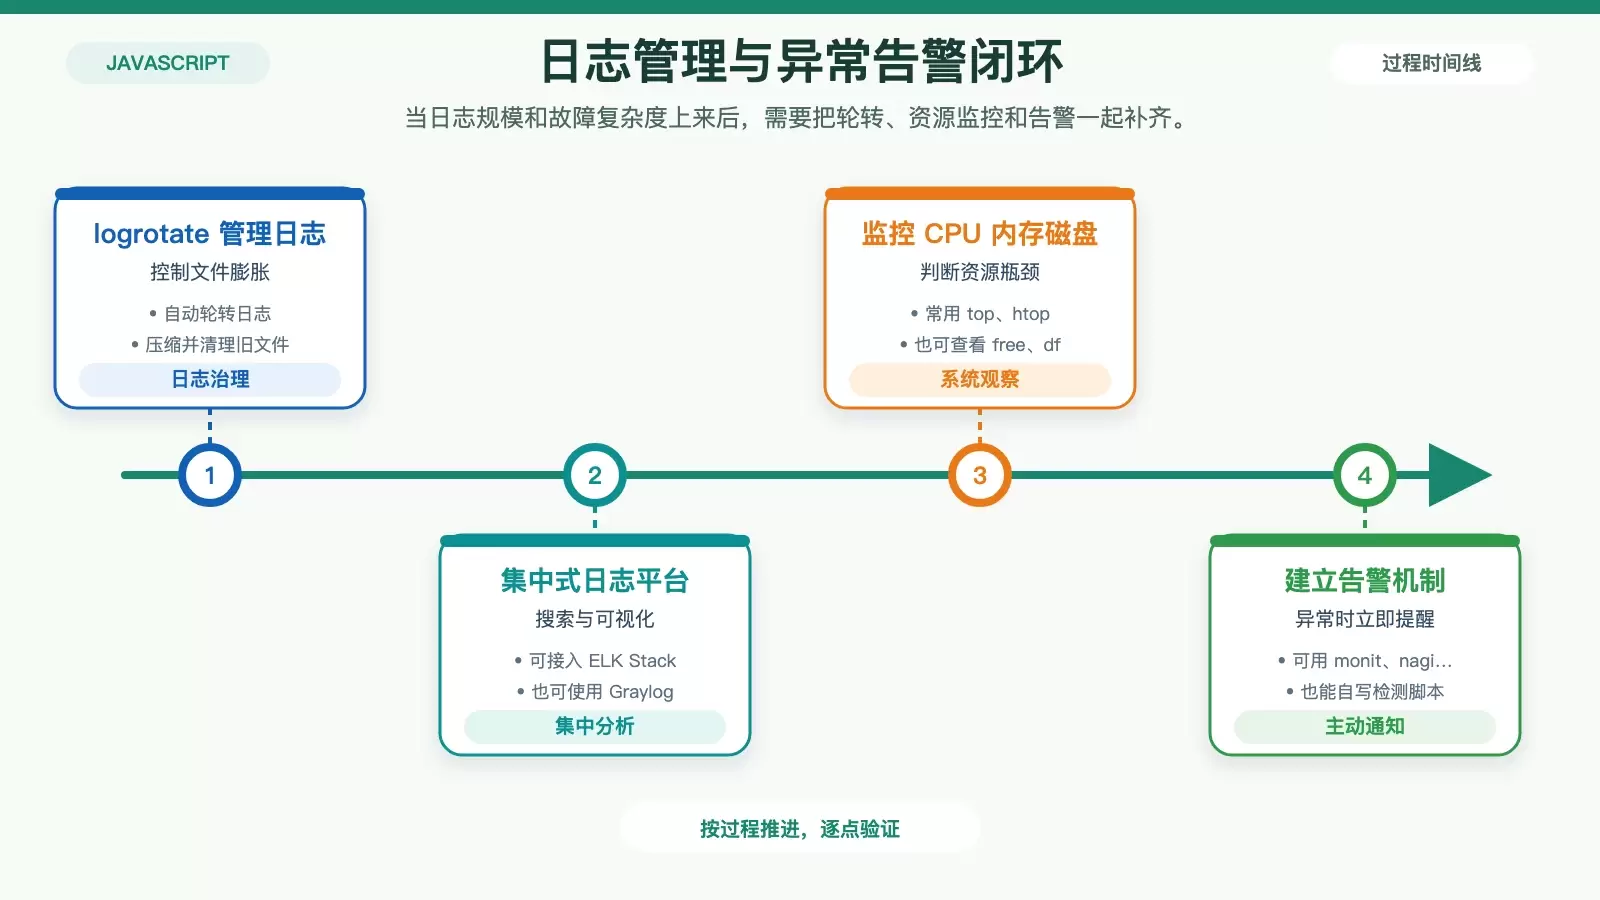
在 Ubuntu 上,CPU、内存和磁盘状态都值得一起观察。常用命令包括 top、htop、free、df,用来快速判断当前负载、可用内存和磁盘空间是否异常。这一步能帮助你区分:到底是应用本身报错,还是服务器环境已经扛不住。
再往前走一步,就是把“人盯日志”改成“系统主动通知”。可以使用 monit、nagios 这类监控工具,也可以自己写脚本做简单检测。只要发现异常退出、资源占用过高或日志里出现特定错误,就及时发邮件或消息通知,处理速度会比手动巡检快得多。
把这几层组合起来,监控思路就比较完整了:先保证 JavaScript 应用稳定运行,再通过日志掌握应用行为,用轮转和集中平台管理日志量,最后结合系统资源和告警机制补齐判断依据。这样在 Ubuntu 上看应用状态,基本就不再只是“出问题再去翻记录”,而是能更早发现异常并定位方向。









