Python单行刷新输出与tqdm进度条实现详解
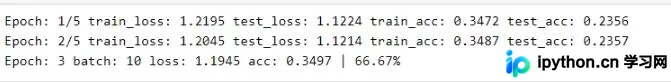
本文详细解析Python中print函数的刷新机制,通过\r和end参数实现单行结果动态更新,解决位数变化导致的显示错乱问题。同时介绍tqdm库的安装与基础用法,展示如何在列表遍历和字符串处理中添加可视化进度条,适用于机器学习训练过程中的Loss和Accuracy实时监控场景。
2026-10-14
6

本文详细解析Python中print函数的刷新机制,通过\r和end参数实现单行结果动态更新,解决位数变化导致的显示错乱问题。同时介绍tqdm库的安装与基础用法,展示如何在列表遍历和字符串处理中添加可视化进度条,适用于机器学习训练过程中的Loss和Accuracy实时监控场景。
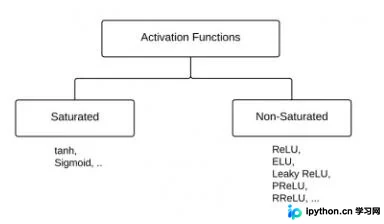
本文详细介绍在TensorFlow中高效实现LeakyReLU的方法,通过替换abs()为tf.abs()优化代码。同时深入解析ReLU、Leaky ReLU、PReLU和RReLU四种激活函数的原理、公式及适用场景,对比它们在解决梯度消失和加速收敛方面的差异,为模型训练提供理论支持与实践参考。
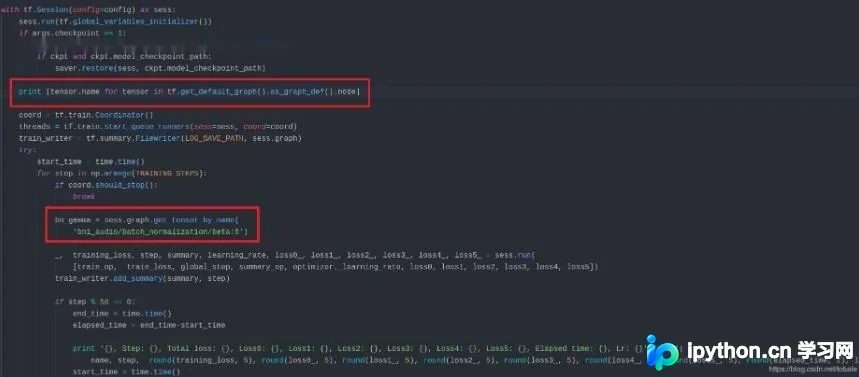
本文介绍在TensorFlow训练过程中获取指定Tensor值的方法,包括通过图节点名称提取参数。针对Conv1和BN1层出现NAN导致后续层输出为0且无法更新的问题,分析数据中NAN的影响,并提供获取Tensor名称及值的代码示例,帮助开发者排查模型训练异常。
在Keras与TensorFlow混编场景下,直接设置模型层的trainable=False属性往往无法阻止优化器更新权重。本文通过引入tf.variable_scope区分变量作用域,利用tf.get_collection筛选特定作用域内的可训练变量,并在优化器中通过var_list指定更新范围,从而有效解决该兼容性问题。
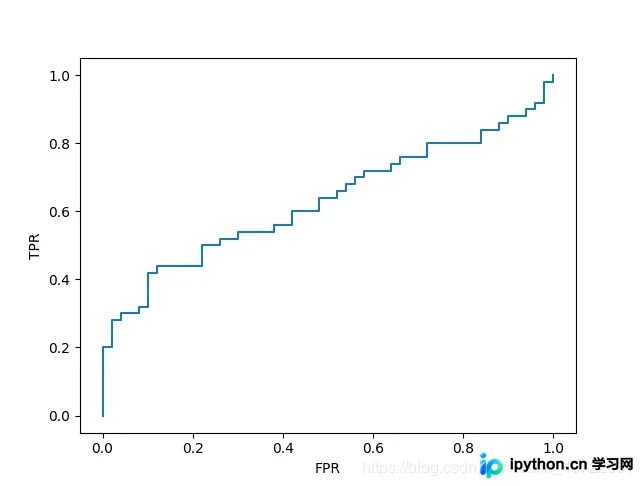
本文详细解析如何使用Python绘制ROC曲线。以鸢尾花数据集为例,通过回归拟合获取概率值,对测试数据进行排序,并基于TPR和FPR公式计算真阳性率与假阳性率。文章涵盖从数据预处理、模型预测到最终绘图的全过程,帮助读者理解分类模型的性能评估方法。
本文详解sklearn中predict与predict_proba的区别:前者返回预测标签,后者返回各类别概率数组。重点指出当训练集缺失某些类别时,predict_proba列数会减少,导致predict结果与最大概率索引不一致。建议使用train_test_split的stratify参数保持数据分布一致,避免此类隐蔽Bug。
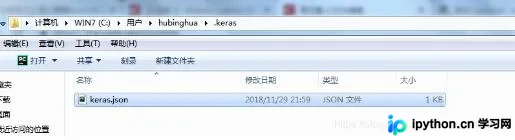
本文介绍如何在Keras中实现Theano与TensorFlow后端训练模型的相互转换。由于两者卷积实现机制不同,需通过特定脚本对卷积层权重进行翻转处理。文章提供了完整的Python转换代码及配置文件修改方法,帮助用户解决跨后端模型迁移时的兼容性问题。
本文详解在深度学习训练中如何使用Keras进行数据切分,包括通过validation_split自动切分验证集和结合Sklearn手动指定验证集两种方法。同时深入解析K折交叉验证原理,展示利用StratifiedKFold进行分层抽样的完整代码示例,并厘清训练集、验证集与测试集的核心区别,帮助开发者更准确地评估模型泛化能力。
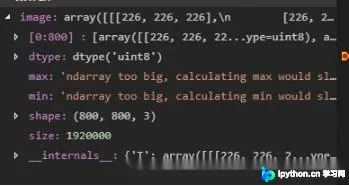
本文介绍如何使用TensorFlow读取JPG图像的长和宽,通过tf.image.decode_jpeg解析图像数据并获取shape信息。同时补充说明TensorFlow中multiply(对应元素相乘)与matmul(矩阵乘法)的区别,帮助开发者正确使用矩阵运算函数。
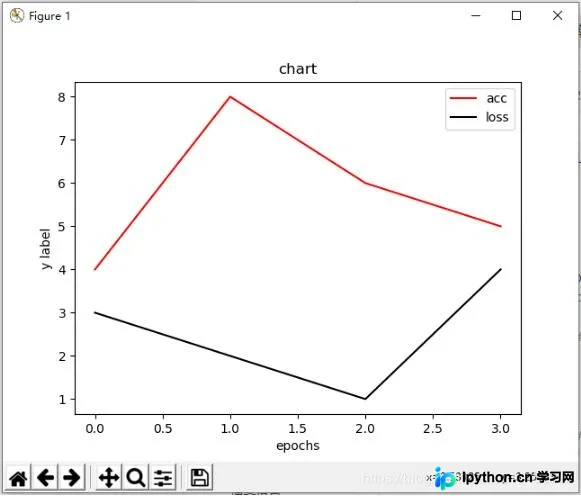
本文介绍如何使用Python的Matplotlib库绘制模型训练的准确率与损失率折线图,以及生成分类任务的混淆矩阵。通过具体代码示例,展示如何配置坐标轴、标签、颜色及图例,并实现中文字符显示与数值标注,帮助开发者直观监控模型训练效果。
本文深入解析TensorFlow中tf.gradients()与tf.stop_gradient()的核心机制。tf.gradients()用于计算目标函数对变量的导数,支持自定义梯度更新;tf.stop_gradient()则用于阻断特定节点的梯度反向传播。通过代码示例展示如何在模型训练中实现前向与反向传播的解耦,以及利用stop_gradient构造自定义梯度更新策略。
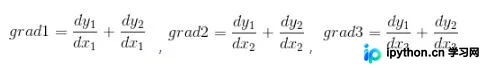
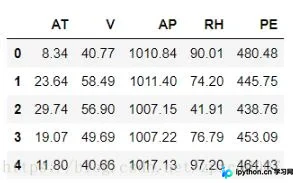
本文详细演示了如何使用Python和SPSS进行多元线性回归分析。通过电厂数据案例,分别采用梯度下降法和sklearn库中的最小二乘法求解回归参数,并对比SPSS结果。文章涵盖数据预处理、损失函数构建、参数迭代优化及模型验证全过程,展示不同方法在参数精度与收敛速度上的一致性。