Python实现喜马拉雅音频批量下载实战
本文介绍如何使用Python编写脚本,从喜马拉雅网站抓取鬼故事专辑的音频文件。通过解析动态生成的JSON数据获取音频链接,并利用requests库实现批量下载保存为m4a格式。代码包含完整的请求头设置、URL解析及文件写入逻辑,适合初学者学习网络爬虫与文件处理。
2026-10-14
6

本文介绍如何使用Python编写脚本,从喜马拉雅网站抓取鬼故事专辑的音频文件。通过解析动态生成的JSON数据获取音频链接,并利用requests库实现批量下载保存为m4a格式。代码包含完整的请求头设置、URL解析及文件写入逻辑,适合初学者学习网络爬虫与文件处理。
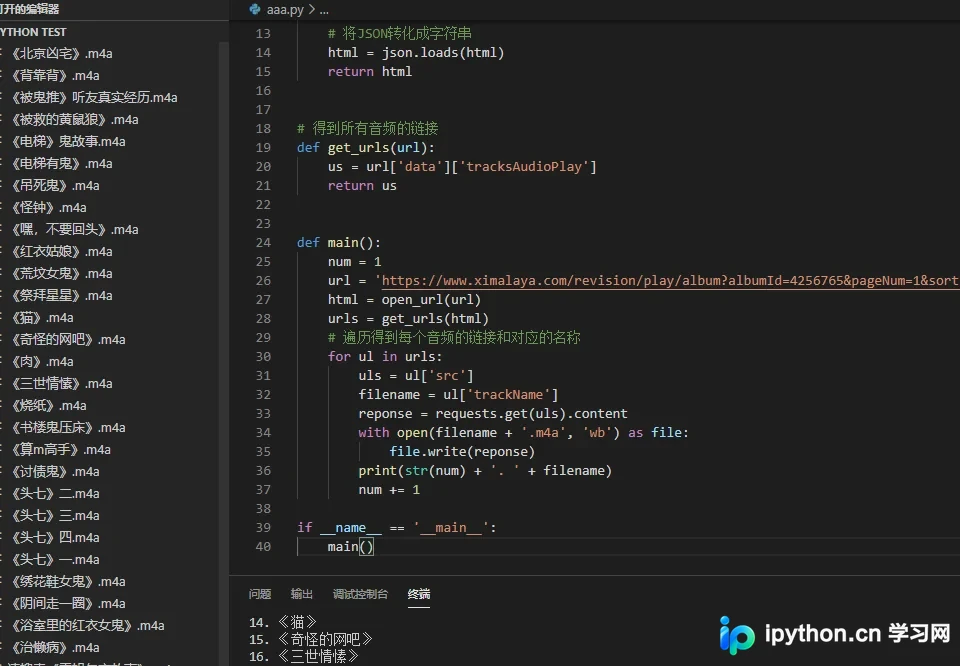
本文详细讲解如何将Django框架与Scrapy爬虫深度集成,实现从51job网站抓取数据、自动存入MySQL数据库,并通过Django视图生成标准JSON接口的完整流程。内容涵盖项目创建、setting配置、scrapy_djangoitem使用、反爬处理及数据库迁移等关键步骤。
本文详解Scrapy中向Spider传递参数的两种主流方法。第一种通过命令行crawl命令的-a选项传入参数,并在Spider构造函数中接收;第二种通过scrapyd调度schedule.json接口使用-d选项添加参数。此外,还介绍了利用Request的meta属性在页面解析间传递数据的技巧,帮助开发者灵活控制爬虫行为。
本文详细解析Python中JSON与字典的核心差异,包括引号、布尔值及空值的格式不同。通过具体代码示例演示如何使用json模块进行数据序列化与反序列化,并深入讲解如何自定义编码规则以处理Python自定义对象到JSON格式的转换,适用于需要处理数据交换的开发场景。
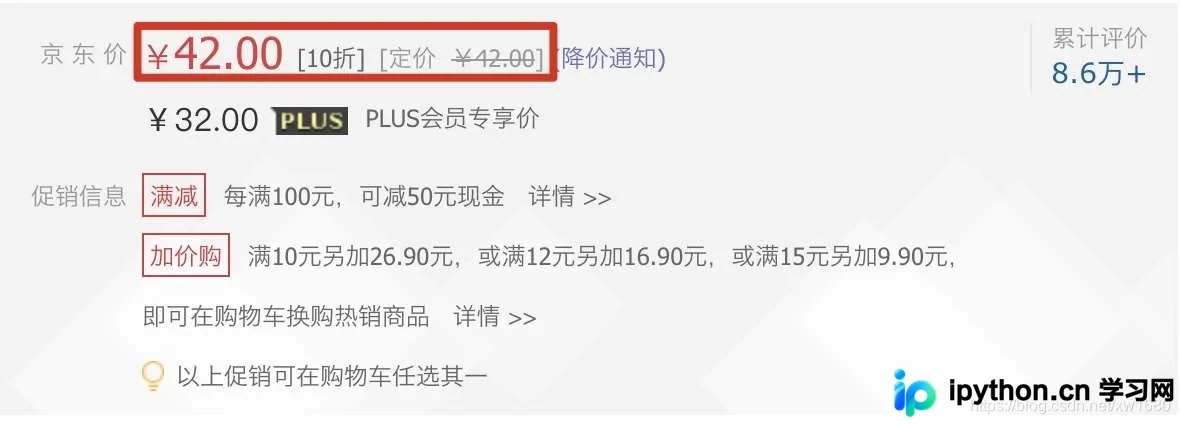
本文详解Python爬虫中动态加载数据的识别与抓取方法。通过浏览器开发者工具分析网络请求,定位非URL直接返回的数据接口,利用requests发送请求并解析JSON数据,解决商品价格等动态内容无法直接获取的问题。
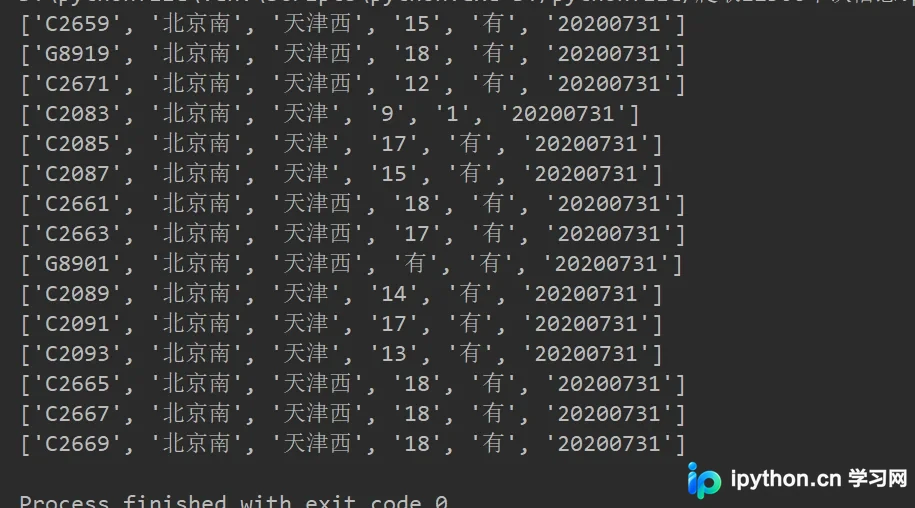
本文详解使用Python抓取12306车次信息的完整流程。重点解决动态加载数据的定位问题,通过配置User-Agent和Cookie规避反爬机制,处理UTF-8编码乱码,并解析JSON数据提取有效车次。包含代码实现、站点字典转换及运行结果展示,适合Python初学者参考。
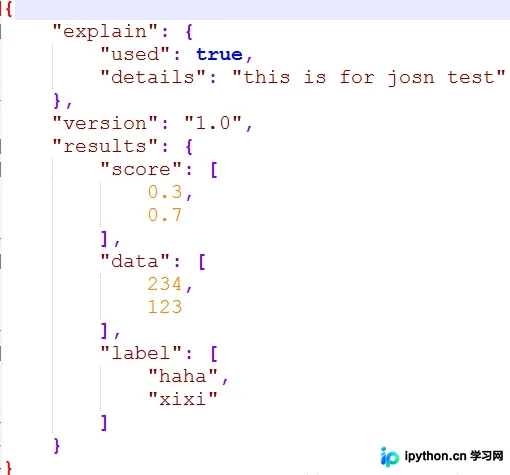
本文介绍Python中将字典内容保存为JSON文件的方法。核心步骤是使用json.dumps()函数将字典对象序列化为字符串,再通过文件写入操作保存。通过设置indent参数可实现格式化缩进输出,提升可读性。文章提供无缩进与有缩进两种代码示例,展示defaultdict与OrderedDict在JSON序列化中的应用。
本文介绍在已安装 Anaconda3 和 VSCode 的情况下,如何将两者关联以复用 Anaconda 中的 numpy、matplotlib 等库。通过修改 VSCode 设置中的 python.pythonpath 或编辑 settings.json 文件,指定 Anaconda 安装路径,即可在 VSCode 中直接调用已安装的第三方包,避免重复安装。
本文深入解析Python中对象序列化的两种核心方式:JSON与Pickle。详细对比了json.dumps/loads与pickle.dumps/loads在数据类型支持、文件读写模式及函数序列化能力上的差异,重点探讨了多次序列化同一对象到文件时JSON与Pickle的不同表现及反序列化报错原因,为Python数据持久化提供实用指南。
本文详解PHP原生JSON处理函数。通过json_encode()可将数组、对象转换为标准JSON字符串,需特别注意UTF-8编码及关联/索引数组的区别;利用json_decode()可将JSON文本还原为PHP对象或关联数组。掌握强制类型转换及常见语法错误排查,即可实现高效的数据序列化与反序列化交互。
本文详细介绍Python中json模块的使用,涵盖json.dumps和json.loads进行数据编码解码,以及json.dump和json.load处理JSON文件。文章还深入探讨了处理嵌套数据、保留字典顺序、格式化输出以及通过自定义hook函数实现复杂Python对象与JSON相互转换的高级技巧。
本文详细介绍如何使用Python3将JSON对象存入Redis数据库,涵盖StrictRedis初始化、List类型操作及常用命令。同时提供利用redis-dump工具进行RDB数据导出与导入的具体命令和步骤,适用于数据库上机作业及日常缓存管理场景。