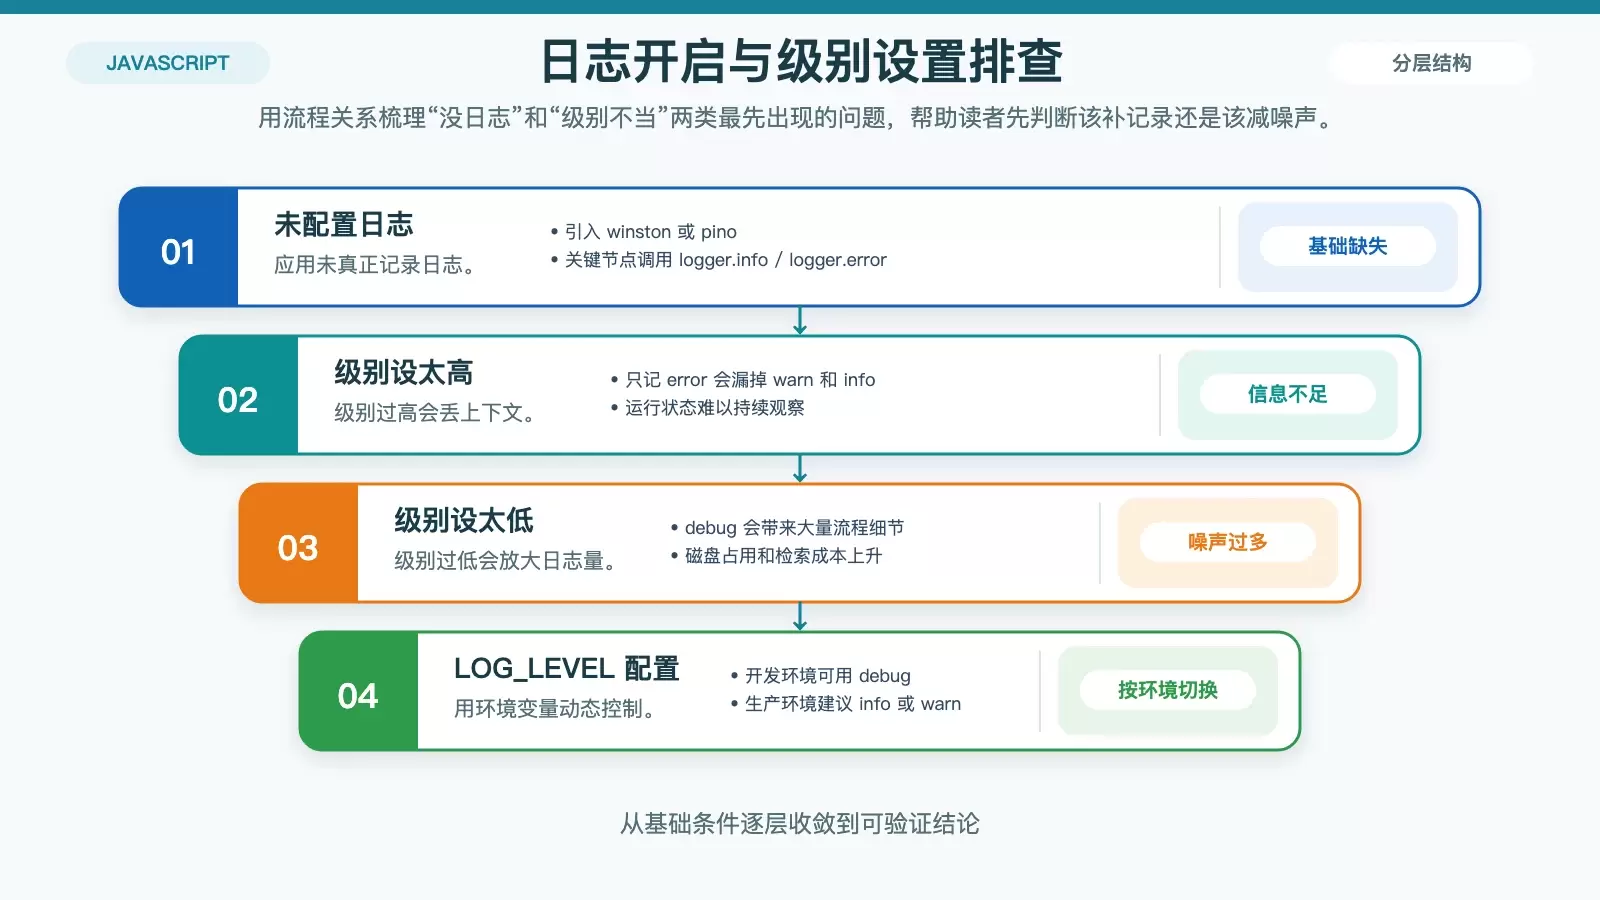
Node.js 日志在 Debian 中如何清晰分类
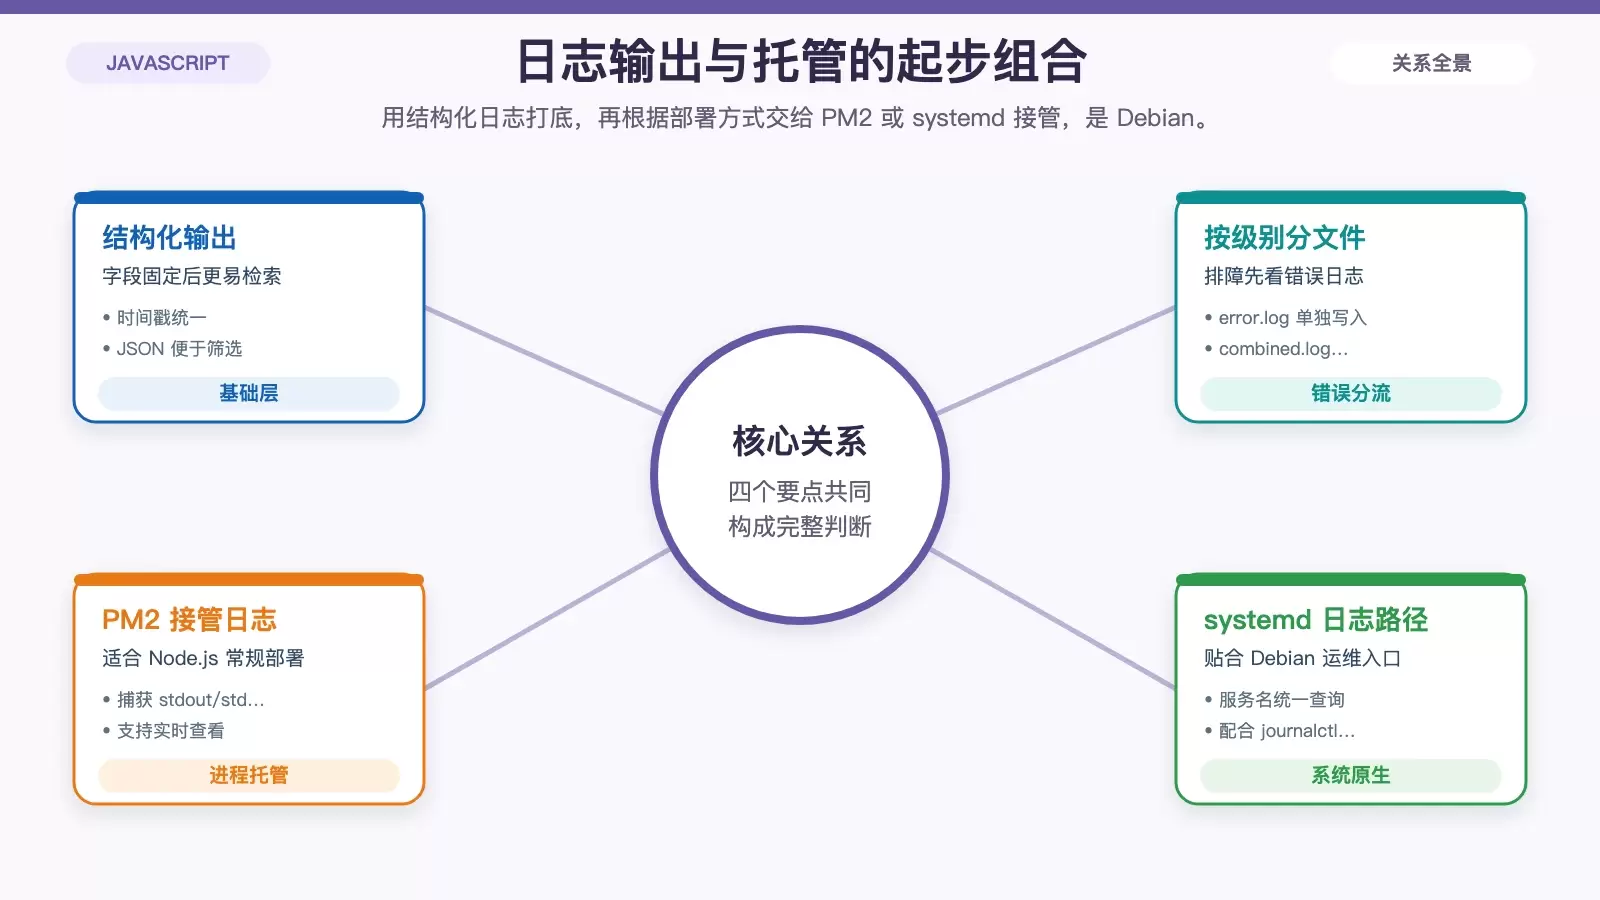
在 Debian 上运行 Node.js 服务时,日志如果只打到控制台,排错和留档都会变得混乱。借助 winston,可以按级别和环境把日志分别写入控制台、错误文件和汇总文件,既方便开发时查看,也更适合线上维护。
2026-08-25
116

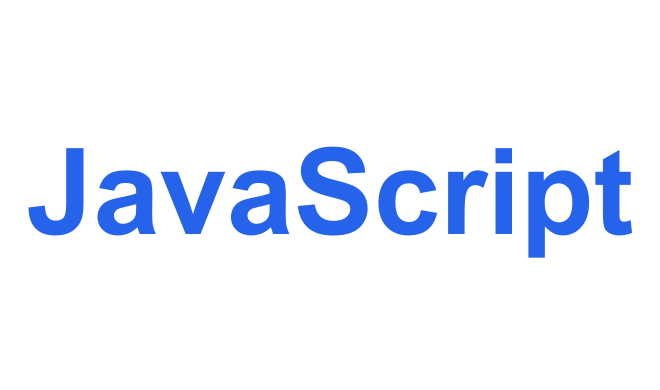
在 Debian 上运行 Node.js 服务时,日志如果只打到控制台,排错和留档都会变得混乱。借助 winston,可以按级别和环境把日志分别写入控制台、错误文件和汇总文件,既方便开发时查看,也更适合线上维护。
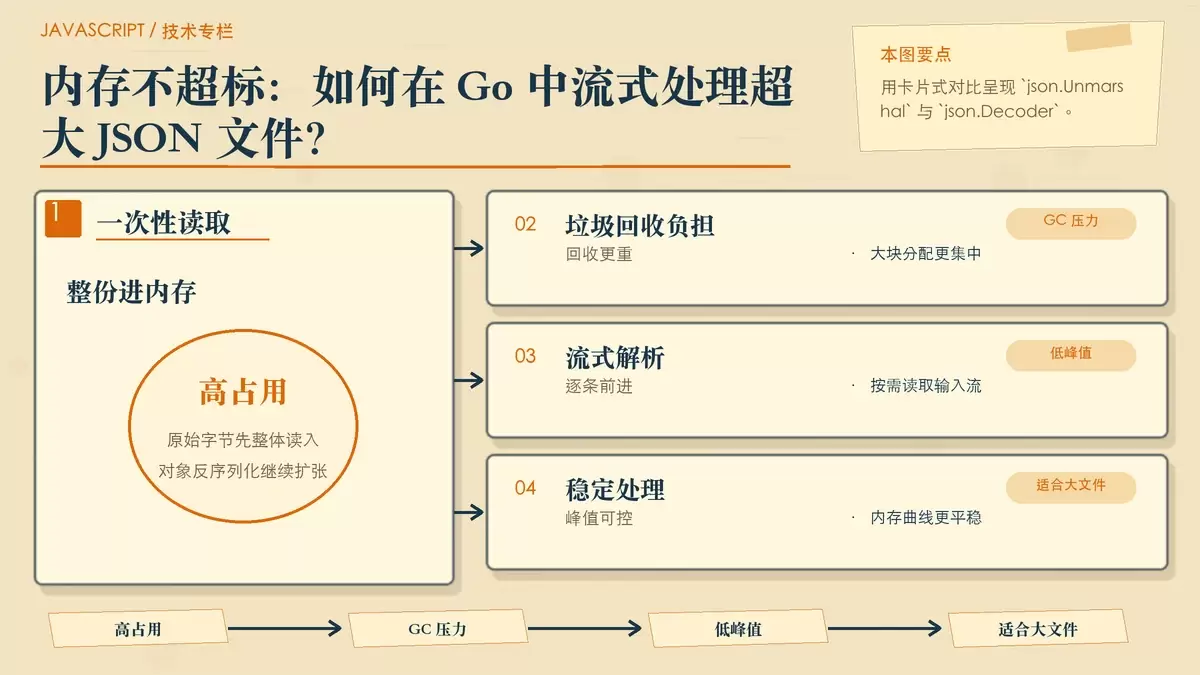
处理 GB 级 JSON 时,`json.Unmarshal` 往往会把整份数据一次性拉进内存,容易触发高占用甚至 OOM。本文围绕 Go 标准库 `json.Decoder` 的流式解析方式,说明它为什么更适合大文件,并给出解析超大 JSON 数组的关键写法、适用场景与落地注意点。
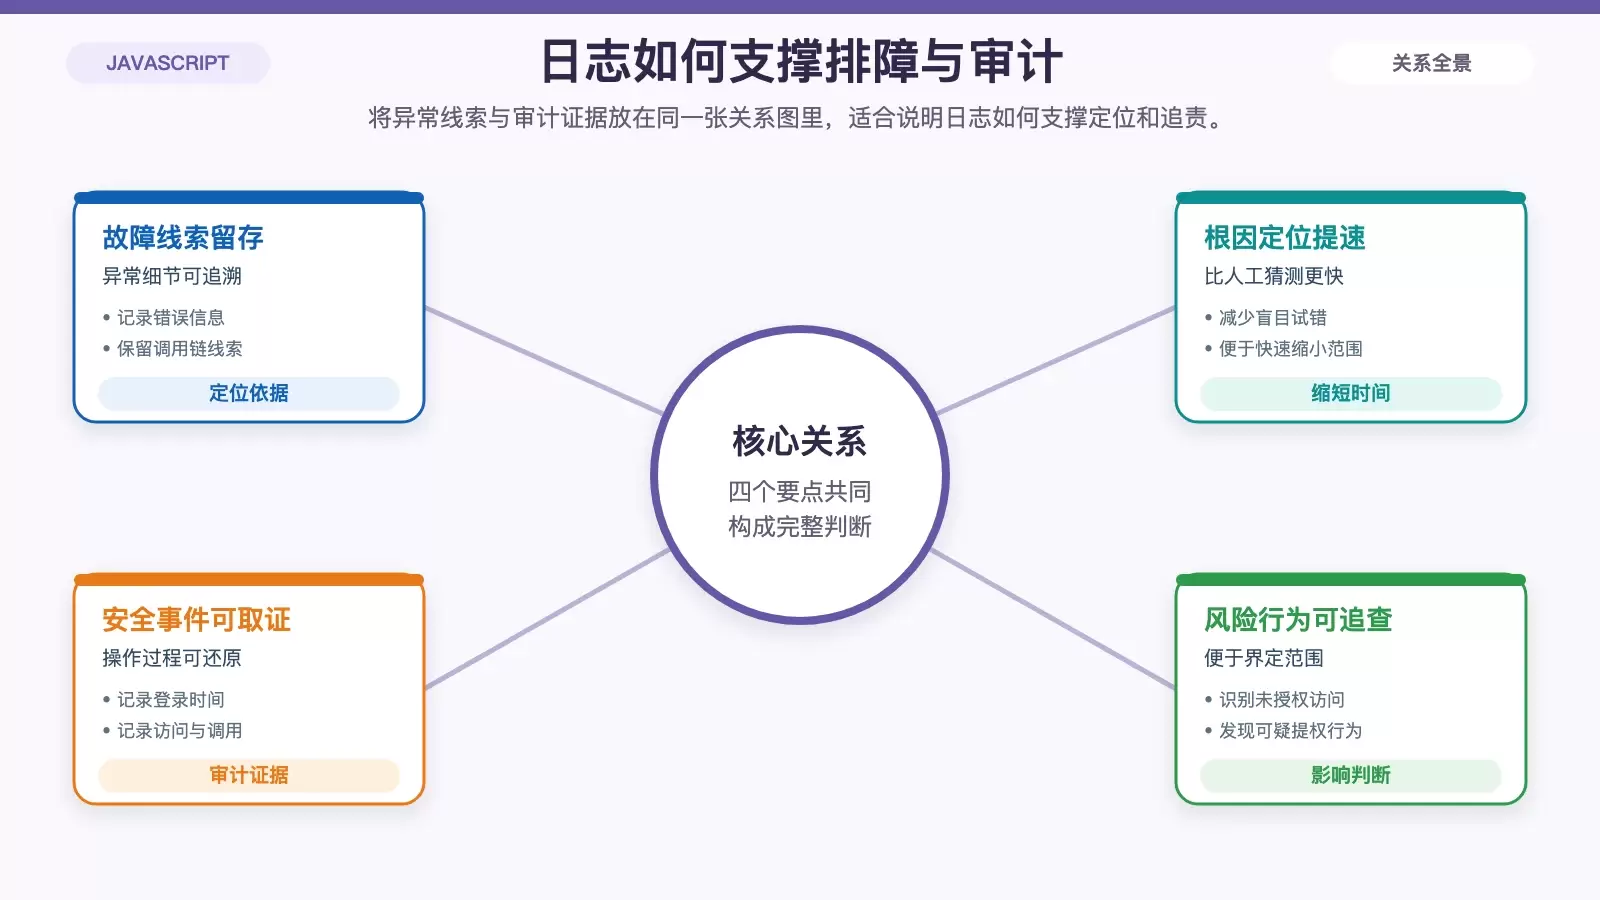
系统日志的价值不在“留痕”本身,而在于它能把故障、性能波动、安全事件和配置变更串成可追溯的时间线。本文围绕 Debian 中 JS 日志在运维场景里的六类作用展开,帮助读者判断日志为什么是维护体系里的基础能力。
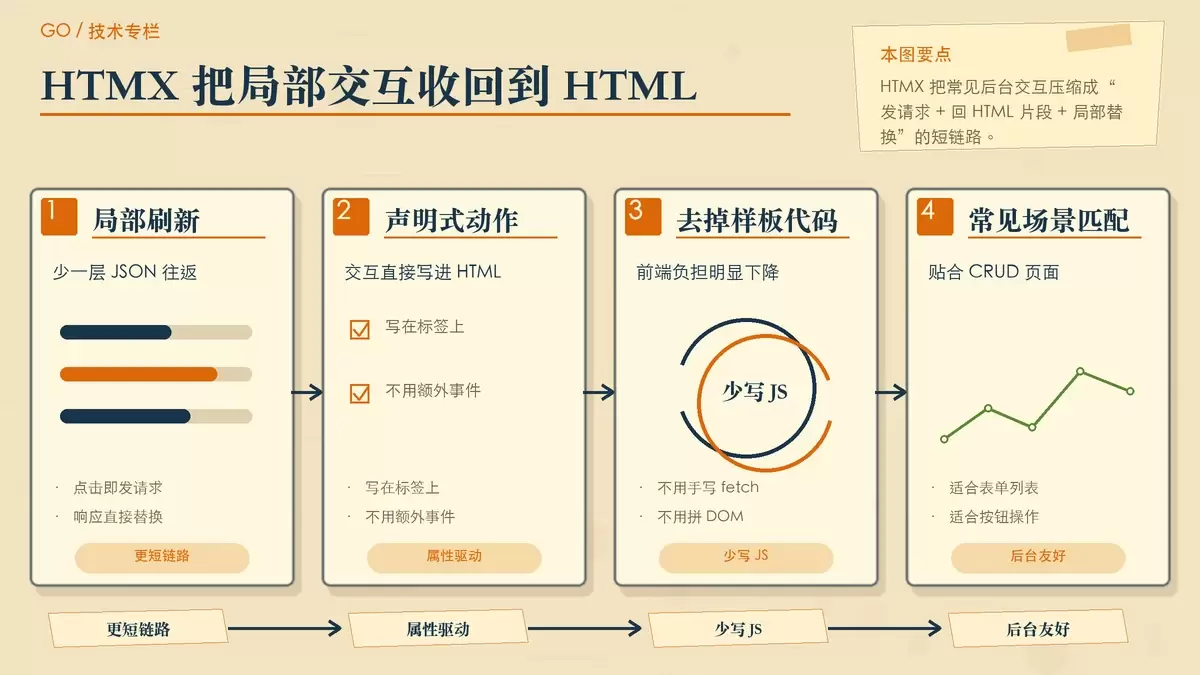
对很多独立开发者和 Go 后端工程师来说,真正拖慢后台项目的,往往不是业务本身,而是前端工程体系的额外复杂度。Go + HTMX + Templ 这套组合的价值,在于用服务端返回 HTML 片段取代大量 JSON 与手写 JS,把交互、模板和后端逻辑重新收拢到一条更短的链路里。
在 Debian 上维护 JavaScript 应用,日志不能只停留在 `console.log()`。这篇文章按“应用产生日志、系统接管、文件轮转、集中分析、异常告警”的顺序,梳理一套可落地的监控链路,并给出适合不同规模部署的判断方法。
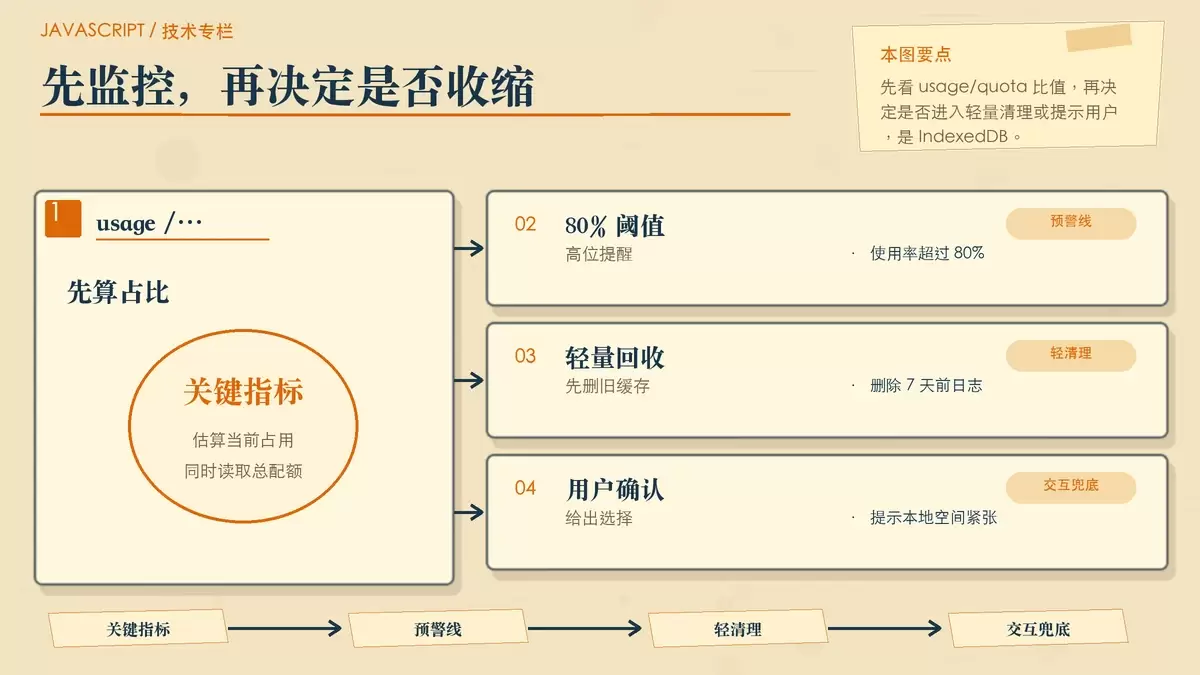
IndexedDB 在现代浏览器里没有固定容量上限,真正难点是如何在动态配额下避免写入失败和数据膨胀。本文从配额机制、容量监控、分批写入到 TTL 与冷数据归档,整理一套更适合长期运行前端应用的本地存储规划方法。
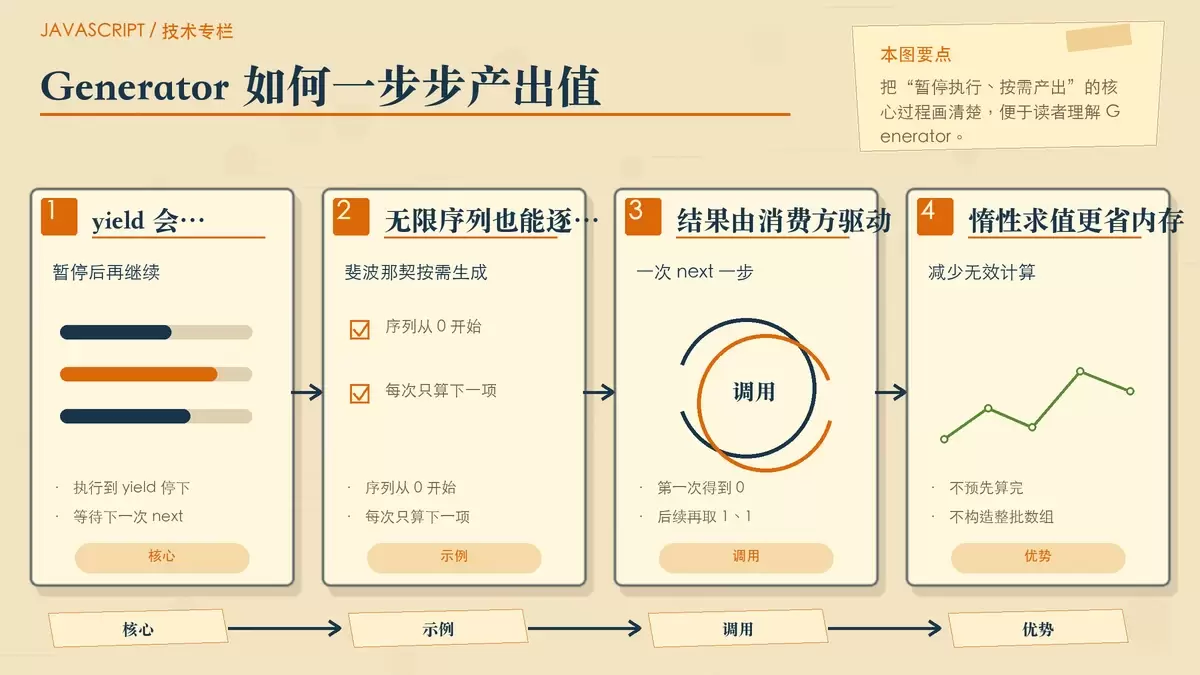
JavaScript 的 Generator 不只是语法糖,它在数据流处理中最实用的价值,是把“什么时候计算”交回给调用方。本文从 `yield` 的暂停机制讲起,再看它如何接入可迭代协议、组合 `map`/`filter`/`take` 等惰性操作,最后落到大文件、分页 API 这类真实场景。
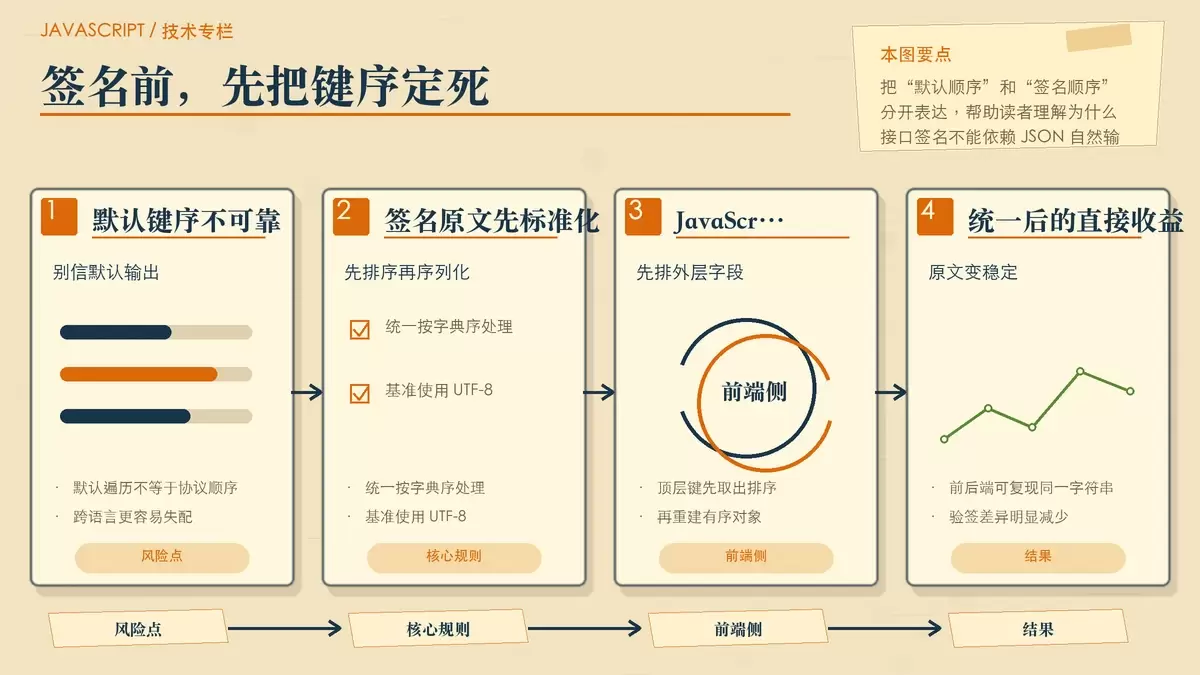
前后端分离接口里,JSON 一旦参与签名,最常见的问题不是算法本身,而是对象键顺序在不同语言、不同库之间并不天然一致。本文围绕 JavaScript 场景梳理一套可落地的做法:签名前统一按字典序序列化、处理嵌套对象、让后端同步同一规则,并补上字段白名单与加盐细节。
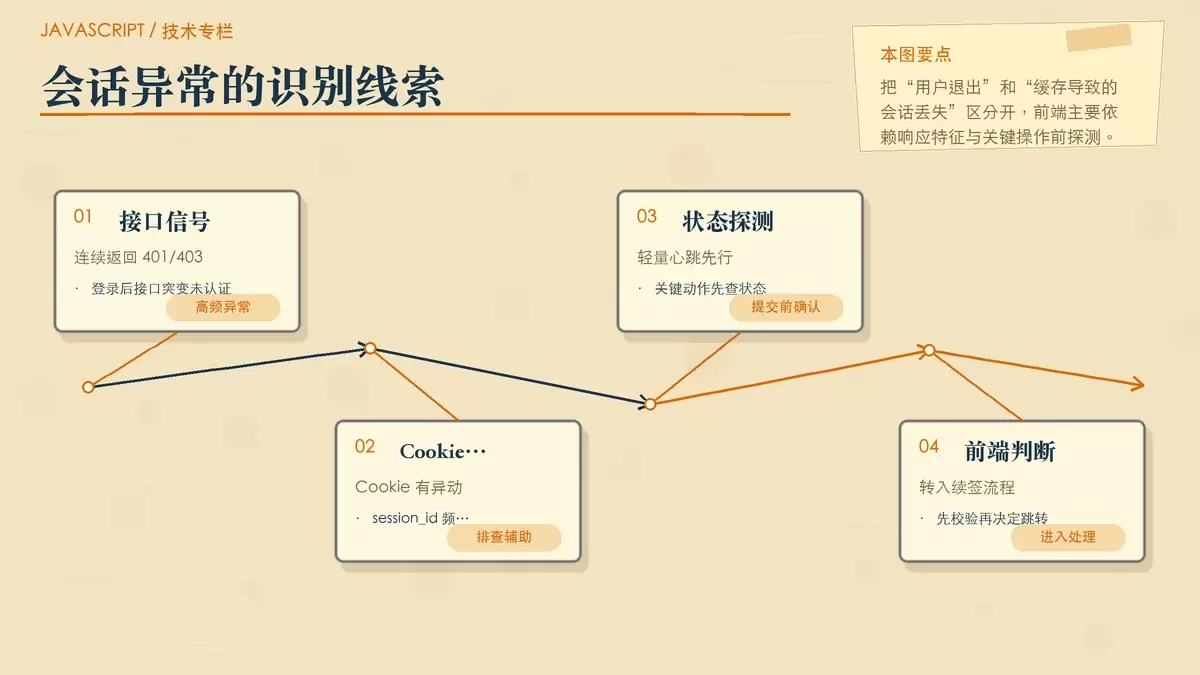
分布式缓存失效后,前端无法直接“救回” Session,但可以通过识别 401/403、心跳探测、续签重放、多标签同步和本地状态兜底,把用户感知到的中断降到最低。关键不是替代后端,而是把异常识别、平滑降级与数据保留串成一套前后端协同方案。
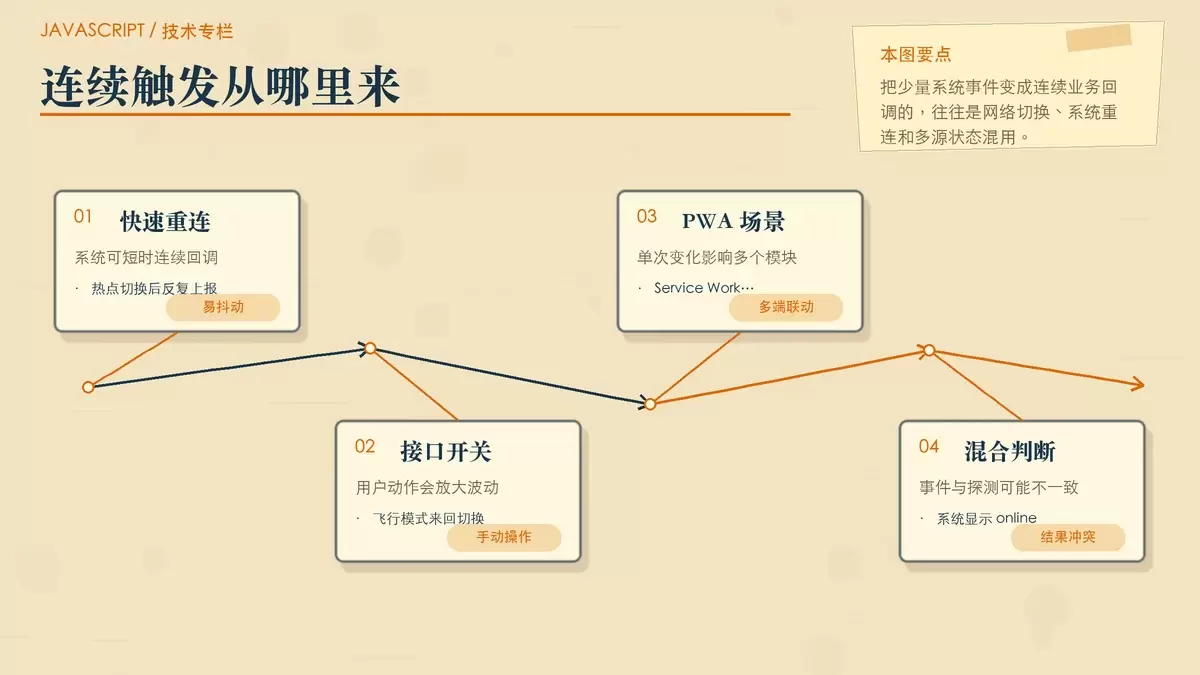
在浏览器里监听 online/offline 事件并不复杂,难点在于系统抖动、网络切换和心跳检测叠加后,状态可能短时间内反复变化。本文把“是否要节流”“为什么更适合防抖+最小间隔”“如何用心跳确认真实在线”拆开讲清,并给出可直接落地的 JavaScript 写法与 React/Vue 集成注意点。
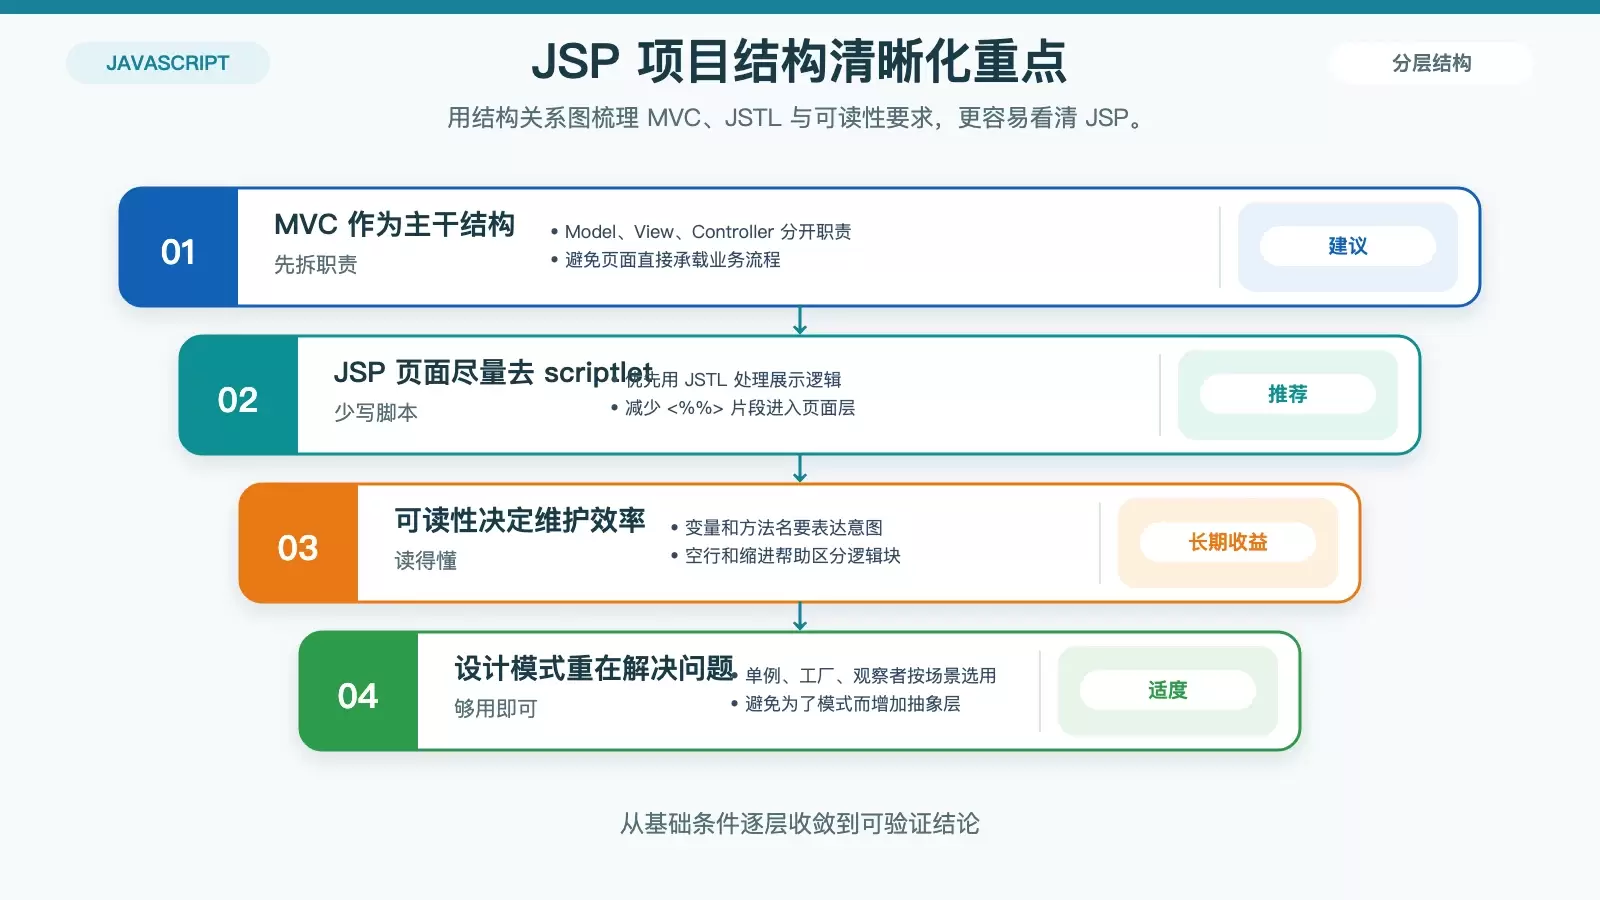
在 Ubuntu 上做 JSP 开发,代码质量不能只靠“写完能跑”来衡量。真正决定项目是否好维护的,是分层设计、测试覆盖、构建自动化和安全约束能否尽早落地。本文按团队最常见的痛点,梳理一套适合持续执行的改进路径。
在 Debian 上运行 Node.js 时,日志问题往往不是“有没有输出”这么简单,而是集中在级别、路径、权限、轮转和生产环境落盘策略上。把这些环节配对了,后续排错、监控和审计才有稳定基础,也能避免磁盘爆满或日志丢失。