


浏览器提供的 online/offline 事件看起来简单,但一旦遇到 Wi‑Fi 抖动、飞行模式切换、虚拟网卡重连,页面状态就可能来回跳,带来 UI 闪烁、重复请求甚至错误提示。处理这类问题,关键不只是“加不加节流”,而是先分清事件频率、真实在线状态与业务更新时机,再决定用防抖、最小间隔节流还是心跳校验的组合方案。
为什么网络状态监听里还会需要节流
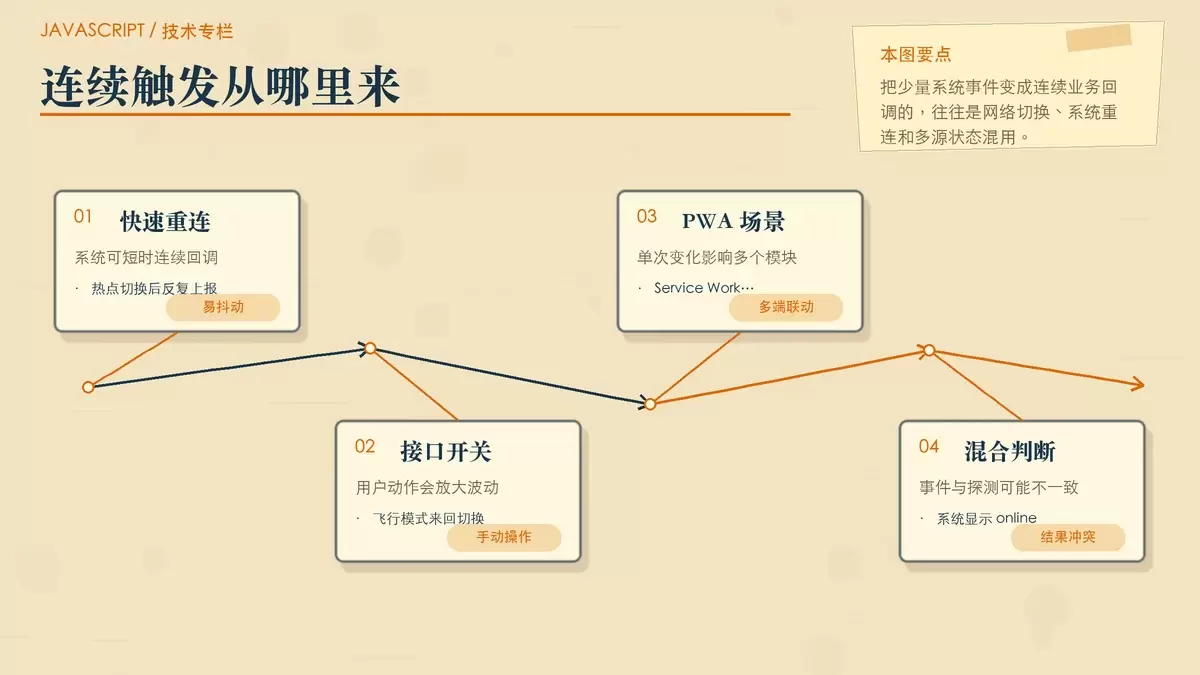
单看 navigator.onLine,状态变化并不算频繁,因为它通常只在系统网络接口真实通断时才会触发。但在实际项目里,问题往往不是“事件太多”,而是某些特殊场景会把少量事件放大成一串连续回调。
常见情况包括:
- 操作系统的网络管理器快速重连,比如 macOS 切换热点后,几秒内可能多次上报状态变化。
- 用户手动开关飞行模式,或者临时禁用、启用网卡。
- PWA 配合 Service Worker 激活逻辑时,网络状态变化会牵动多处同步更新。
- 把
online/offline与fetch心跳结果混合使用时,可能出现“系统说在线、心跳却失败”的冲突状态。
所以,节流在这里不是必需步骤,但在下面两类问题上很有价值:
- 避免短时间内反复刷新 UI,导致在线/离线标识闪烁。
- 避免在恢复网络的瞬间触发多次同步、补发或重试请求。
更合适的思路:防抖优先,必要时再加最小间隔节流
严格来说,网络状态切换更接近“瞬态事件后的最终状态确认”,因此很多场景下,防抖比传统节流更贴切。原因很简单:你通常不关心 1 秒内触发了几次,而更关心最后到底是稳定在线还是稳定离线。
但如果你的页面在每次状态变化时都会弹提示、刷新列表,或者尝试恢复待发任务,那么再加一层“最小响应间隔”会更稳。这样做的目标不是精准限流,而是防止用户在短时间内看到多次重复反馈。
下面这段就是一个带 1.5 秒最小间隔的节流处理器,适合直接挂到 online/offline 事件上:
let lastTrigger = 0;
const THROTTLE_DELAY = 1500;

function throttleOnlineHandler() {
  const now = Date.now();
  if (now - lastTrigger < THROTTLE_DELAY) return;
  lastTrigger = now;

  console.log('✅ 网络状态已更新,执行同步逻辑');
  // 例如:恢复待发队列、重新拉取未完成数据、更新 UI 状态图标
}

window.addEventListener('online', throttleOnlineHandler);
window.addEventListener('offline', throttleOnlineHandler);
这段代码的优点是足够轻,适合先挡住最常见的重复触发问题。但它也有边界:它限制的是“执行频率”,并不能保证你拿到的就是“真实可用的网络状态”。如果业务依赖接口可达性,后面还需要补一层校验。
比节流更关键:用心跳确认真实网络状态
只依赖 navigator.onLine 很容易误判。因为它更像是“系统网络接口是否可用”的信号,而不是“你的业务接口是否真的能访问”的结论。比如设备已经连上了某个网络,但网关异常、DNS 不通,或者业务域名暂时不可达,这时页面仍可能被判定为在线。
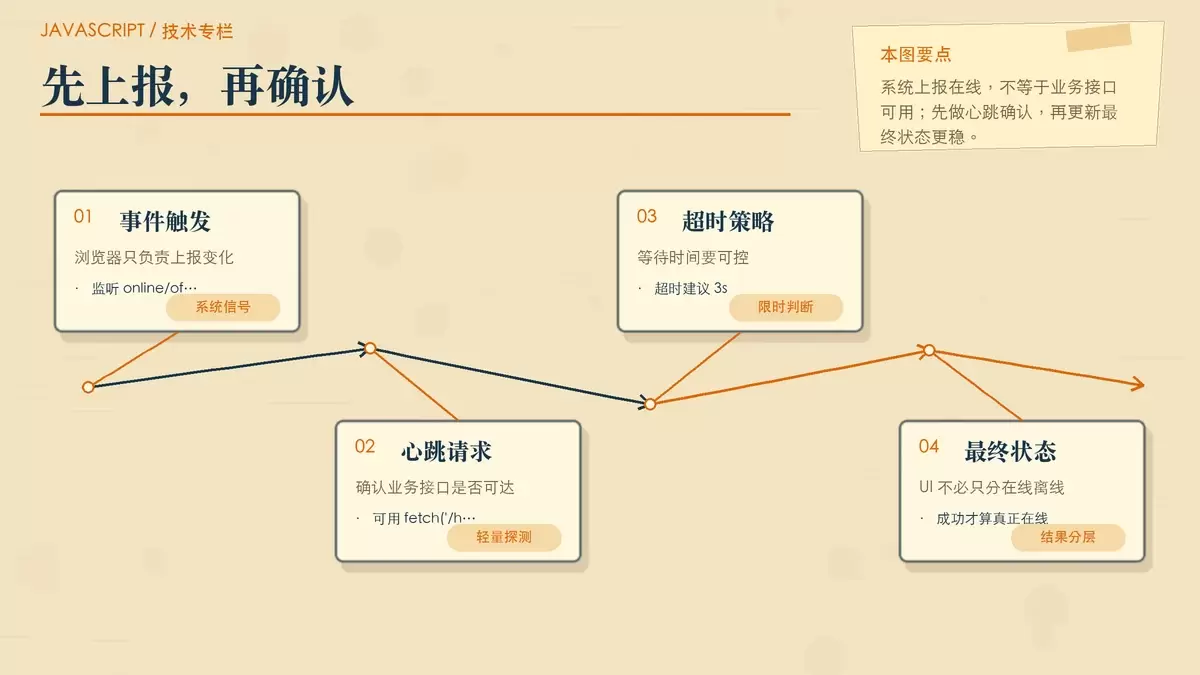
更稳妥的做法是:在网络事件触发后,立刻发起一次轻量级心跳检测,再决定是否更新最终状态。
online触发后,用fetch('/health'),或对静态资源发一个HEAD请求,比如/ping.txt。- 超时建议控制在
3s左右,避免用户长时间停留在不确定状态。 - 只有心跳成功,才把页面标记为“真正在线”;否则可以维持“弱网”或“假在线”状态。
- 如果你已经做了节流,最好把节流放在心跳完成之后,而不是事件一触发就立刻刷新 UI。
这一层判断的意义在于,把“系统事件”与“业务可用性”分开。前者只能告诉你网络接口变了,后者才决定是否该恢复请求队列、重新拉数据或清除离线提示。
在 React 和 Vue 里落地时,重点看监听器与状态引用
把这套逻辑放进框架组件时,最容易出问题的不是节流本身,而是监听器清理和状态引用生命周期。
React 中需要注意什么
- 在
useEffect中注册addEventListener,并在清理函数里移除监听器。 - 节流相关的时间戳或计时器引用,优先放到
useRef,避免闭包捕获旧值。 - 状态更新尽量统一走
useState,不要在多个监听分支里重复setState。
Vue 中需要注意什么
- 在组件挂载后绑定事件,在
onUnmounted中移除监听器。 - 如果使用组合式 API,节流状态可以通过
ref保存,确保多次回调共享同一份引用。 - 网络状态、心跳结果和 UI 展示状态最好拆开管理,避免一个布尔值承载太多语义。
简单说,框架集成时要保证两件事:一是监听器不会越挂越多,二是节流和心跳逻辑读到的始终是最新状态。否则即便浏览器事件没问题,组件层面也可能出现重复更新或状态错乱。
实际选择建议:什么时候该节流,什么时候先做校验
如果你的页面只是展示一个在线/离线角标,而且没有额外请求动作,很多时候直接监听事件就够用了,甚至不一定要加节流。
但只要涉及下面这些动作,就建议把节流或防抖纳入设计:
- 网络恢复后自动补发请求队列。
- 重新拉取未完成数据。
- 弹出联网提示、错误提示或重试提示。
- 多个组件会同时响应在线状态变化。
落地时可以按这个顺序判断:
- 先监听
online/offline作为系统级信号。 - 再用
fetch('/health')或HEAD请求确认业务侧是否真正可达。 - 最后根据 UI 和请求重试的敏感度,决定是否增加防抖或
1500ms 这类最小间隔节流。
这样处理,既不会把简单问题复杂化,也能在弱网、重连和状态抖动场景下把页面行为控制得更平滑。









