

基于OpenCV与Python的车牌定位及字符分割实战
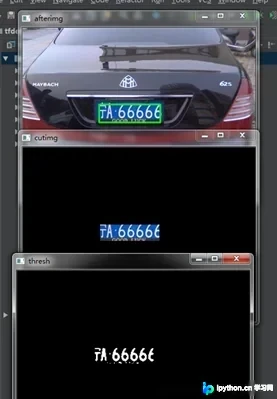
本文详解利用Python和OpenCV库进行车牌区域识别与字符分割的技术流程。内容涵盖从车辆图像获取、车牌定位(含二值化、边缘检测、形态学处理)到字符分割的具体步骤,并通过Sobel算子、高斯滤波等算法实现精准定位与分割,附带完整代码示例与运行效果分析。
2026-10-13
6

本文详解利用Python和OpenCV库进行车牌区域识别与字符分割的技术流程。内容涵盖从车辆图像获取、车牌定位(含二值化、边缘检测、形态学处理)到字符分割的具体步骤,并通过Sobel算子、高斯滤波等算法实现精准定位与分割,附带完整代码示例与运行效果分析。
本文介绍利用Python的PIL库实现批量生成指定尺寸图片并添加任意文字的功能。脚本支持通过命令行直接指定宽高与内容,或通过CSV文件批量读取配置。核心逻辑包含自动调整字体大小以适应图片区域,并将文字居中绘制。代码提供完整实现及数据文件格式说明,适合需要快速生成测试素材或特定规格图片的开发场景。
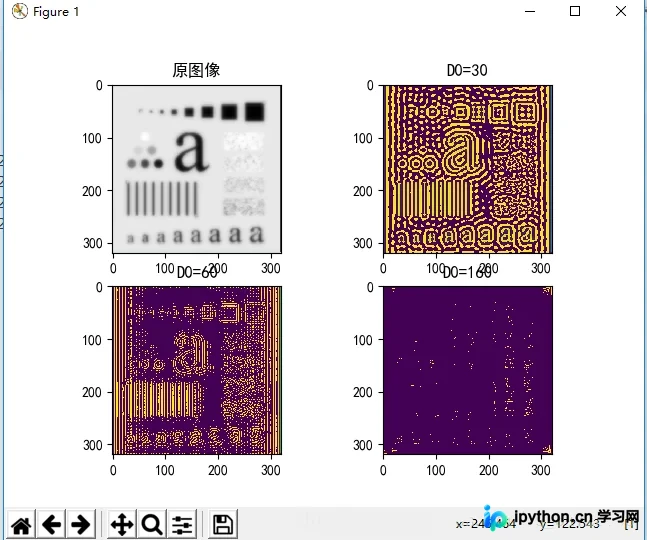
本文介绍如何使用Python和OpenCV实现理想高通滤波。通过读取图像、转换为灰度并执行FFT,构建不同截止频率(D1=30, D2=60, D3=160)的滤波器。代码演示了频域乘法与逆FFT过程,最终对比展示原图与不同阈值下的滤波结果,帮助理解频域高通处理对图像边缘提取的影响。
本文针对Python中使用OpenCV读取本地视频文件时出现的帧率为0及读取失败问题,提供了基于修改FFmpeg动态链接库的解决方案。通过重命名opencv_ffmpeg.dll文件并配置环境变量或复制至Python目录,可有效解决常见读取异常,确保视频处理流程正常运行。
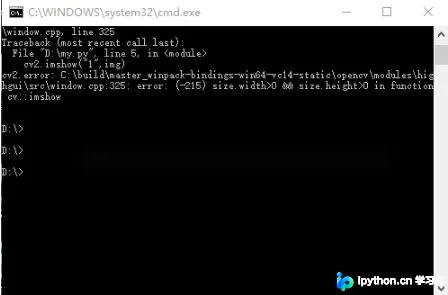
本文介绍在Python中使用OpenCV库时,imread函数因图片路径问题导致size.width>0断言失败的错误。通过检查图片与代码目录关系,采用相对路径或绝对路径修正,可有效解决无法打开或找不到图片的问题,确保程序正常运行。
本文介绍如何在Python中利用OpenCV库实现图片加框和文字标注功能。通过安装opencv-python,引用cv2模块,读取指定路径图片,并使用rectangle函数绘制矩形框及putText函数添加文字,即可完成基础图像处理操作。
在 Python 进行大批量图像数据处理时,个别损坏或丢失的文件可能导致程序中断。本文介绍两种判断图像是否读取成功的方法:一是利用 cv2.imdecode 配合 try-except 捕获异常以跳过失败图像;二是针对文件可能不存在的情况,直接通过 try 判断文件读取结果。这两种方法能有效提升批量处理脚本的鲁棒性,避免因单点错误导致整体任务失败。
本文介绍如何使用Python的Pillow库将图片转换为二进制文本文件。通过读取图像像素的红绿蓝三色值,计算灰度和并设定阈值,将黑色区域转换为1,其他颜色转换为0,最终生成包含0和1的文本文件,适用于机器学习数据预处理等场景。
本文介绍如何使用Python结合OpenCV库判断图像是否成功加载。通过cv2.imread读取图片后,检查返回值是否为None,若为空则打印提示信息。该方法简单有效,适用于图像处理的初步验证场景。
本文介绍如何利用Python结合OpenCV库,从原始图像中随机截取指定宽高的子图像。通过设定随机坐标范围与目标尺寸,可批量生成用于机器学习训练的负样本或测试数据。代码包含完整的读取、随机定位、裁剪及保存逻辑,适用于需要大量随机局部图像的场景。
本文介绍利用Python和OpenCV库批量截取图像指定区域的方法。通过遍历文件路径,读取图像后利用切片操作提取感兴趣区域(ROI),并保存至新目录。代码示例展示了如何处理连续编号的图片文件,并跳过特定编号以应对异常文件。
本文介绍在Python中利用OpenCV进行简单图片比对的两种方法。第一种方法通过计算m x m图片矩阵的特征值并比较其范围来判断图片是否相同;第二种方法对二值化图片矩阵中的1进行求和,通过比较总和数值来识别图片。代码示例展示了如何读取灰度图像、计算指标并批量比对文件,适用于基础图像识别场景。