

matplotlib 设置指定尺寸图片并保存的方法
本文介绍在matplotlib中解决横坐标过多导致重叠的问题,通过设置figure尺寸和子图参数优化布局。重点说明使用plt.savefig保存指定尺寸图片的正确时机,强调保存操作需在show之前执行,并提供完整代码示例供参考。
2026-10-13
6

本文介绍在matplotlib中解决横坐标过多导致重叠的问题,通过设置figure尺寸和子图参数优化布局。重点说明使用plt.savefig保存指定尺寸图片的正确时机,强调保存操作需在show之前执行,并提供完整代码示例供参考。
本文介绍如何在 matplotlib 中获取绘图后的二进制数据流。通过源码分析与实践,提供了两种主要方法:利用 io.BytesIO 结合 canvas.print_png 保存,或通过 canvas.print_to_buffer 获取缓冲区并转换为 Image 对象后保存。此外,还演示了如何将二进制数据进一步转换为 NumPy 数组,适用于需要直接处理图像像素数据的场景。
本文介绍如何在Django框架中直接通过HttpResponse输出Matplotlib生成的图片,无需先保存为文件。基于Python 2.7和Django 1.83环境,通过views.py中的gen_mat函数示例,展示利用FigureCanvasAgg将图表数据直接转换为PNG格式返回给浏览器的完整实现过程。
本文详细介绍如何使用Python3编写爬虫程序,从Pixabay网站批量下载图片。通过解析网页源码,利用正则表达式匹配包含cdn.pixabay.com/photo/的.jpg链接,并结合requests与BeautifulSoup库实现自动化下载。代码包含超时处理、文件夹自动创建及异常捕获机制,适合Python初学者参考学习。
本文介绍利用Python标准库urllib2和re模块编写简单爬虫,通过正则表达式匹配网页源码中的图片链接,并使用urlretrieve函数将JPG图片批量下载至本地指定目录的完整代码示例与步骤说明。
本文介绍利用Python的PIL库与pytesseract进行指定区域截图及图像识别的方法。通过设定坐标参数自动截取图像区域并保存,随后调用OCR接口将图片转换为文本输出,适用于批量处理固定格式的图片内容。
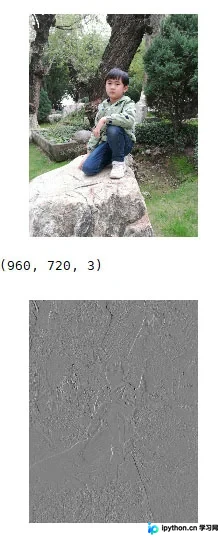
本文介绍利用Python和TensorFlow通过Sobel卷积核提取图片轮廓的方法。核心步骤包括载入彩色图像,构建3通道输入、1通道输出的3x3卷积核,执行卷积运算后对结果进行归一化处理(映射至[0,1]区间并乘以255),最终输出带有边缘信息的灰度图像。文中还包含环境配置及pip更新建议。
本文详细讲解如何在Python环境中配置Tesseract-OCR及pytesseract库以实现图像文字识别。内容涵盖Pillow、pytesser3、autopy3及Tesseract的安装步骤,重点解决Tesseract路径未加入环境变量导致的报错问题,并提供完整的Python识别代码示例及效果展示。

在Python3环境下,cv2.imwrite无法直接处理包含中文字符的文件路径。本文介绍使用cv2.imencode结合tofile方法作为替代方案,通过视频帧提取示例演示如何正确保存带有中文路径的图片文件,解决编码兼容性问题。
本文介绍在Python环境中使用pytesseract库识别图片文字的方法。详细列出安装Python 2.7或3.4、Pillow、tesseract-ocr及pytesseract的步骤,涵盖Ubuntu环境下的具体命令。通过示例代码展示识别过程,并提示可能出现乱码的情况,供开发者参考。
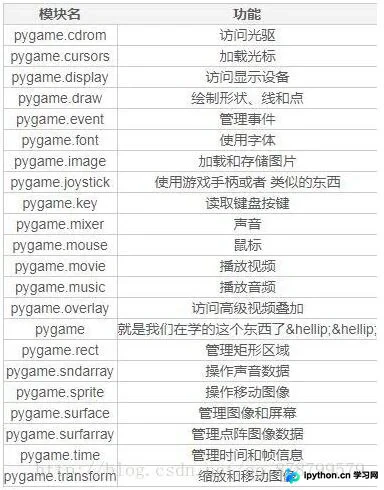
本文介绍如何利用Python的Pygame模块实现文字到图片的转换。通过导入pygame库,初始化环境后设置指定字体、字号及颜色,渲染文字并保存为图片文件。该方法简单实用,适用于需要批量生成文字图片的场景。
本文介绍利用Python的PIL库和NumPy库实现多张图片纵向拼接的方法。通过读取图片并统一宽度,利用NumPy数组追加操作合并图像数据,最终保存为合并后的图片文件。