Flask表单基础:HTML结构、提交方式与GET/POST区别详解
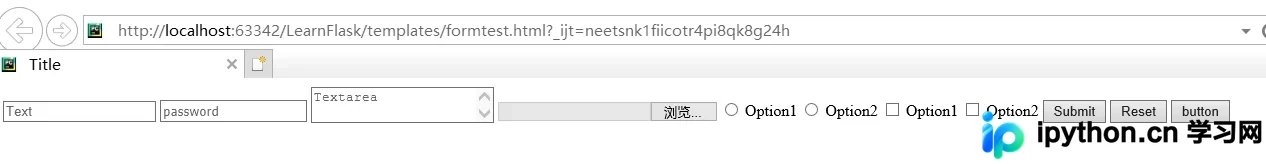
本文详细介绍Flask框架中HTML表单的基础知识,涵盖表单标签、域及按钮的语法与属性。重点解析GET与POST两种提交方式在数据可见性、缓存机制、安全性及长度限制上的核心区别,并给出各自适用场景建议,帮助开发者在Flask项目中正确选择数据交互策略。
2026-10-13
6

本文详细介绍Flask框架中HTML表单的基础知识,涵盖表单标签、域及按钮的语法与属性。重点解析GET与POST两种提交方式在数据可见性、缓存机制、安全性及长度限制上的核心区别,并给出各自适用场景建议,帮助开发者在Flask项目中正确选择数据交互策略。
本文详解如何使用Python通过SMTP协议发送电子邮件。涵盖POP3、IMAP与SMTP概念,以163邮箱为例演示授权码配置。提供纯文本、HTML格式及图片内嵌、文件附件发送的完整代码示例,基于smtplib和email库实现稳定可靠的邮件自动化功能。
本文介绍在C# WinForm应用中,利用WebBrowser控件实现前端HTML与后端C#代码的双向交互。核心在于设置ObjectForScripting属性并标记类为ComVisible,使双方能够直接调用对方暴露的方法,无需编写复杂的桥接代码。
本文介绍Python中BeautifulSoup库的基本用法。内容涵盖模块导入、HTML文档解析,以及如何通过find和find_all方法查找特定标签(如a、p等)。同时演示如何获取标签名称、文本内容及属性值,并利用正则表达式和CSS选择器进行高级筛选,最后展示修改和删除节点属性的实际操作。
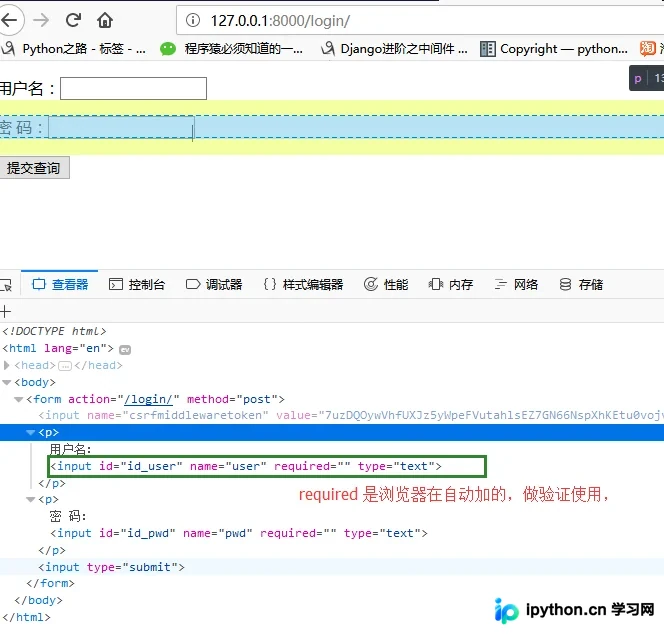
本文详解Django中Form表单的使用,对比原生HTML按钮与Django Form类的差异。通过实例演示如何创建视图类、实例化Form对象并在前端渲染,重点讲解is_valid()方法与cleaned_data的使用,实现数据提交与错误处理,帮助开发者掌握Django表单验证的核心机制。
本文总结了在React与Django技术栈中清除浏览器缓存的三种常用方法。首先介绍通过HTML Meta标签强制不缓存的策略;其次讲解利用JavaScript重置Form表单以清除用户输入缓存的技巧;最后详解jQuery Ajax请求中通过设置headers或cache:false属性来避免数据缓存的配置方式,帮助开发者解决前后端分离场景下的缓存一致性问题。
本文介绍如何在Python中使用正则表达式过滤HTML标签并提取纯文本。通过定义多个正则规则,依次移除CDATA、Script、Style标签及HTML注释,并将换行符转换为标准格式,最后替换字符实体。该方法能有效清理HTML字符串,适用于网页内容抓取与数据处理场景。
本文介绍如何将Jupyter Notebook(ipynb)文件转换为PDF格式。针对直接导出报错及安装LaTeX环境体积过大的问题,提出通过HTML中间格式转换的方案。利用python的pdfkit库配合wkhtmltopdf工具,实现保留格式与颜色的PDF生成,操作简便且安装包体积小。
本文解析如何使用PHP将MySQL数据库中的新闻数据生成为静态HTML分页文件。通过计算总页数,循环读取数据库数据并替换模板占位符,最终写入独立的HTML文件。尽管使用了已废弃的mysql扩展,但该逻辑清晰展示了静态页面生成的核心步骤,适用于理解网页静态化机制。
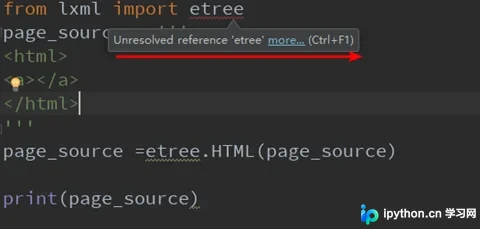
本文解析Python中使用lxml库时etree导入报红但不影响运行的原因。指出这是IDE对C扩展模块的误报,并提供通过html模块调用etree的替代写法,确保代码提示正常且功能不受影响。
本文深入解析Django框架中XSS跨站脚本攻击的成因及防御策略。重点剖析{{comment|safe}}过滤器在富文本场景下的潜在风险,并详细介绍如何利用django.utils.html模块中的escape、strip_tags及remove_tags函数,对用户输入进行服务端转义处理,从而有效阻断脚本注入,保障Web应用安全。
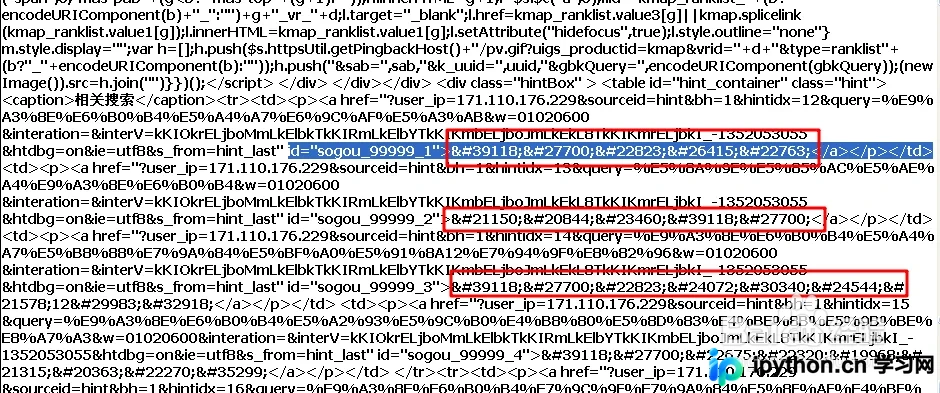
本文介绍在Python中处理以&#开头加数字的HTML字符编码(如风)的方法。针对Python 2.7版本,需导入HTMLParser模块并使用HTMLParser().unescape()进行转换;对于Python 3.7及以上版本,推荐使用html模块或from html import unescape直接处理字符串,实现从中文字符编码到正常文本的还原。