Go 语言 context.Value 的强类型安全实践
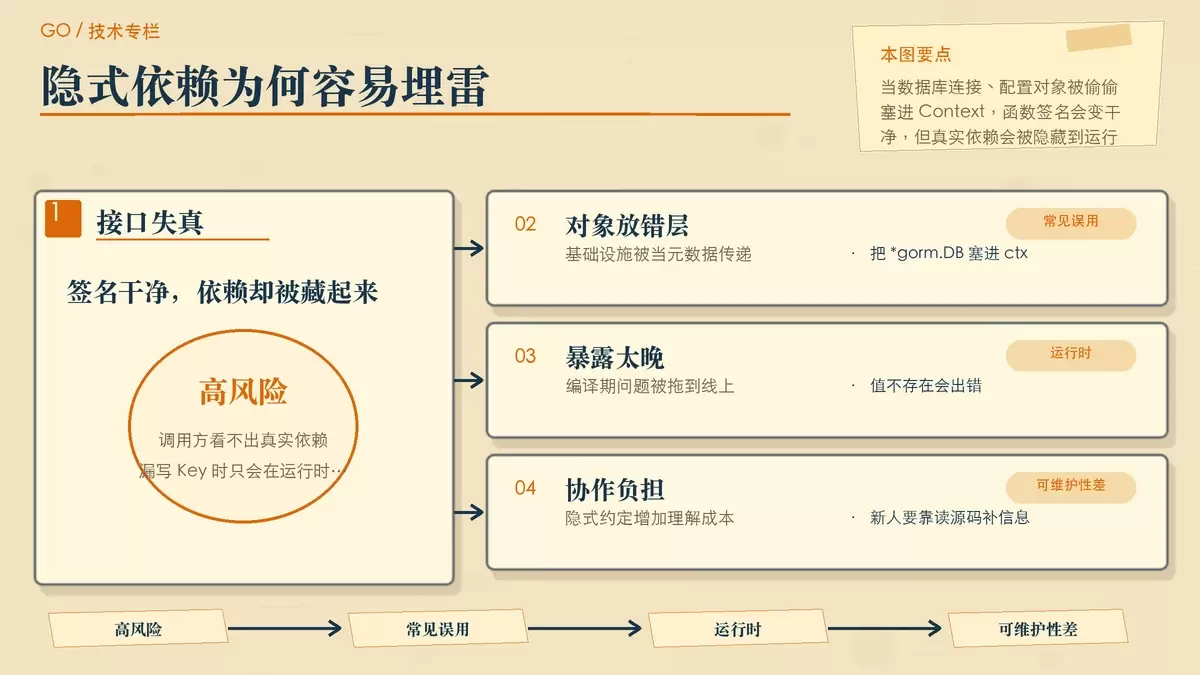
`context.Value` 常被拿来偷渡数据库连接、配置和业务参数,表面省事,实际把依赖隐藏进运行时。本文围绕 Go 中最常见的两类问题展开:类型断言导致的 panic,以及字符串 Key 冲突;再给出私有 Key 与强类型封装的可落地写法,并说明哪些数据该放进 Context。
2026-08-25
37
`context.Value` 常被拿来偷渡数据库连接、配置和业务参数,表面省事,实际把依赖隐藏进运行时。本文围绕 Go 中最常见的两类问题展开:类型断言导致的 panic,以及字符串 Key 冲突;再给出私有 Key 与强类型封装的可落地写法,并说明哪些数据该放进 Context。
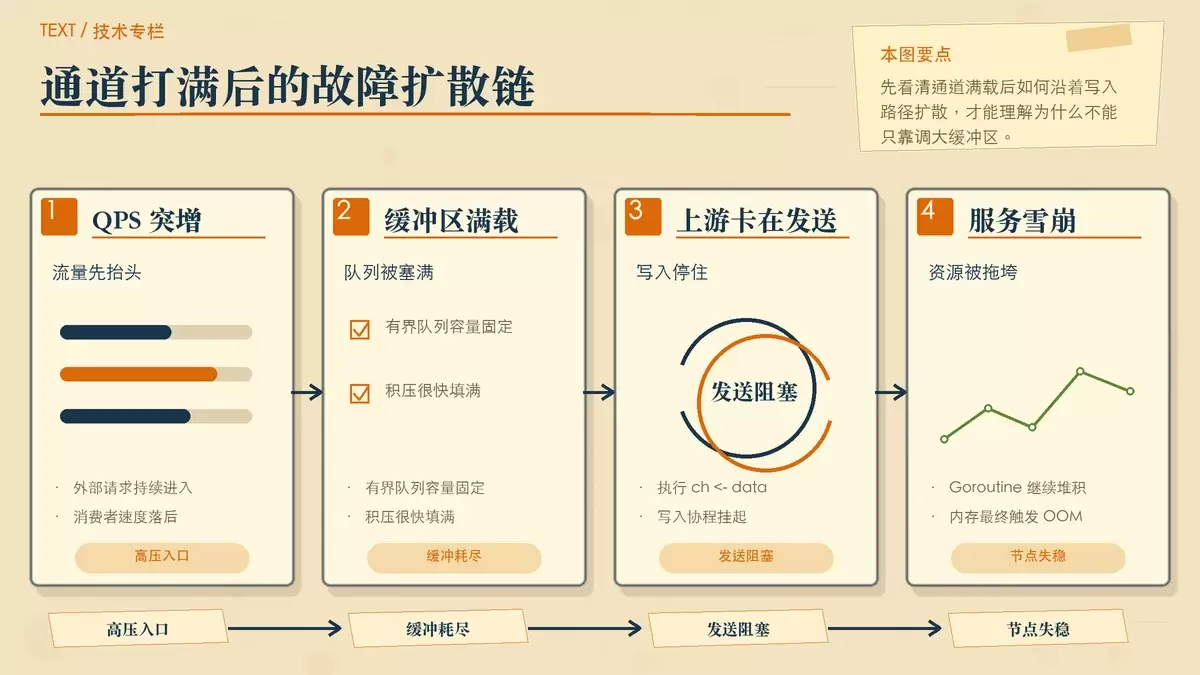
Go 服务里最危险的并发问题之一,不是队列慢,而是有界 Channel 被打满后把写入协程整批卡住。本文从阻塞根因、Go 对非阻塞发送的快速路径优化、业务层封装方式,到失败后的落盘补偿与监控防线,梳理一套更适合线上高并发场景的处理思路。
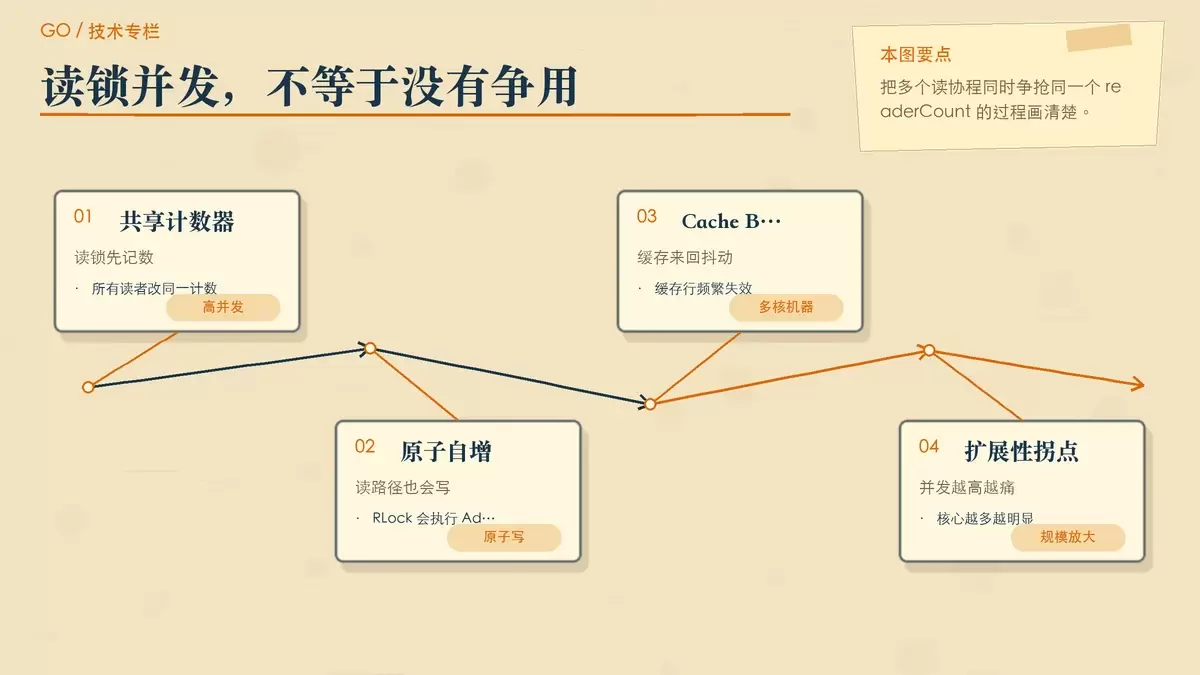
读多写少并不等于可以直接把互斥锁换成 `sync.RWMutex`。在高并发和多核环境下,读写锁的读路径同样要做原子写入,既可能引发缓存抖动,也会在写入到来时让新读请求排队。本文结合 Go 1.19+ 的实现细节,说明 `RWMutex` 何时有效、何时退化,以及 `atomic.Value` 在极端读多写少场景中的工程替代方案。
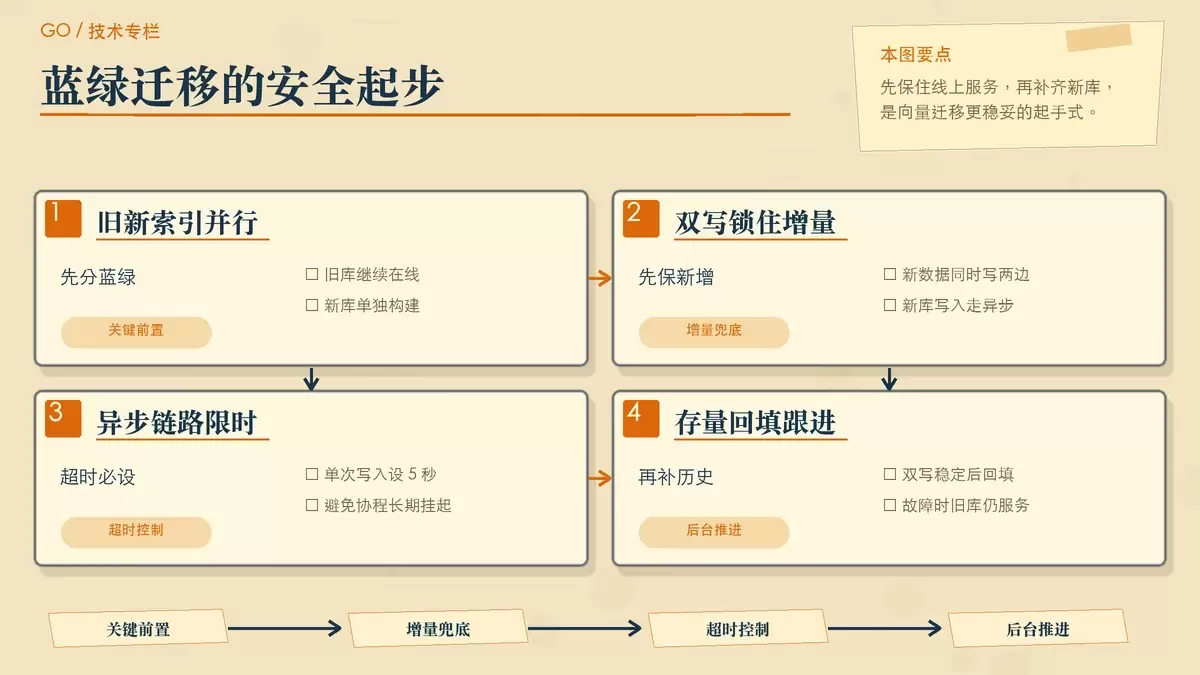
Embedding 模型一旦更换,旧向量就不再处于同一坐标系,直接迁移库文件并不能解决问题。本文结合 Go 实战,拆解向量数据平滑重构的关键做法:双写兜底、流式回填、并发限速、向量库写入优化,以及切换前的效果校验。
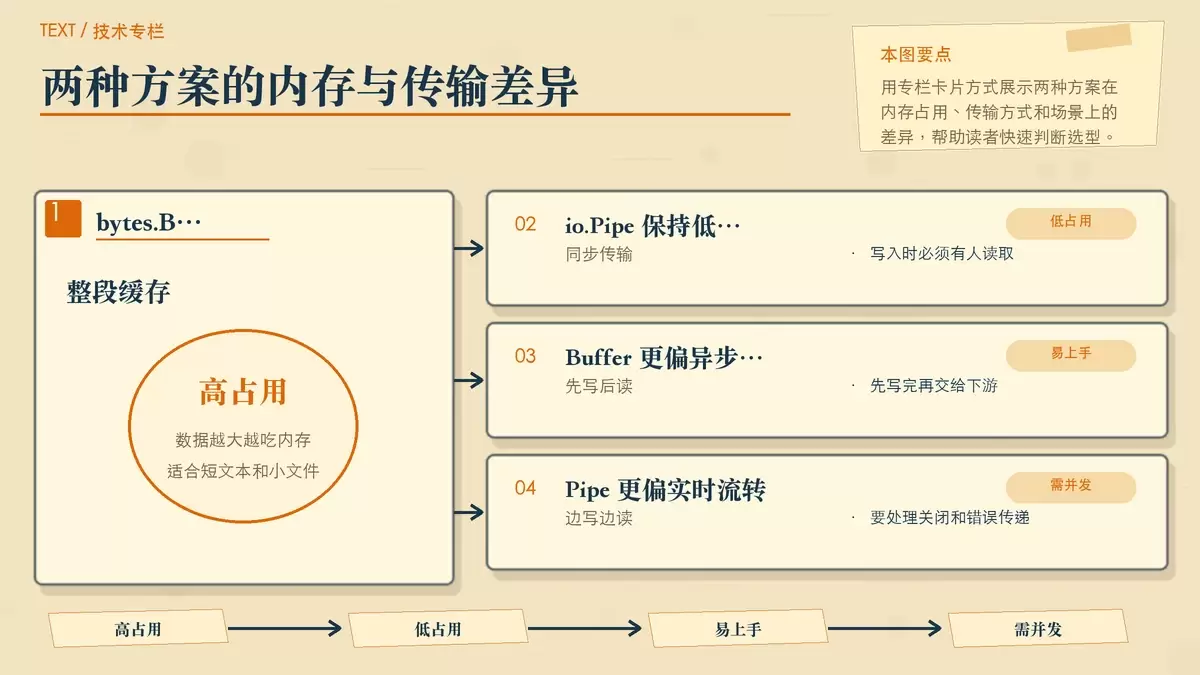
在 Go 中把一个 io.Writer 的输出接到 io.Reader,很多人会先想到 bytes.Buffer。但数据一旦上到 GB 级,缓存整段内容很容易把内存顶满。本文围绕 io.Pipe 的同步管道机制,梳理它的工作方式、常见死锁原因、错误传递方法,以及它和 bytes.Buffer 的适用边界。
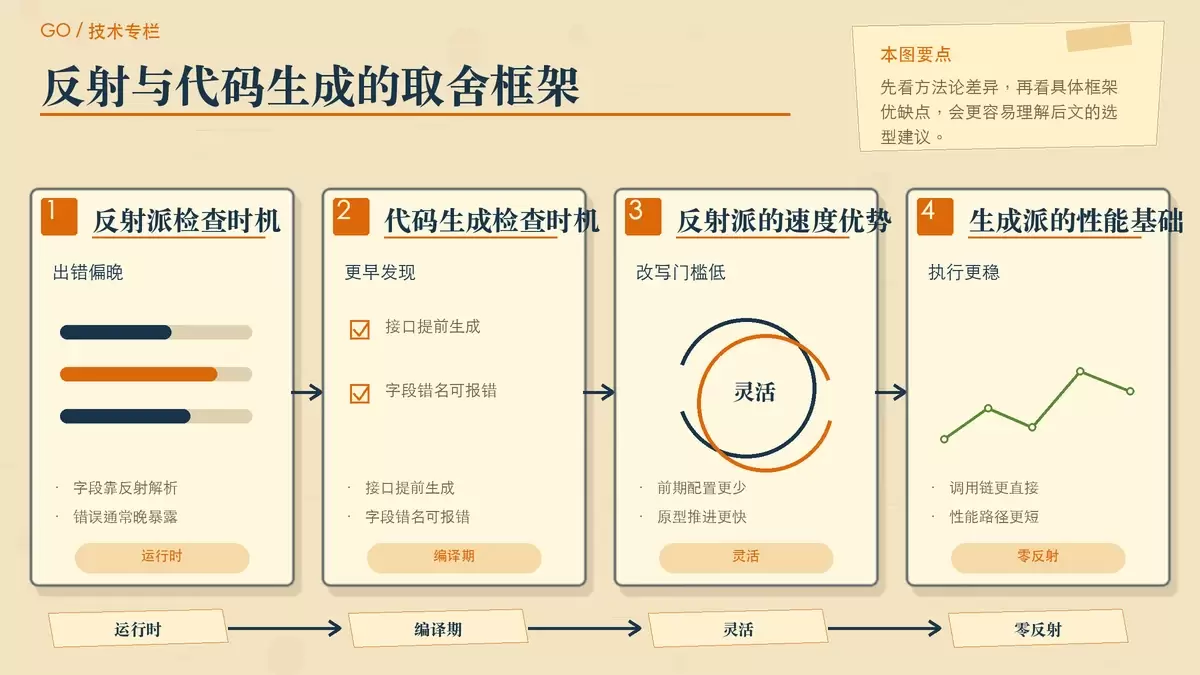
Go 数据库框架的争论,核心已经不只是 API 好不好用,而是运行时反射与编译期代码生成两条路线的取舍。把 GORM、Ent、SQLC 放到同一业务场景里比较后,可以更清楚地判断:你到底更需要上线速度、重构安全,还是对 SQL 与性能的绝对掌控。
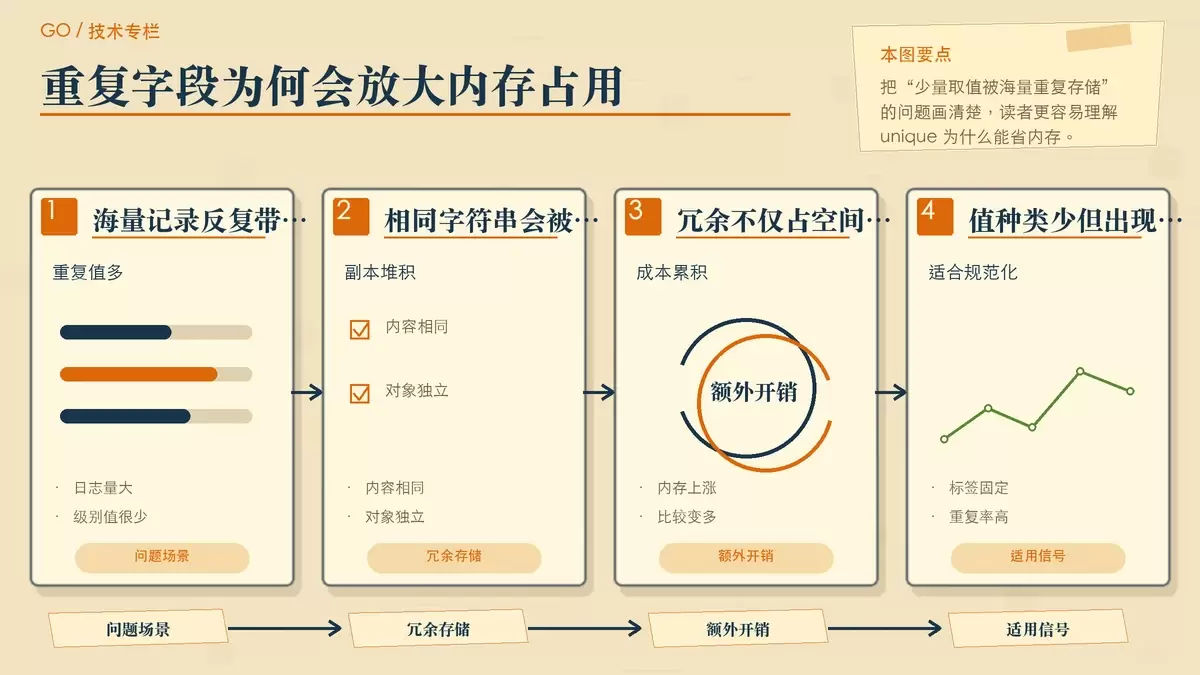
Go 1.23 引入的标准库包 `unique`,把过去常见但容易踩坑的值去重做成了官方能力。它适合重复值很多、比较频繁的场景,既能减少冗余内存占用,也能把等值判断从字符串比较转成更轻量的句柄比较。
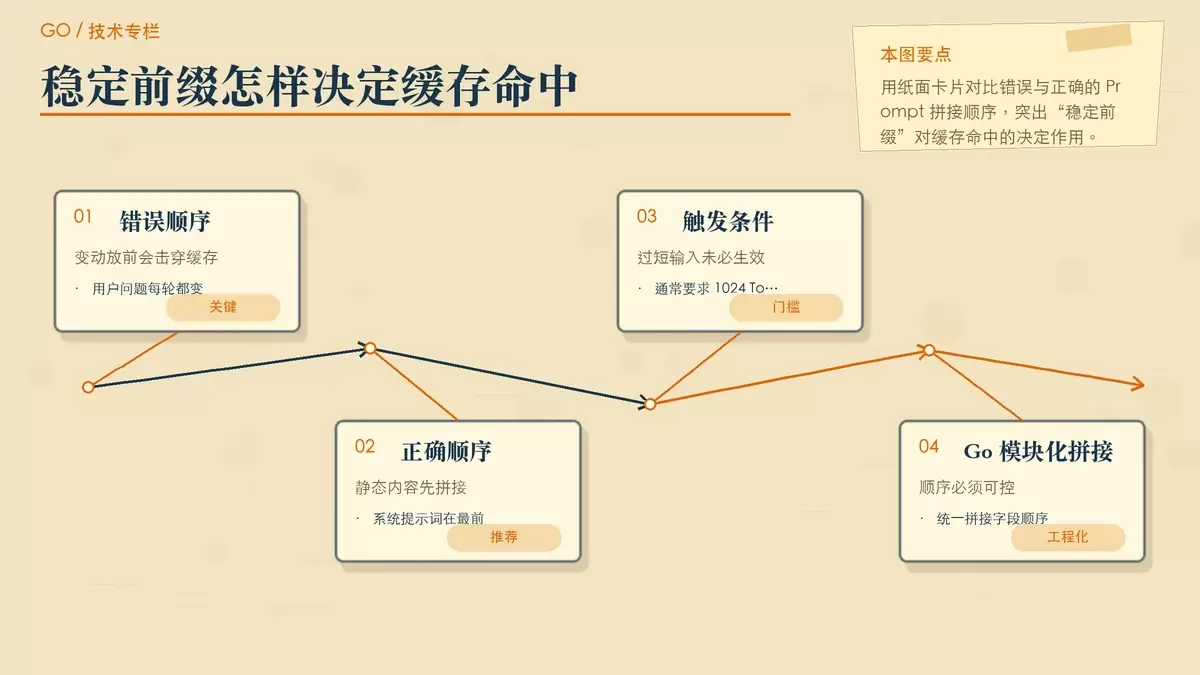
Prompt Caching 已经从“可选优化”变成 AI 后端的常规能力。对 Go 开发者来说,真正影响成本和延迟的,往往不是模型参数,而是 Prompt 顺序、动态字段位置、RAG 排序稳定性,以及是否把缓存逻辑封装进请求结构。
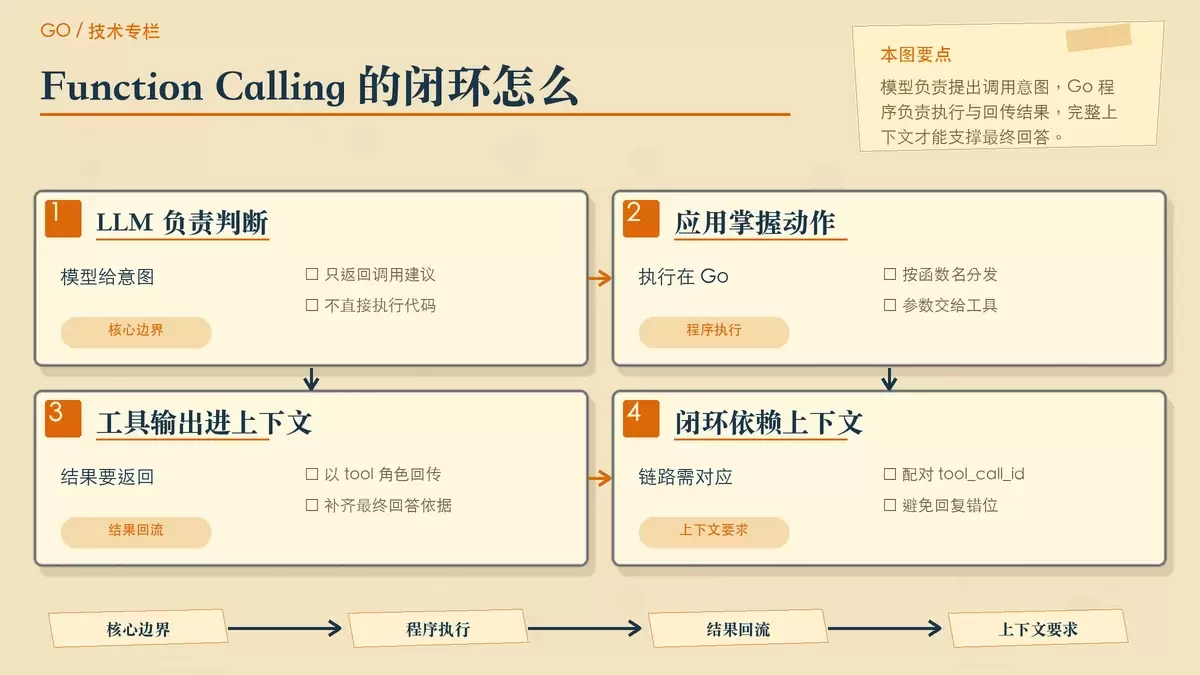
Function Calling 解决的不是模型会不会“思考”,而是它能不能安全、可靠地把意图交给程序执行。本文用 Go 语言拆解这一机制的关键环节:工具描述、函数分发、参数校验、结果回传,以及并发和权限控制该怎么落地。
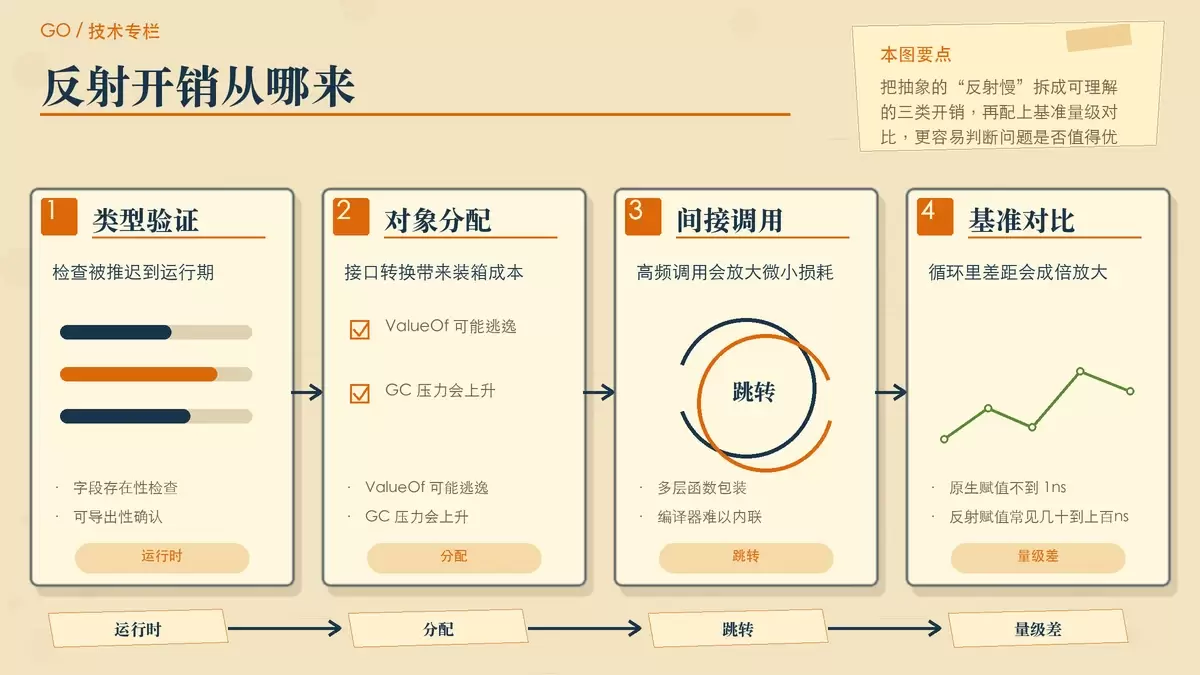
Go 反射的代价主要来自运行时类型检查、对象分配和间接调用,但它并不等于“不能用”。这篇文章按性能瓶颈、基准差距、缓存优化、减少分配、unsafe 与代码生成几条路径展开,帮助你判断什么时候该保留反射,什么时候该换成更直接的方案。
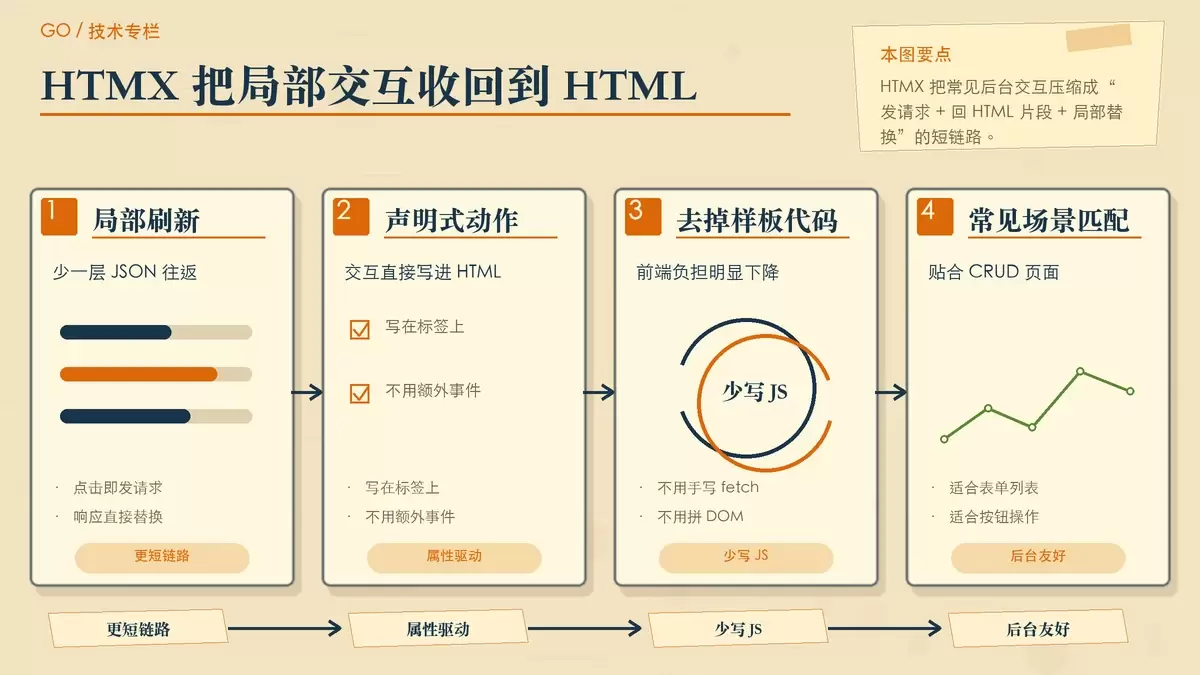
对很多独立开发者和 Go 后端工程师来说,真正拖慢后台项目的,往往不是业务本身,而是前端工程体系的额外复杂度。Go + HTMX + Templ 这套组合的价值,在于用服务端返回 HTML 片段取代大量 JSON 与手写 JS,把交互、模板和后端逻辑重新收拢到一条更短的链路里。
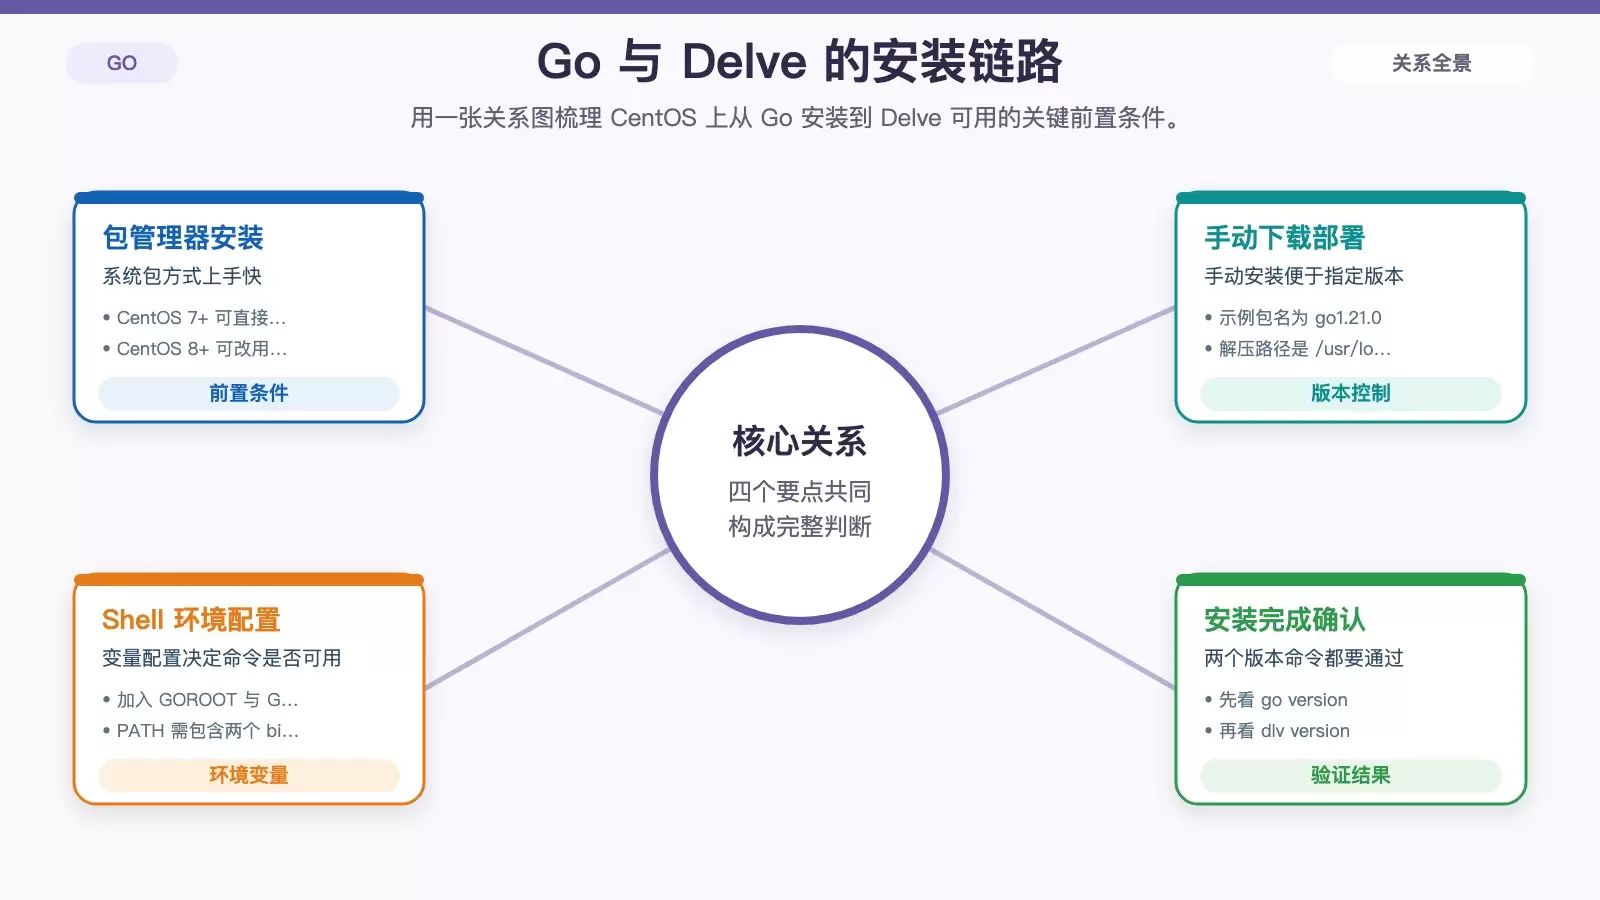
这篇文章把 CentOS 上搭建 Go 调试环境的流程压缩成一条清晰路径:先装好 Go,再安装 Delve,接着编译可调试二进制,最后分别说明本地调试、VS Code 接入和远程调试。文中也补充了 Delve 安装失败、无法单步进函数、IDE 找不到工具等常见问题的处理办法。