Go 原生模糊测试 Fuzzing 让 bug 无处遁形
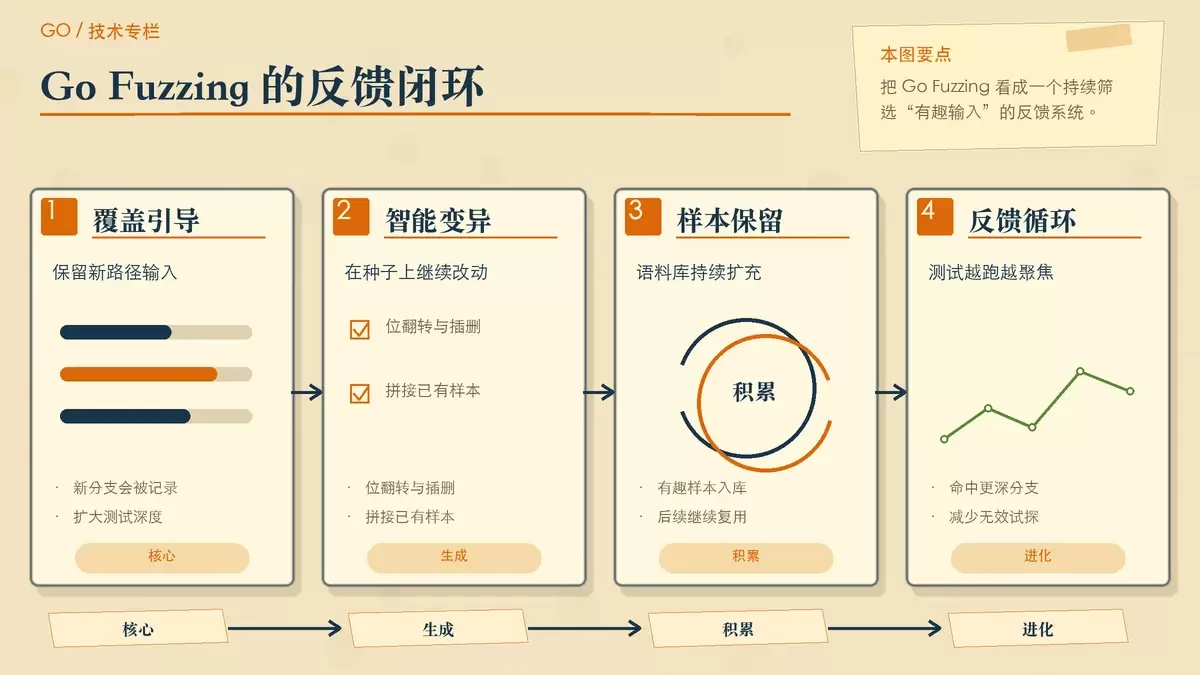
Go 1.18 把模糊测试直接带进了标准库 testing,重点不是替代单元测试,而是用海量随机、畸形输入去撞出你没预设到的边界问题。本文结合字符串反转示例,讲清它的工作机制、写法、报错原因和适合落地的场景。
2026-08-25
167
Go 1.18 把模糊测试直接带进了标准库 testing,重点不是替代单元测试,而是用海量随机、畸形输入去撞出你没预设到的边界问题。本文结合字符串反转示例,讲清它的工作机制、写法、报错原因和适合落地的场景。
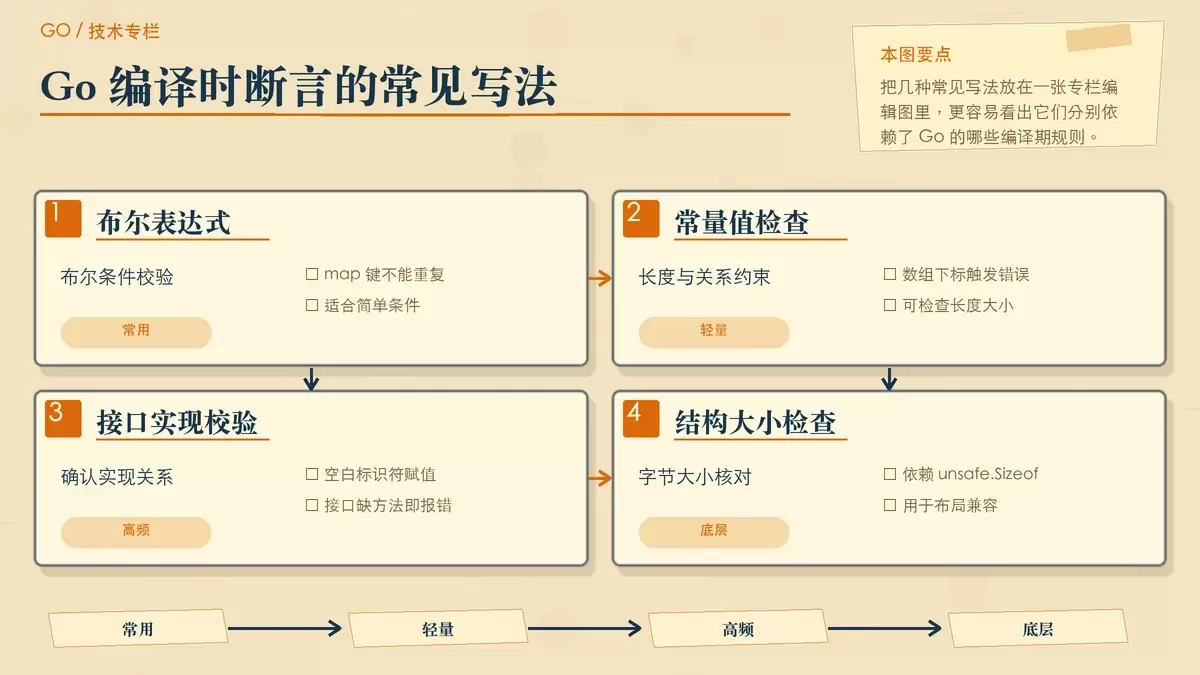
Go 没有专门的“编译时断言”关键字,但开发中依然可以借助常量、数组、接口赋值和 unsafe.Sizeof 等语言特性,把一部分错误拦在编译阶段。本文按常见问题拆解几种实用写法,并说明它们各自适合解决什么问题。
GoLand 代码提示变慢,多数不是 Go 语言本身的问题,而是索引器反复解析模块、插件或系统服务干扰造成的。文章按排查优先级整理了重刷索引、调整 gopls、处理 Windows 11 服务影响,以及大型项目拆包优化四类办法,方便快速判断瓶颈位置。
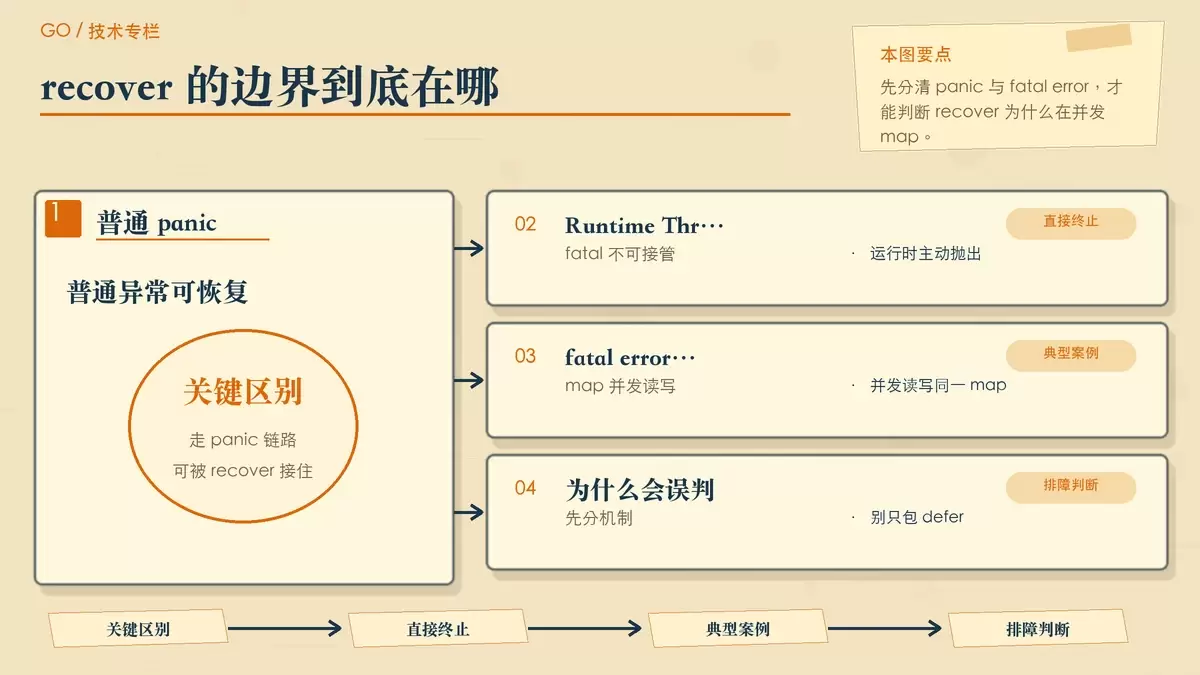
很多人把 `recover()` 当成 Go 的通用兜底手段,但它并不能拦住所有运行时错误。以 `fatal error: concurrent map read and map write` 为例,这类问题属于 Go 运行时直接抛出的致命错误,不走 `panic/recover` 流程。理解这一区别,才能正确判断该靠异常恢复,还是该从并发设计上解决问题。
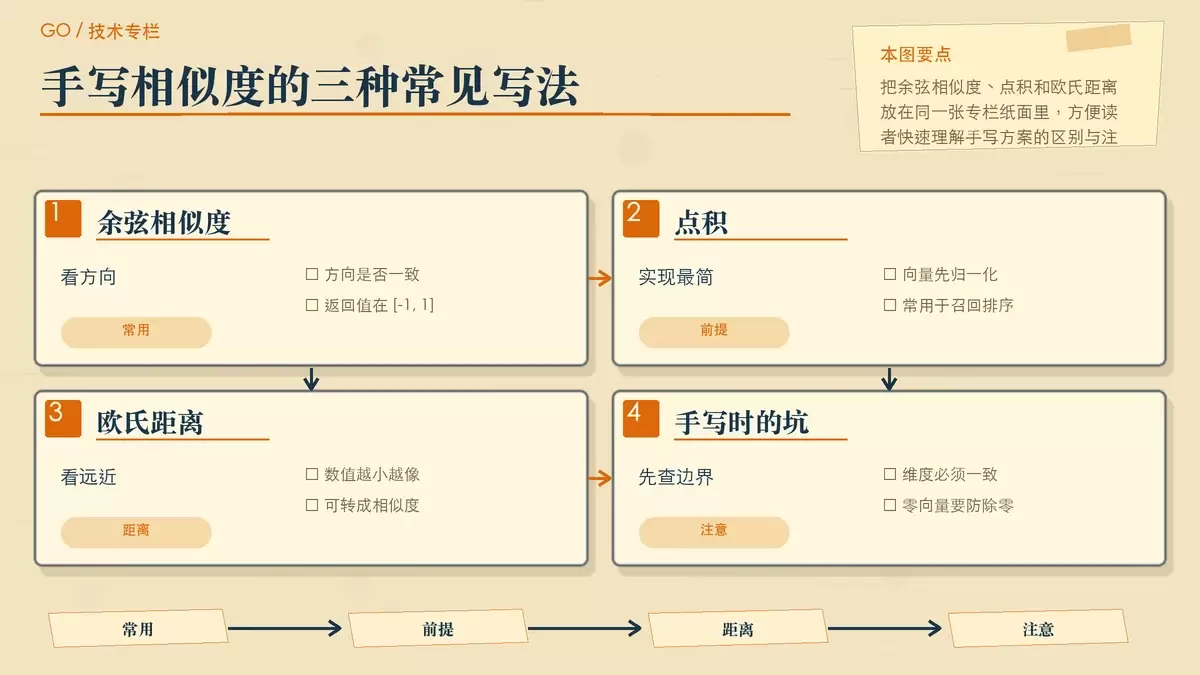
在 Go 里计算向量相似度,常见路径并不止一种。小规模数据可以直接手写余弦、点积和欧氏距离;需要批量计算和更高性能时,适合交给 gonum 这类数值库;当规模进入十万到百万级,并且要做 ANN 检索时,更实际的做法是接入向量数据库。
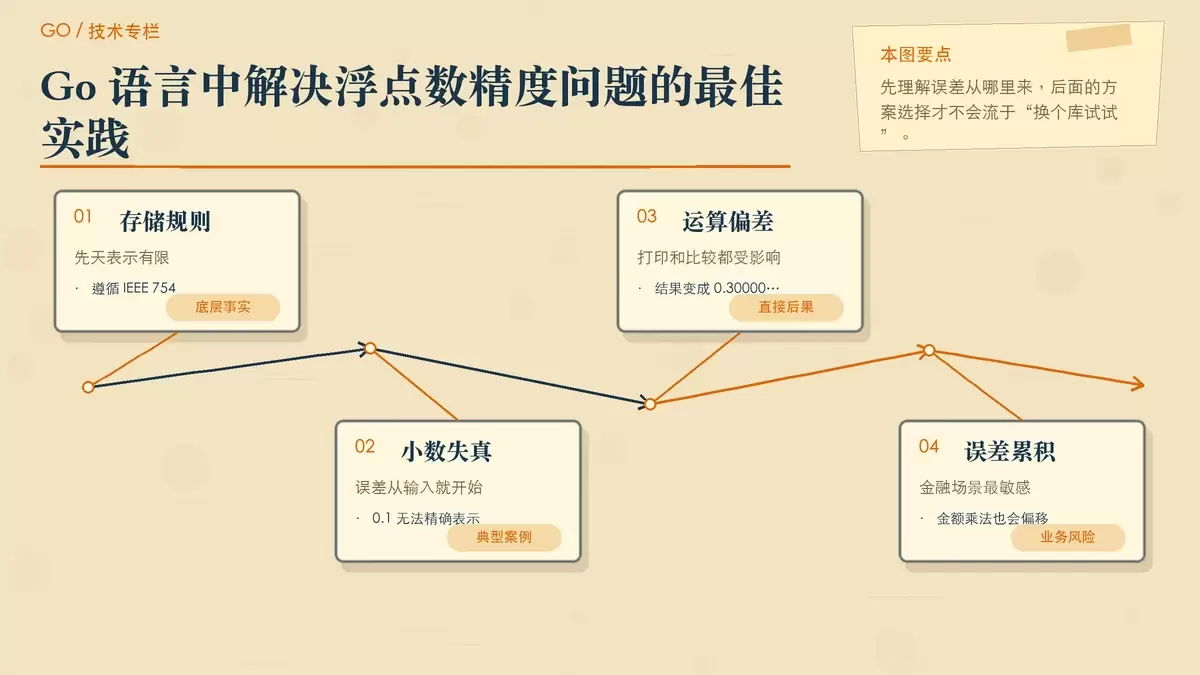
Go 里的浮点数精度问题并不是语言缺陷,而是 IEEE 754 二进制表示的天然结果。本文从 0.1 + 0.2 为什么失真讲起,再结合金额计算、精确比较和数据库设计,梳理整数、decimal、math/big 与误差比较四种常见方案的适用边界。
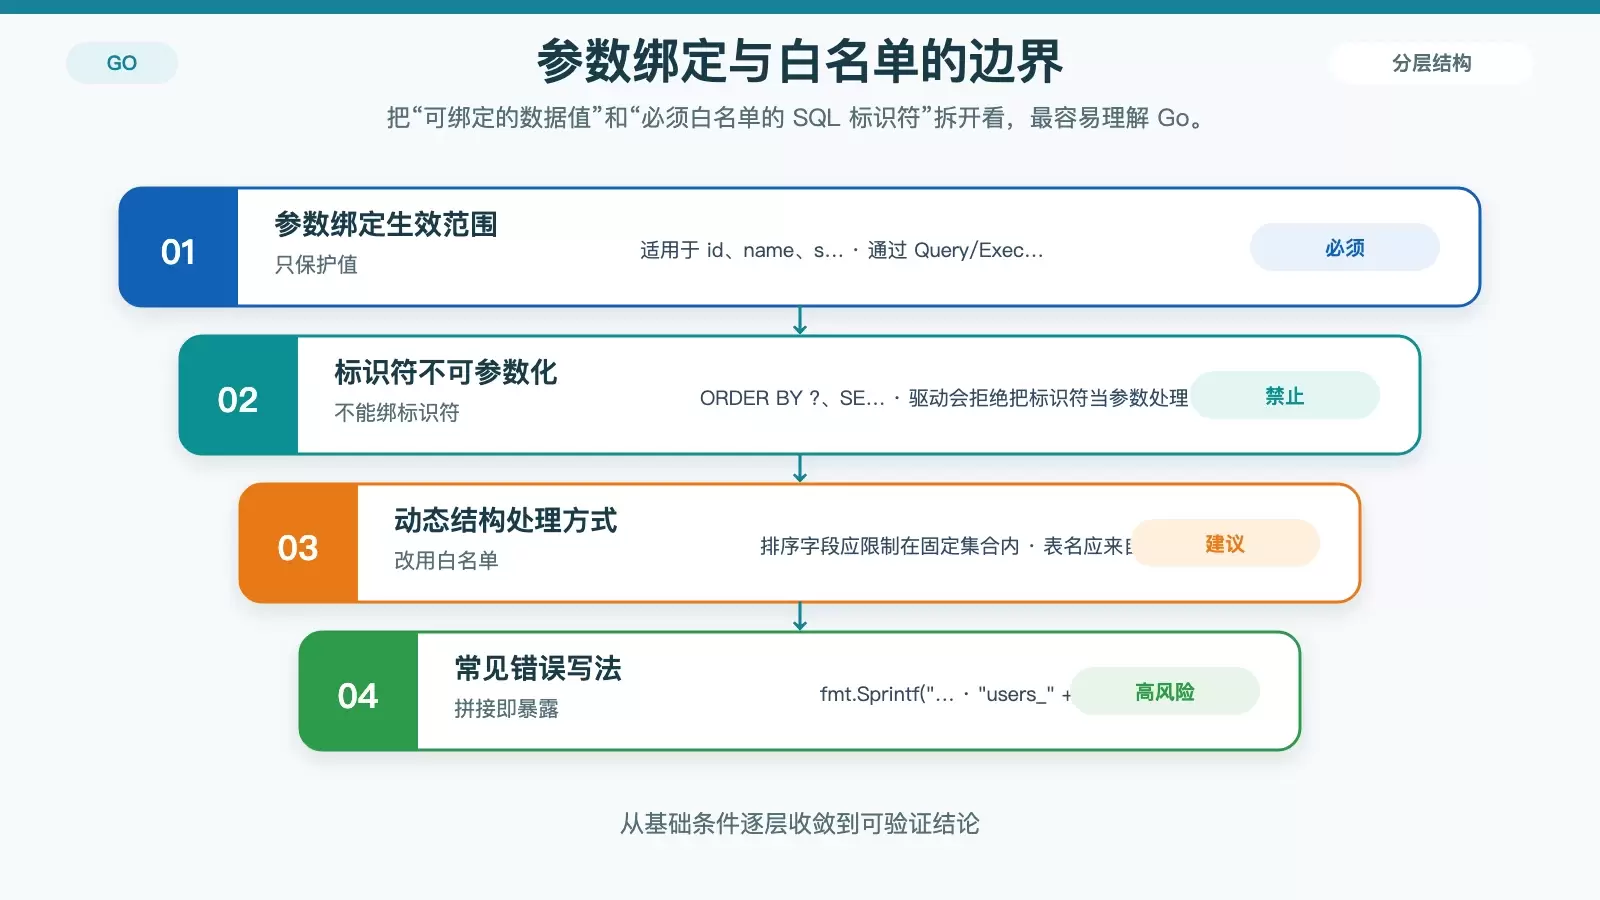
在 Go 1.22 项目里防 SQL 注入,关键不是只会写 `?`,而是同时把“参数绑定”和“标识符白名单”两件事做好。本文结合 `database/sql`、GORM 和 `Scan` 的常见误区,梳理哪些场景能参数化、哪些必须白名单校验,以及报错出现时该如何定位。
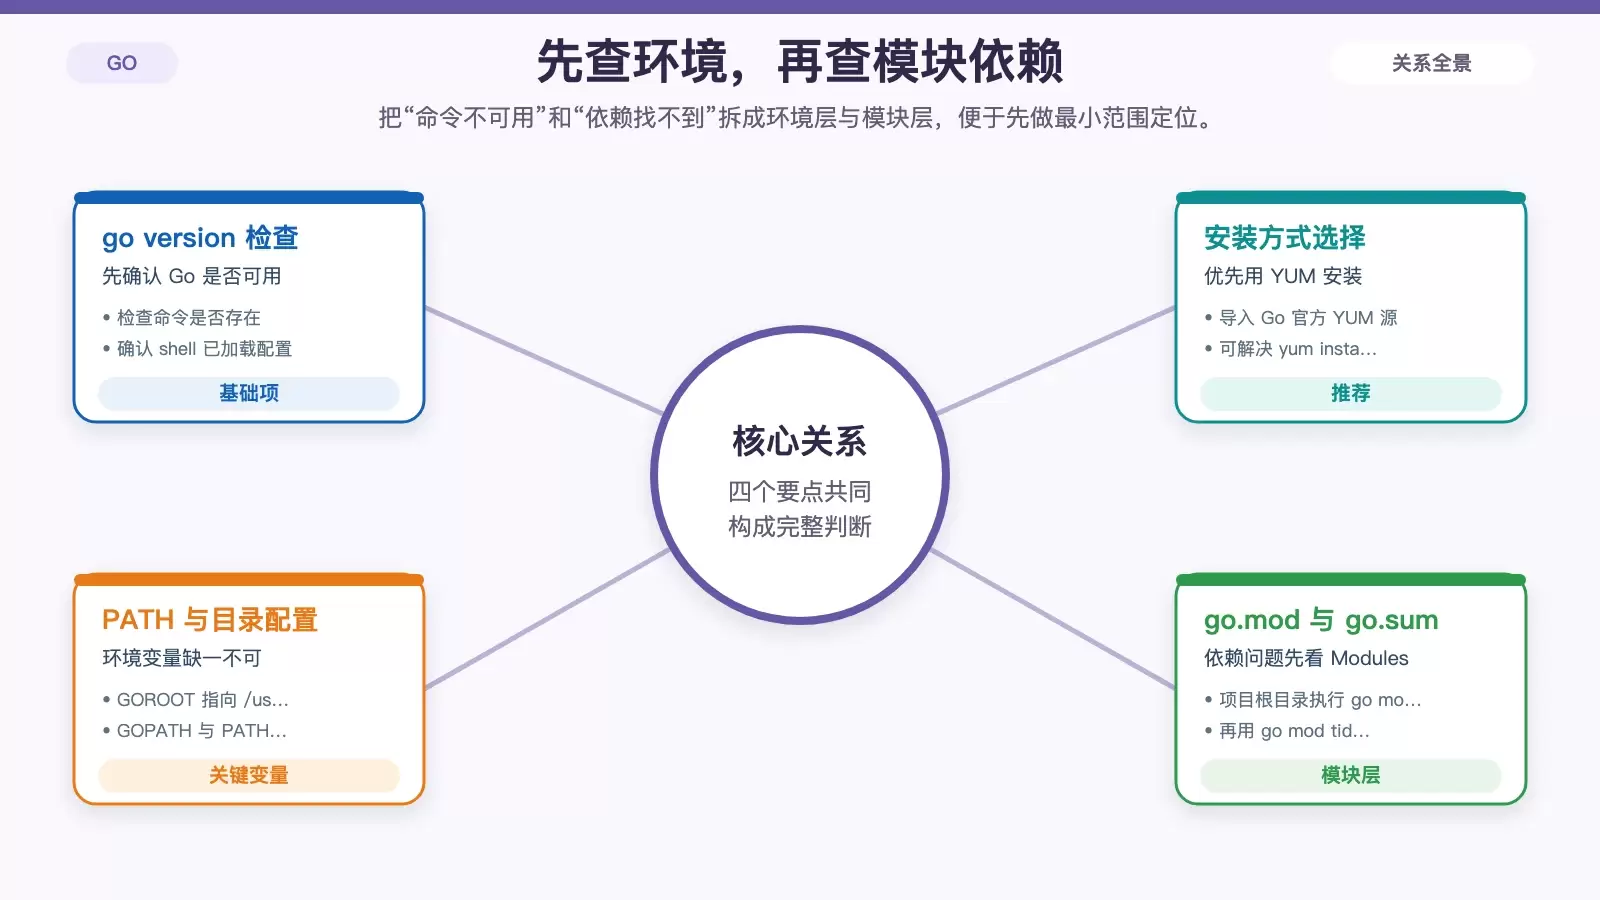
在 CentOS 上打包 Go 程序,常见报错大多集中在环境未装好、模块依赖缺失、系统库版本不匹配以及目标平台设置错误。本文按报错现象拆解排查思路,并保留可直接执行的命令,方便你快速判断问题出在哪一层。
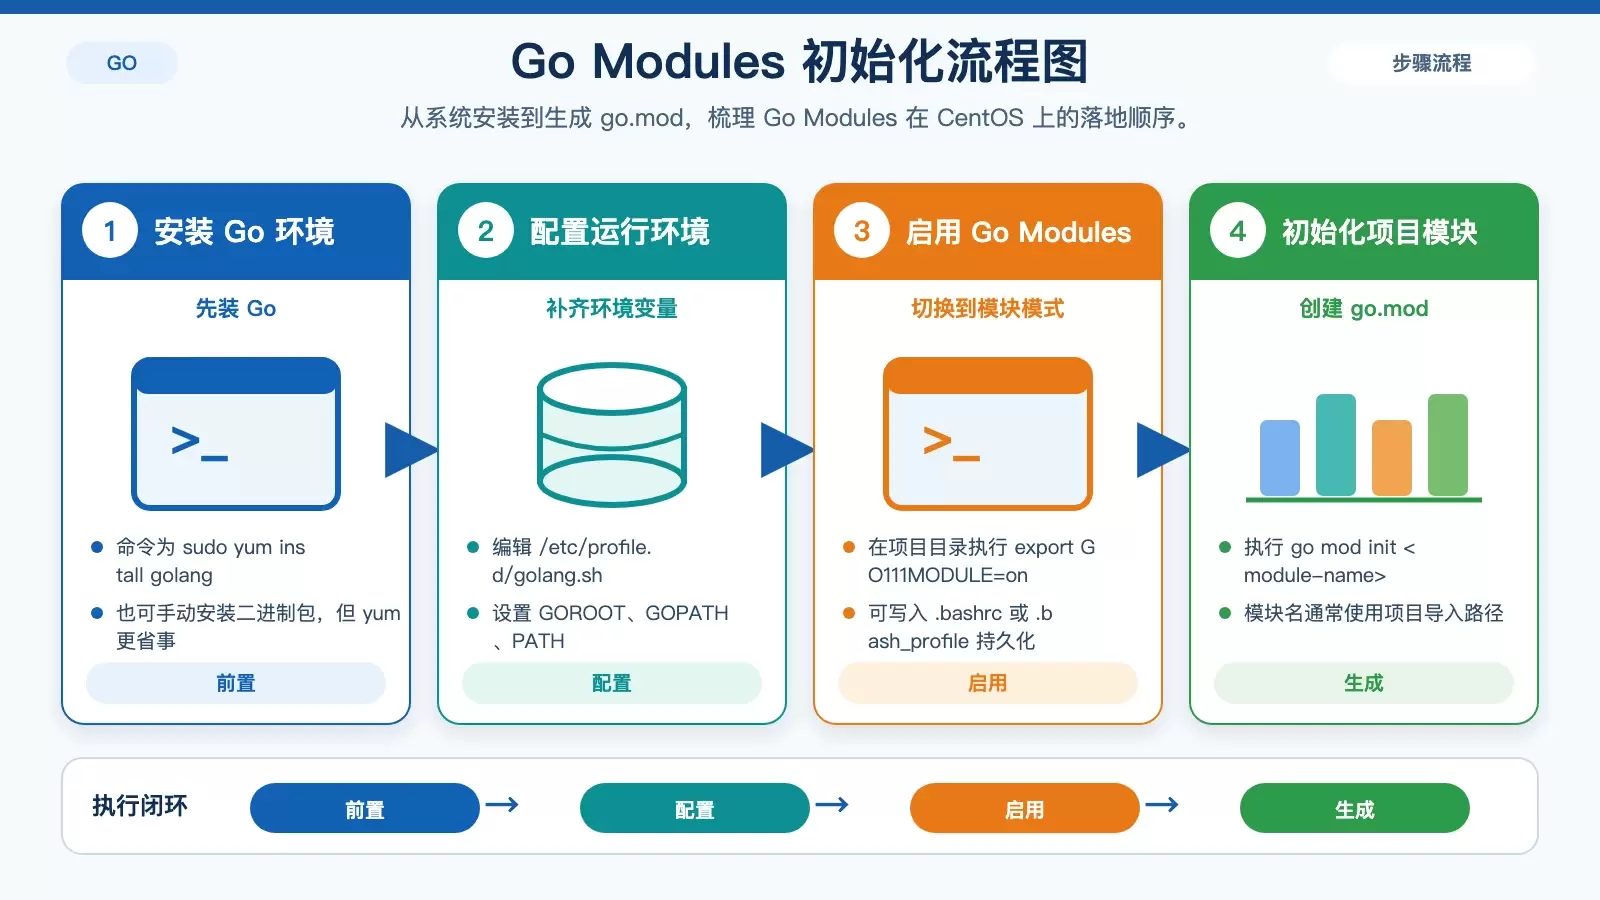
这篇文章围绕 CentOS 下的 Go 依赖管理展开,按安装、环境配置、模块初始化、依赖维护几个关键环节梳理 Go Modules 的基本用法。文中保留了原始命令,并补充了各步骤的作用与适用场景,方便快速上手。
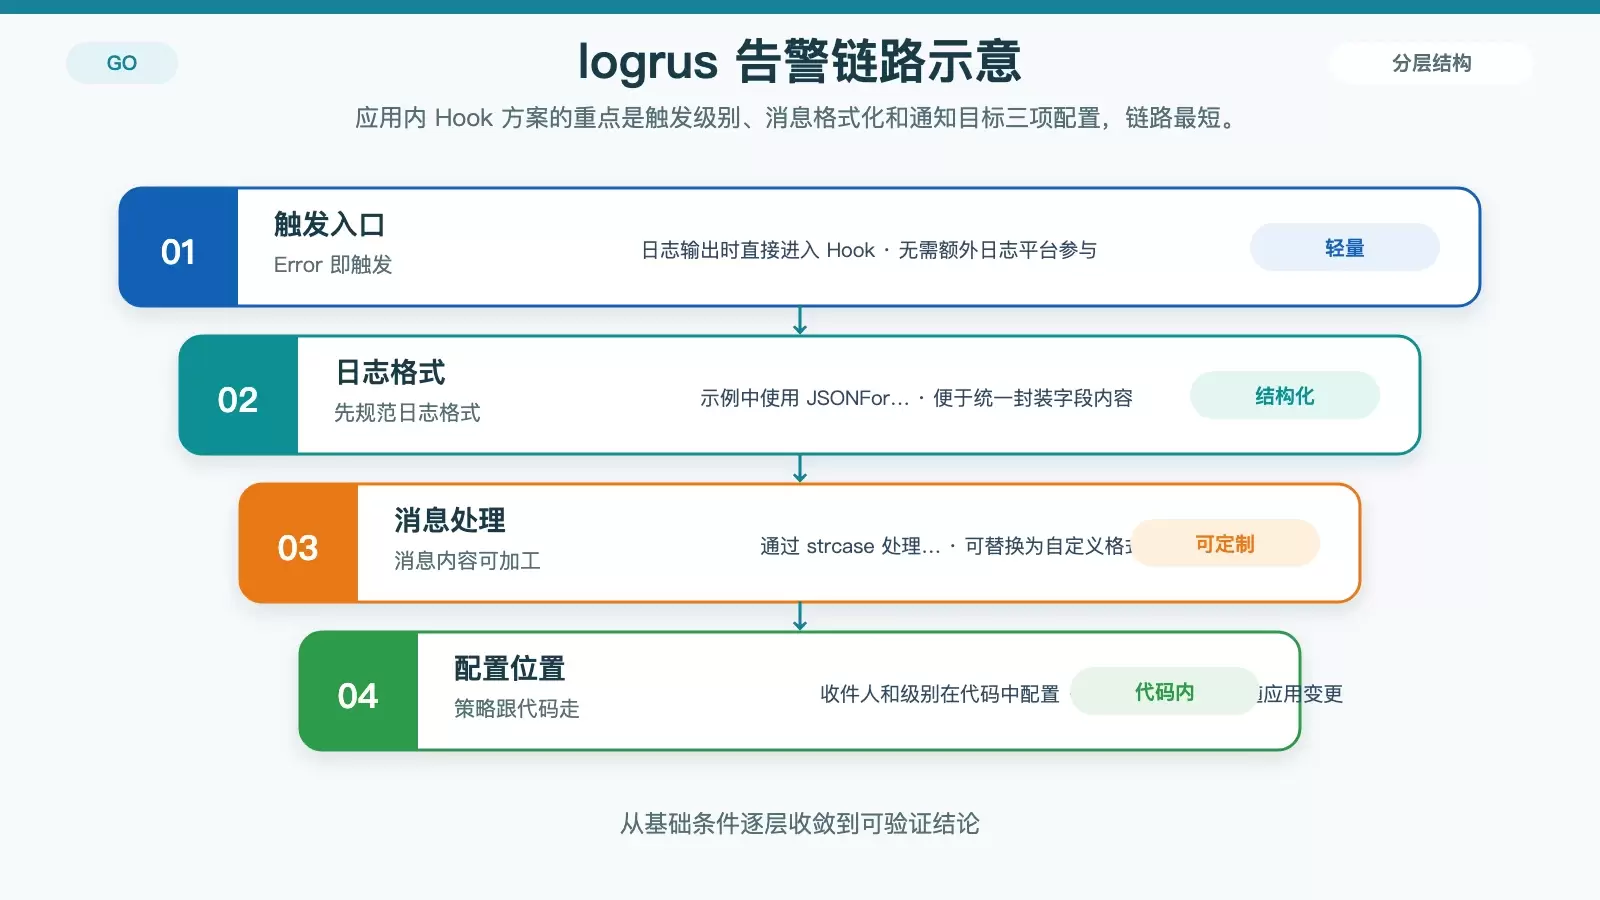
在 CentOS 上为 Go 应用做日志告警,常见路线主要有三类:直接用日志库 Hook 触发通知、把日志接入 Logstash 等外部平台、或由 monit 这类系统工具监控日志文件。三种方式的差别,核心在于接入成本、可扩展性和对业务代码的侵入程度。
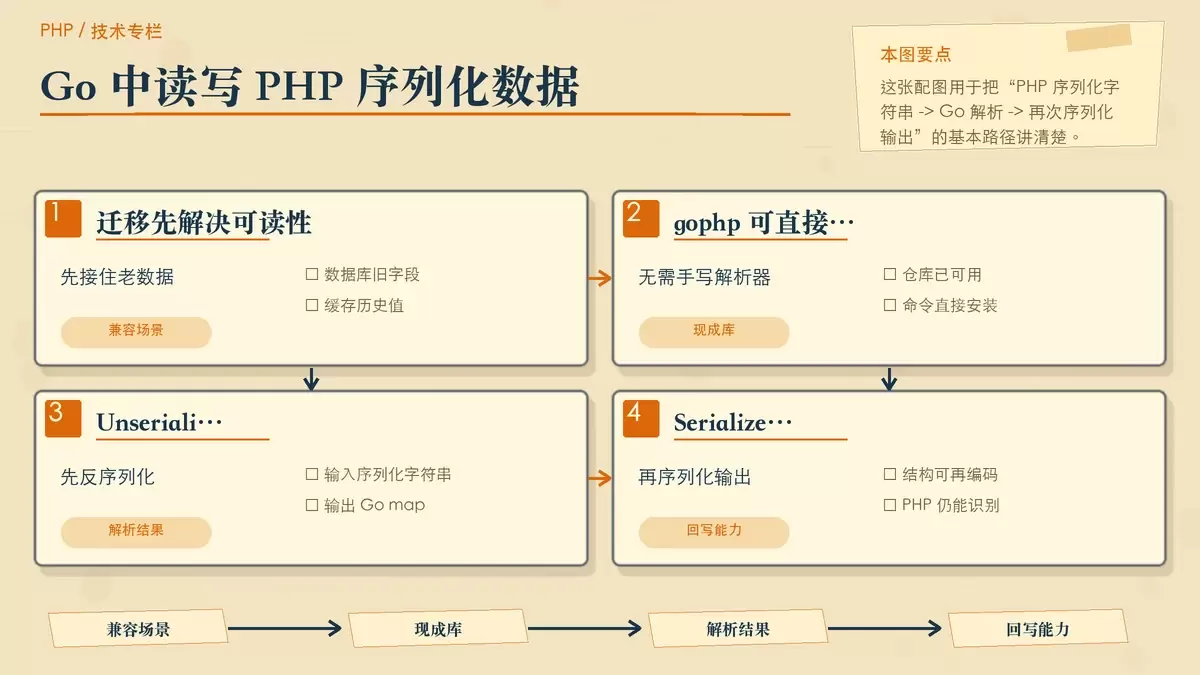
当 PHP 项目迁移到 Go 时,历史数据里常见的 `serialize()`/`unserialize()` 往往会成为兼容点。本文从 PHP 序列化规则入手,结合 `github.com/leeqvip/gophp` 的现成方案,说明 Go 里怎样直接解析和生成 PHP 序列化字符串,以及跨语言场景下该如何选择更稳妥的序列化格式。
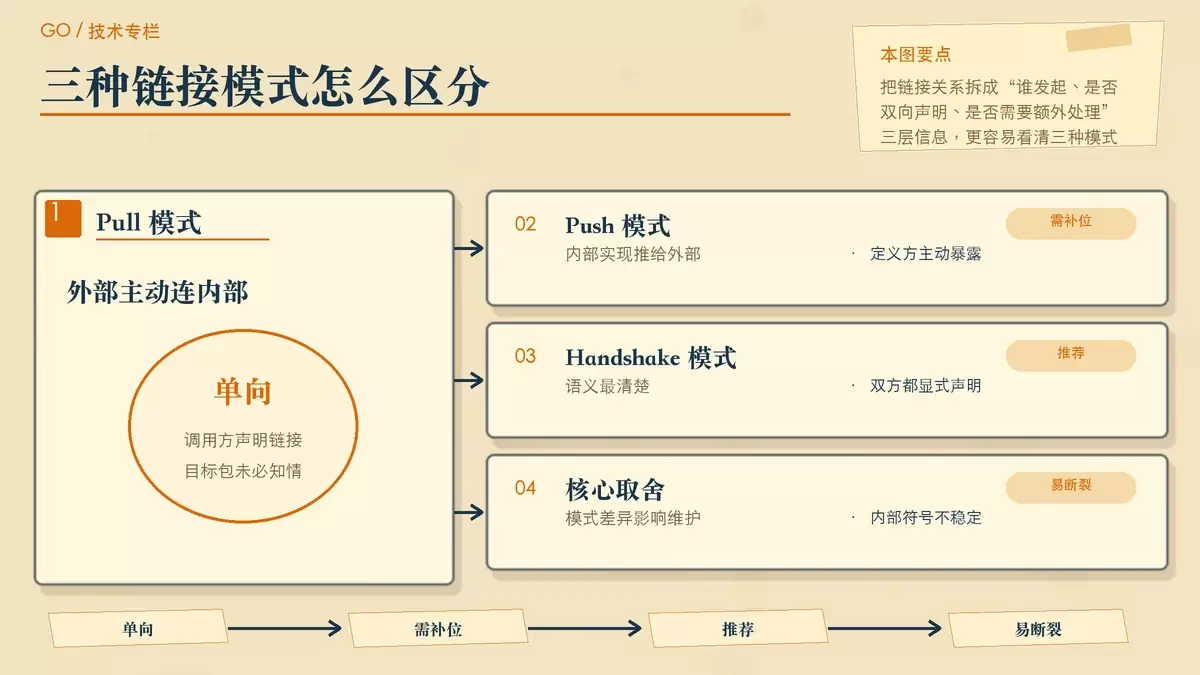
`//go:linkname` 是 Go 提供的一条非常规编译指令,能把当前包符号直接绑定到另一个包的函数或变量,甚至包括未导出符号。它常见于标准库和底层优化场景,但会破坏封装并引入明显的版本与维护风险,理解它的适用边界比会写语法更重要。