


在 CentOS 环境里部署 Go 应用后,日志告警往往是最先要补上的一环:报错有没有被及时发现,直接决定了故障处理速度。本文把常见的三种实现方式拆开讲,包括日志库内置告警、外部监控平台接入,以及系统级日志监控,并保留原始命令和示例代码,方便你按现有环境判断哪条路线更合适。
为什么要先分清日志告警方案
同样是“日志报错后发通知”,不同做法的落点并不一样。
- 应用内告警:实现快,适合项目规模不大、希望尽快上线。
- 外部平台告警:更适合集中管理、统一检索和复杂规则配置。
- 系统级监控:不改应用代码,适合运维直接接管。
如果你现在就是要在 CentOS 上给 Go 服务补一套可用的错误告警,通常可以从这三类方案里选一条,而不是一开始就搭完整日志平台。
方案一:用日志库自带 Hook 直接触发告警
很多成熟日志库都带有 Hook 机制,例如 logrus、zap。它的思路很直接:当程序输出指定级别的日志,比如 Error 或 Fatal,就立即执行通知逻辑。
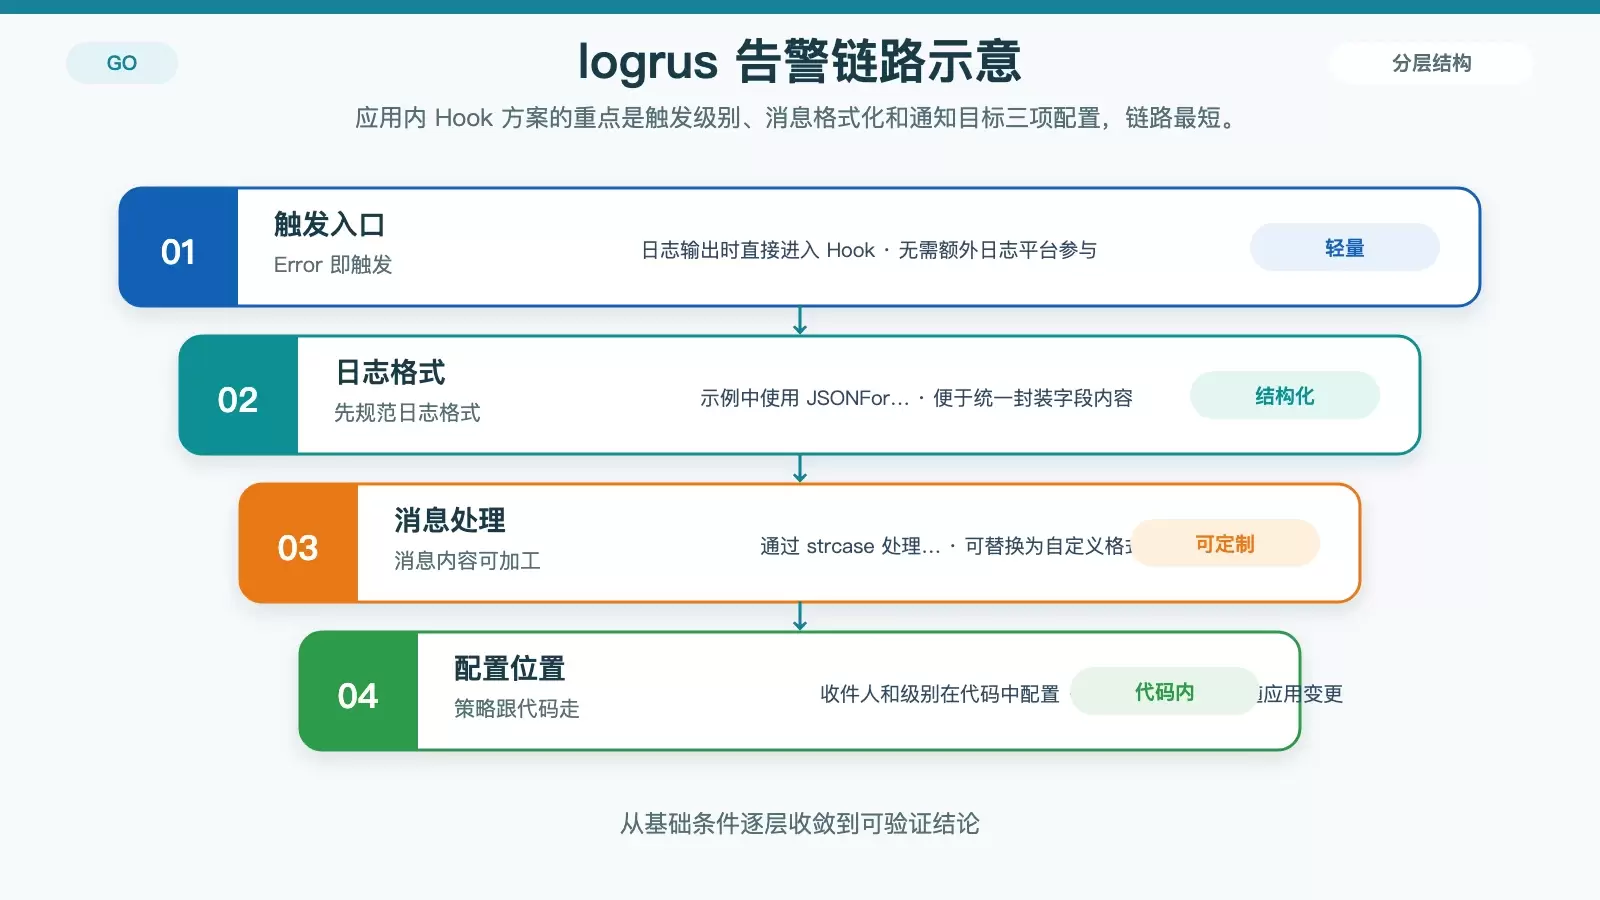
这种方式的优势是链路短、见效快,不需要额外搭建日志采集系统。对于单体服务、小型内部工具或临时性业务,通常是成本最低的做法。
用 logrus 配置邮件告警
原文给出的示例是基于 logrus 的 Email Hook。先安装依赖:
go get github.com/sirupsen/logrus
go get github.com/iancoleman/strcase
然后在代码里注册 Hook,指定发件人、收件人、触发级别以及消息格式化函数:
package main

import (
    "github.com/sirupsen/logrus"
    "github.com/iancoleman/strcase"
    "github.com/iancoleman/strcase/hooks"
)

func main() {
    logrus.SetFormatter(&logrus.JSONFormatter{})
    logrus.AddHook(hooks.NewEmailHook(
        "your-email@example.com",
        []string{"another-email@example.com"},
        "logrus.LevelError",
        "Application Error",
        func(entry *logrus.Entry) string {
            return strcase.ToLowerCamel(entry.Data["message"].(string))
        },
    ))
    logrus.WithFields(logrus.Fields{
        "animal": "walrus",
        "size":   10,
    }).Error("A walrus appears")
}
这段代码的关键点有三个:
- 日志格式被设置成了
JSONFormatter,便于后续统一处理。 - Hook 只在
logrus.LevelError级别触发。 strcase被拿来格式化消息内容,你也可以替换成自己的逻辑。
当程序执行到 Error("A walrus appears") 时,邮件就会自动发送出去。
这类方案的限制也很明显:告警策略写在应用里,后续如果要改通知对象、告警阈值或多渠道通知,往往需要重新发版。
方案二:把日志接入外部监控与告警平台
如果你的环境里已经有 Prometheus、Grafana、ELK 之类的平台,或者你希望所有服务的日志和告警都统一管理,那么把日志输出到外部系统通常更合适。
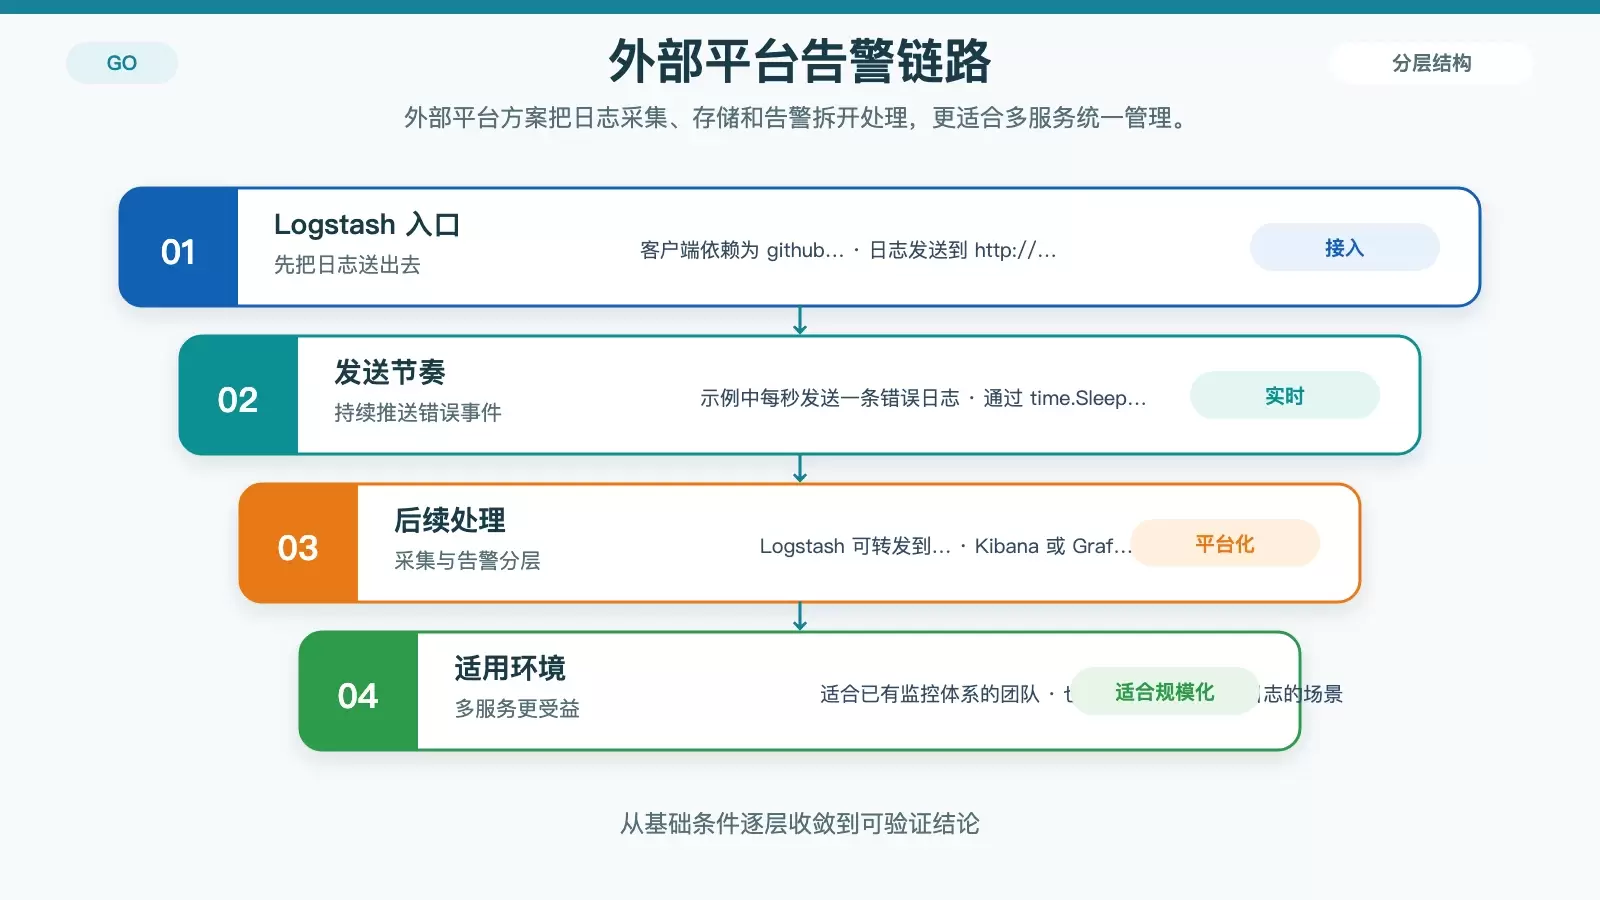
这类方案不是在应用里直接“发告警”,而是先把日志送出去,再由日志平台完成存储、检索、聚合和规则触发。好处是后期扩展性更强,尤其适合多服务、微服务或跨团队协作场景。
示例:把 Go 日志推送到 Logstash
原文示例使用的是 logstash。先安装 Go 客户端:
go get github.com/segmentio/go-logstash
然后把应用日志输出到 Logstash 的 HTTP 端点:
package main

import (
    "github.com/segmentio/go-logstash"
    "log"
    "time"
)

func main() {
    logstashURL := "http://localhost:5000"
    logstashEncoder := logstash.JSONEncoder{}
    logger := log.New(logrus.WriterLevel(), "", log.LstdFlags)
    logstashClient, err := logstash.New(logstashURL, logstashEncoder)
    if err != nil {
        log.Fatalf("Error creating logstash client: %v", err)
    }
    logger.SetOutput(logstashClient)

    for {
        logger.WithFields(logrus.Fields{
            "animal": "walrus",
            "size":   10,
        }).Error("A walrus appears")
        time.Sleep(1 * time.Second)
    }
}
按照这段示例代码,应用会每秒向 http://localhost:5000 推送一条错误日志。后续可以交给 Logstash 转发到 Elasticsearch,再由 Kibana 或 Grafana 配置告警规则。
这套链路更适合以下场景:
- 多个 Go 服务需要统一查看日志。
- 告警规则不只看单条错误,还要做聚合、过滤或趋势判断。
- 运维和开发希望使用同一套监控平台。
需要注意的是,原始示例展示的是接入思路,实际项目里还要确认客户端与日志库的组合是否完整可编译,并根据现网日志结构设计字段和规则。
方案三:用系统级工具直接监控日志文件
如果你不想给应用引入新依赖,或者当前服务不方便改代码,那么系统级告警工具会更实用。它的做法是直接盯住日志文件内容,一旦匹配到异常条件,就触发邮件或其他通知。
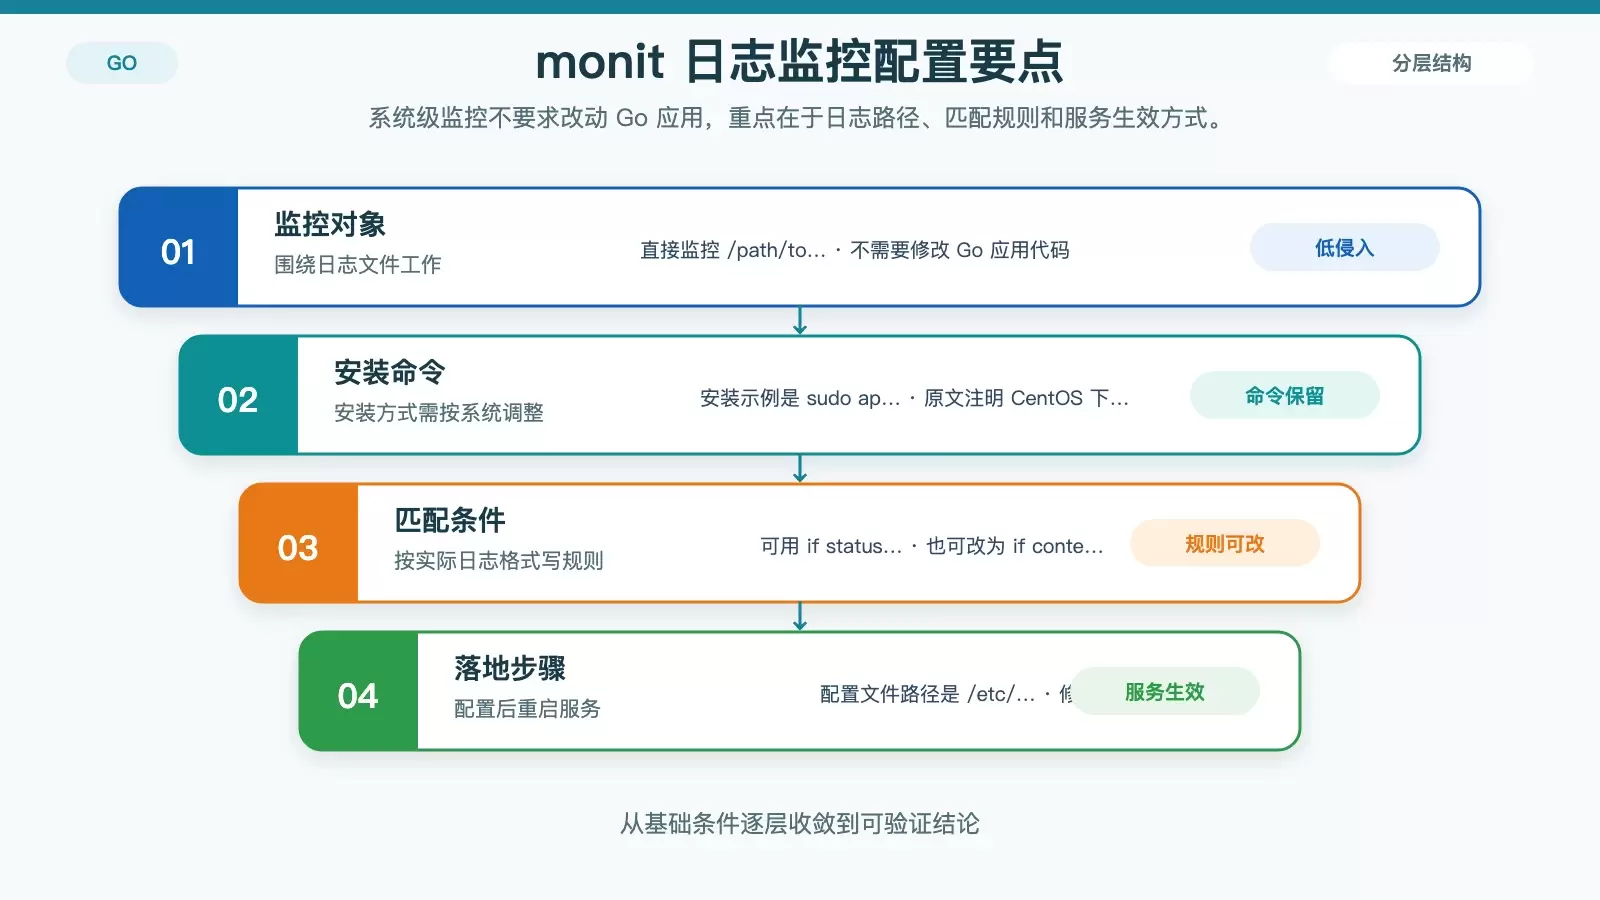
这类方式对应用本身几乎没有侵入,尤其适合由运维团队统一维护的主机环境。
示例:用 monit 监控 Go 应用日志
原文选择的是 monit。安装命令如下:
sudo apt-get install monit # CentOS 下用 yum,但示意命令保留通用性
接着创建配置文件 /etc/monit/conf.d/golang-app.conf:
check file golang-app-log with path /path/to/your/golang/app.log
    if status != 0 then alert your-email@example.com
这里的规则需要结合真实日志格式来调整。原文也提到,你可以换成更贴近日志内容的写法,例如:
if content = "ERROR" then alert
配置完成后,重启服务:
sudo systemctl restart monit
这样一来,只要日志中出现满足条件的内容,monit 就会自动发邮件到指定地址。
它的优点是部署直接、无需改业务代码;缺点是规则表达能力通常不如专业日志平台,复杂去重、聚合和多维分析也比较有限。
CentOS 下到底该选哪一种
如果只看落地成本,这三种方案可以这样理解:
- 日志库 Hook:最轻量,适合小型项目和快速上线。
- 外部监控平台:最适合规模化场景,便于统一管理和扩展。
- 系统级工具:对应用零侵入,适合已有运维体系或不方便改代码的服务。
在 CentOS 场景里,没有绝对通用的“最佳解”,关键还是看你的系统现状:是优先快速可用,还是优先平台化;是开发团队主导,还是运维团队主导。把这几个判断条件想清楚,选型通常就不会偏。









