


单元测试能证明“你想到的情况没问题”,却很难覆盖那些没人预料到的输入:特殊字符、畸形数据、编码边界、异常结构。Go 1.18 开始内置的原生模糊测试,正是拿来补这块短板的。下面就从它为什么有用、底层怎么跑,到一个真实失败示例怎么修,再看哪些 Go 代码最值得优先接入模糊测试。
为什么模糊测试值得补进 Go 测试体系
很多线上问题并不是“主流程写错了”,而是程序遇到了开发时没被认真考虑过的输入。哪怕单元测试覆盖率很高,也依然可能因为一个特殊字符、一个畸形请求,或者一个不完整的数据片段直接崩溃。
模糊测试(Fuzzing)的思路,和传统单元测试有明显区别:
- 单元测试:开发者先给出已知输入,再断言预期输出,适合验证确定性逻辑。
- 模糊测试:自动生成大量非预期、随机、畸形输入,持续尝试触发程序的脆弱路径。
这种方法并不新。1988 年,威斯康星大学的 Barton Miller 教授在一次拨号连接 Unix 的经历中,注意到线路噪声导致输入失真后,程序会频繁崩溃。后续团队系统性验证发现,向程序注入随机噪声数据,确实能稳定暴露出大量未处理的崩溃与挂起问题。模糊测试的核心价值,也由此变得非常明确:它不是验证“正常情况是否正确”,而是验证程序面对“意外情况”是否还能站得住。
换句话说,模糊测试像一个不会疲劳的输入破坏者,专门去找那些你没想到、也没手工列出的分支。
Go 原生 Fuzzing 的核心机制
从 Go 1.18 开始,模糊测试被直接集成进标准库 testing,不需要再额外接第三方工具。这让它在 Go 项目里的接入门槛明显降低。
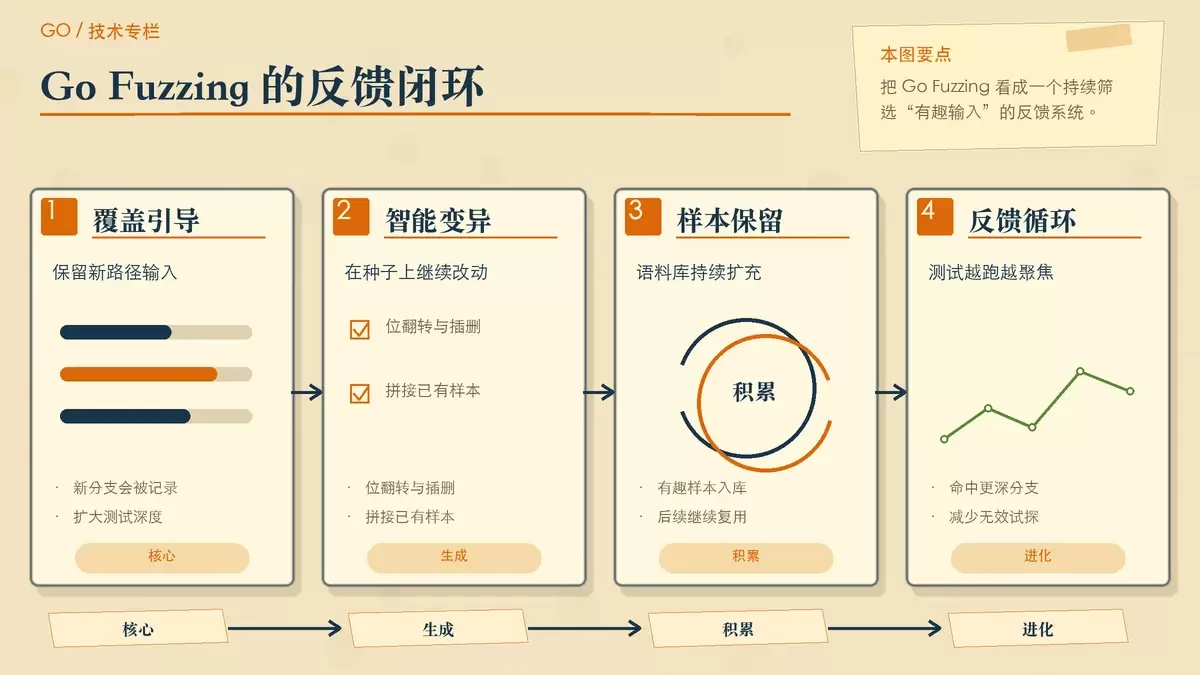
它的工作过程可以拆成三件事来理解。
覆盖引导:优先保留能走到新路径的输入
Go 的模糊测试并不是盲目乱撞。运行过程中,它会通过代码插桩观察输入到底触发了哪些执行路径。一旦某个新输入走到了此前没覆盖到的分支,这个输入就会被视为“有趣”样本,加入语料库,供后续继续演化。
例如第一次种子输入只能覆盖路径 A,后续某个变异输入如果能覆盖路径 A+B,那么它就更有保留价值。
智能变异:在已有输入基础上继续制造新样本
模糊测试通常不会凭空生成所有数据,而是基于已有输入持续变异。常见方式包括位翻转、字节插入、字节删除、数据拼接等。
// 示例:变异器操作(示意图)
原始输入: "Hello" → 变异输入: "Hex00llo"  // 插入空字节
这种做法的意义在于,程序真正容易出问题的地方,往往不是完全随机的数据,而是“接近正常、但又略微异常”的输入。
反馈循环:语料库越跑越有针对性
随着测试推进,语料库会不断吸收那些能触发新路径、边界行为或失败结果的输入。这样一来,后续生成的数据会越来越聚焦于代码的深层分支,而不是停留在表面路径打转。
这也是为什么模糊测试不是一次性扫描,而更像一种持续进化的测试过程。
怎么写 Go 的模糊测试
在 Go 里写模糊测试,形式上和普通测试很接近,同样放在 xxx_test.go 文件中。区别在于,函数名要以 Fuzz 开头,参数类型使用 *testing.F。
先看一个字符串反转函数:
// reverse.go
func Reverse(s string) string {
    b := []byte(s)
    for i, j := 0, len(b)-1; i < len(b)/2; i, j = i+1, j-1 {
        b[i], b[j] = b[j], b[i]
    }
    return string(b)
}
然后为它编写模糊测试:
// reverse_test.go
func FuzzReverse(f *testing.F) {
    f.Fuzz(func(t *testing.T, orig string) {
        rev := Reverse(orig)
        doubleRev := Reverse(rev)
        // 属性1:双重反转应等于原字符串
        if orig != doubleRev {
            t.Errorf("反转两次后不匹配: %q → %q", orig, doubleRev)
        }
        // 属性2:反转后仍为合法UTF-8
        if utf8.ValidString(orig) && !utf8.ValidString(rev) {
            t.Errorf("生成无效UTF-8: %q -> %q", orig, rev)
        }
    })
}
这个测试没有去穷举输入样例,而是定义了两个更稳定的“性质”:
- 双重反转之后,结果应该回到原字符串。
- 如果原字符串本身是合法 UTF-8,反转后也不应破坏 UTF-8 合法性。
这类基于不变量、约束关系或性质的写法,很适合配合模糊测试使用。因为面对随机输入时,你往往很难预先写出每一种精确输出,但可以先定义哪些规则绝不能被破坏。
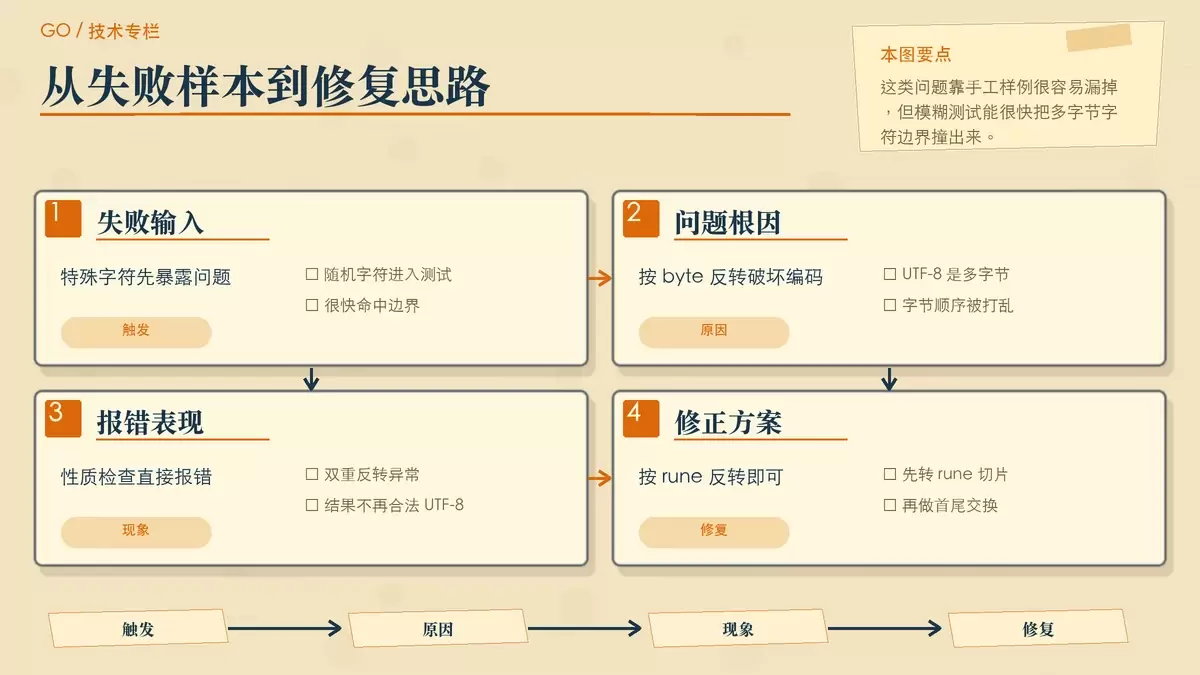
从报错到修复:为什么字节反转会翻车
执行这段模糊测试后,可以看到它很快就失败了:
➜  go test -fuzz=FuzzReverse
fuzz: elapsed: 0s, gathering baseline coverage: 0/11 completed
failure while testing seed corpus entry: FuzzReverse/6f2a6753a50e25a6
fuzz: elapsed: 0s, gathering baseline coverage: 0/11 completed
--- FAIL: FuzzReverse (0.07s)
    --- FAIL: FuzzReverse (0.00s)
        reverse_test.go:18: 生成无效UTF-8: "ӽ" -> "xbdxd3"

FAIL
exit status 1
问题点其实很典型:原函数是按 []byte 反转字符串,而 UTF-8 字符往往由多个字节组成。对于 ASCII 这种单字节字符,这么做通常没问题;但一旦遇到多字节字符,字节顺序被打乱后,结果就可能不再是合法 UTF-8。
也就是说,模糊测试这次不是告诉你“反转逻辑完全错了”,而是精准揭示出一个平时很容易被忽视的边界条件:这个实现对特殊字符并不安全。
修复方式也很直接,按 rune 而不是按字节反转:
// 修复:按rune反转而非字节
func Reverse(s string) string {
    r := []rune(s) // 转换为rune切片
    for i, j := 0, len(r)-1; i < j; i, j = i+1, j-1 {
        r[i], r[j] = r[j], r[i]
    }
    return string(r)
}
这个例子很适合说明 Go 原生 Fuzzing 的实际用途:它不一定替你发明新逻辑,但能很快把“看上去能用”的实现逼到边界上,暴露真实健壮性问题。
哪些场景最适合优先上模糊测试
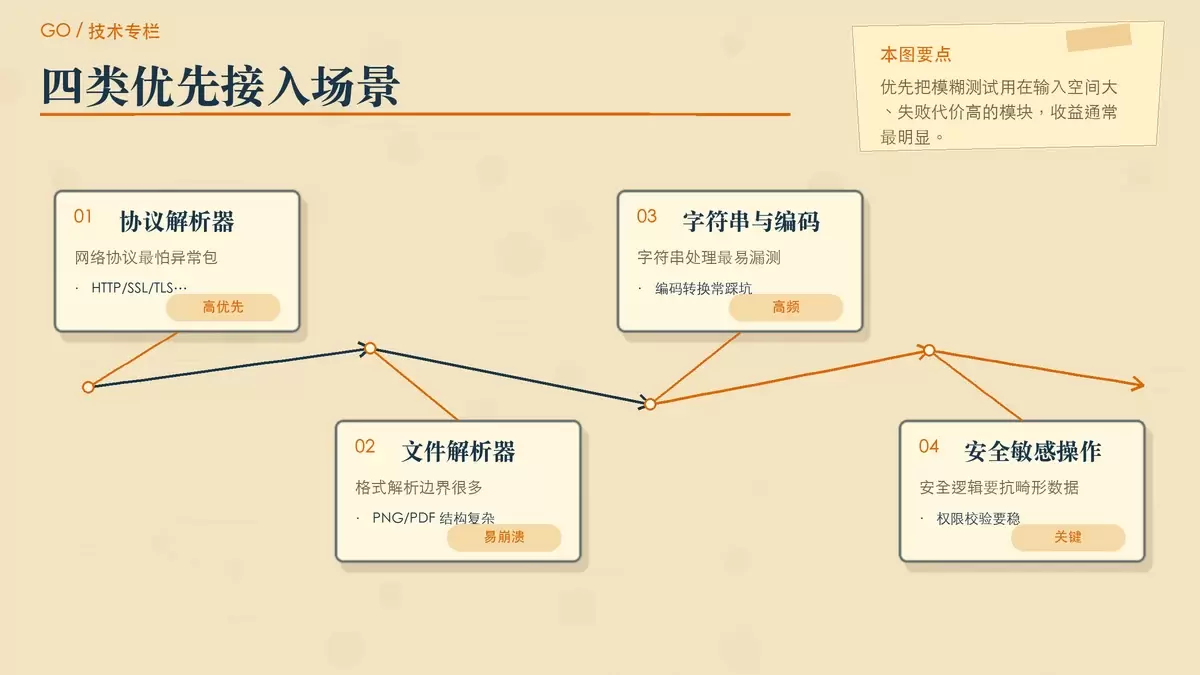
并不是所有代码都同样需要模糊测试,但有几类模块特别值得优先接入。
协议解析器
比如 HTTP、SSL、TLS 等网络协议处理逻辑,最怕遇到畸形数据包、长度异常、字段错位等输入。这类问题不仅会导致崩溃,还有可能演变成安全漏洞。
文件解析器
像 PNG、PDF 这类格式解析器,经常要处理复杂头部、嵌套结构和各种元数据。只要输入文件略微异常,就可能触发崩溃、死循环或资源消耗异常。
字符串与编码处理
这正是上面示例对应的类别。越界访问、非法编码、截断字符、错误转换,都很适合用模糊测试去撞。原文里提到的类似 FUZ 触发 data[3] 越界,也属于这一类高频风险。
安全敏感操作
权限校验、加密算法、输入校验、身份验证相关逻辑,都需要验证自己面对畸形输入时不会出现绕过、异常返回或者状态错乱。
这些场景有一个共同点:输入空间远大于你手工列举测试样例的能力,而程序一旦处理失误,后果通常比较重。
模糊测试真正补上的是什么
Go 把模糊测试纳入标准库,最大的意义不是“又多了一种测试命令”,而是把一种更适合处理未知输入的能力,变成了日常工程实践里可以低成本启用的工具。
单元测试解决的是确定性验证,模糊测试解决的是输入边界探索。两者并不是替代关系,而是互补关系。前者确保你写下的规则成立,后者逼你面对那些你根本没写进规则里的情况。
从这个角度看,模糊测试的真正价值,正是打破开发者对“正常输入”的天然依赖。程序不仅要对已知情况负责,也要尽量在未知情况下保持稳定、可控,而不是轻易崩溃。
正如 Barton Miller 团队早期实验所揭示的那样,很多软件失效点,并不在复杂功能本身,而藏在那些经常被认为“不太可能发生”的角落里。









