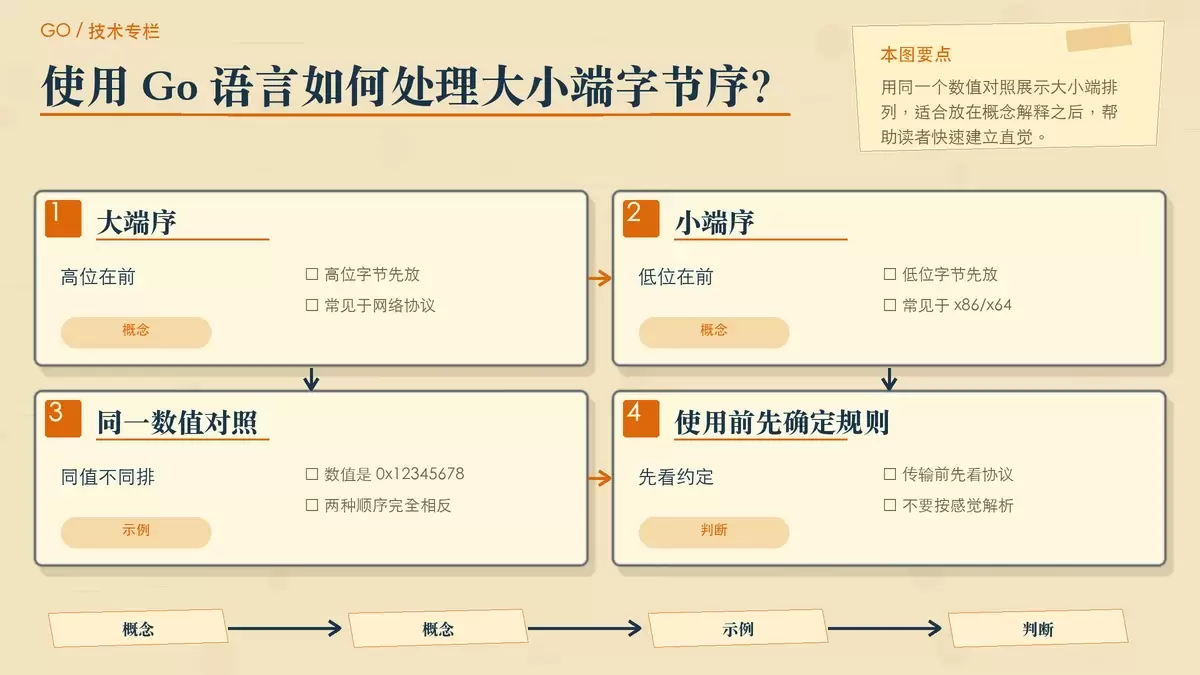
使用 Go 语言如何处理大小端字节序?
在 Go 里处理二进制数据时,大小端决定了多字节数值如何写入内存、文件或网络。本文结合 Go 标准库 `encoding/binary` 的常用接口,说明什么时候该用大端或小端、怎样在代码里完成转换,以及实际使用时最容易踩到的几个点。
2026-08-25
190
在 Go 里处理二进制数据时,大小端决定了多字节数值如何写入内存、文件或网络。本文结合 Go 标准库 `encoding/binary` 的常用接口,说明什么时候该用大端或小端、怎样在代码里完成转换,以及实际使用时最容易踩到的几个点。
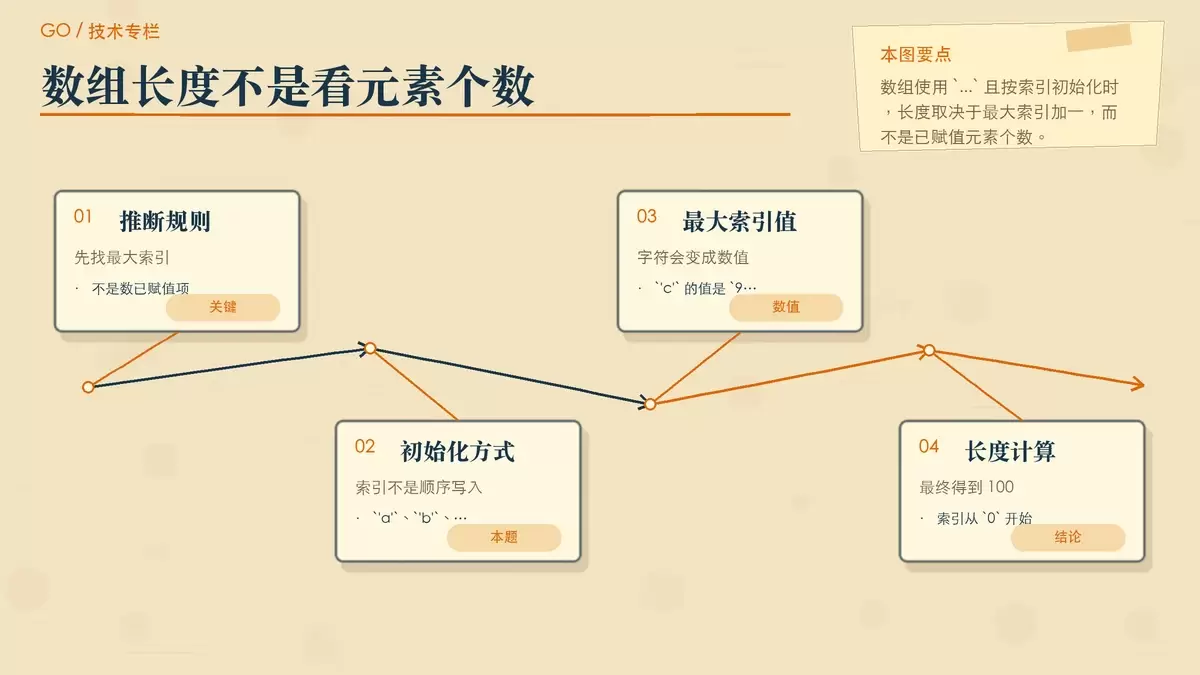
`[...]int{}` 不是错误语法,而是 Go 中“由编译器推断数组长度”的写法。配合按索引初始化和 `rune` 字符常量后,这道看起来像 `map` 的题,结果其实是长度 `100`。文章会把三处容易混淆的点拆开解释清楚。 `[...]int{}` 在 Go 里并不是少见语法,但和按索引初始化、单引号字符放在一起时,很容易让人误判成 `map` 或直接怀疑会编译失败。
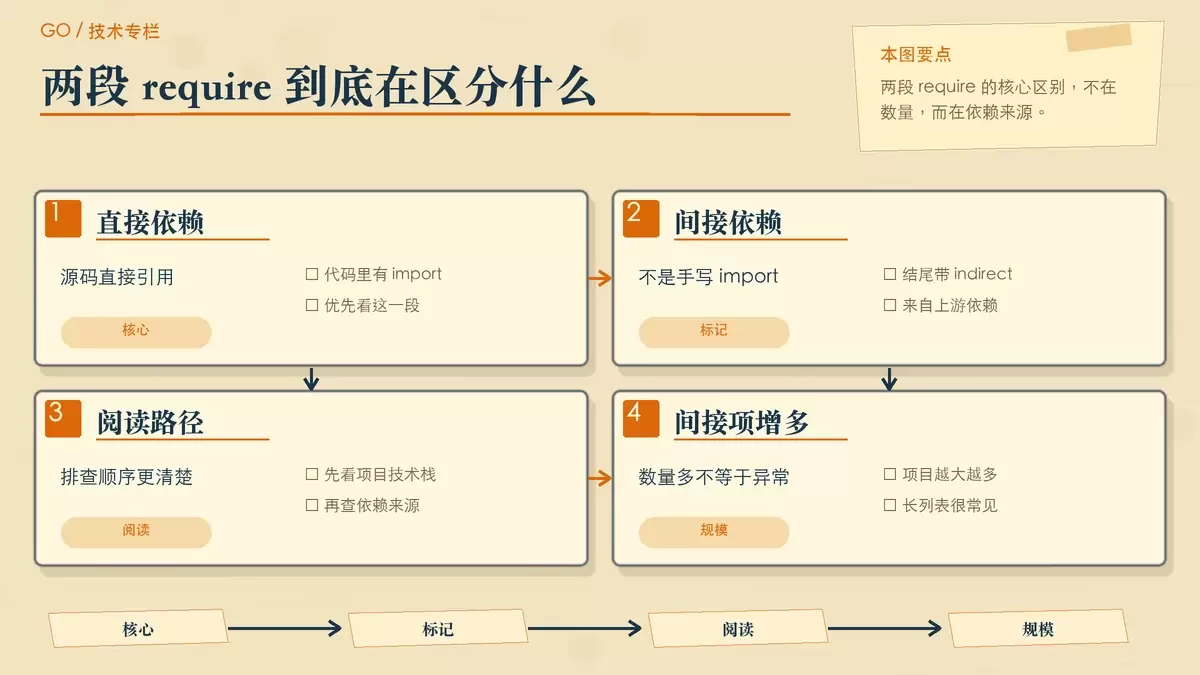
很多 Go 开发者第一次看到 go.mod 里出现两段 require,都会疑惑是不是写重复了。其实这正是 Go 1.17 之后依赖整理策略的一部分:一段放直接依赖,另一段集中列出带 // indirect 标记的间接依赖,方便识别、锁定版本并减少后续升级的不确定性。
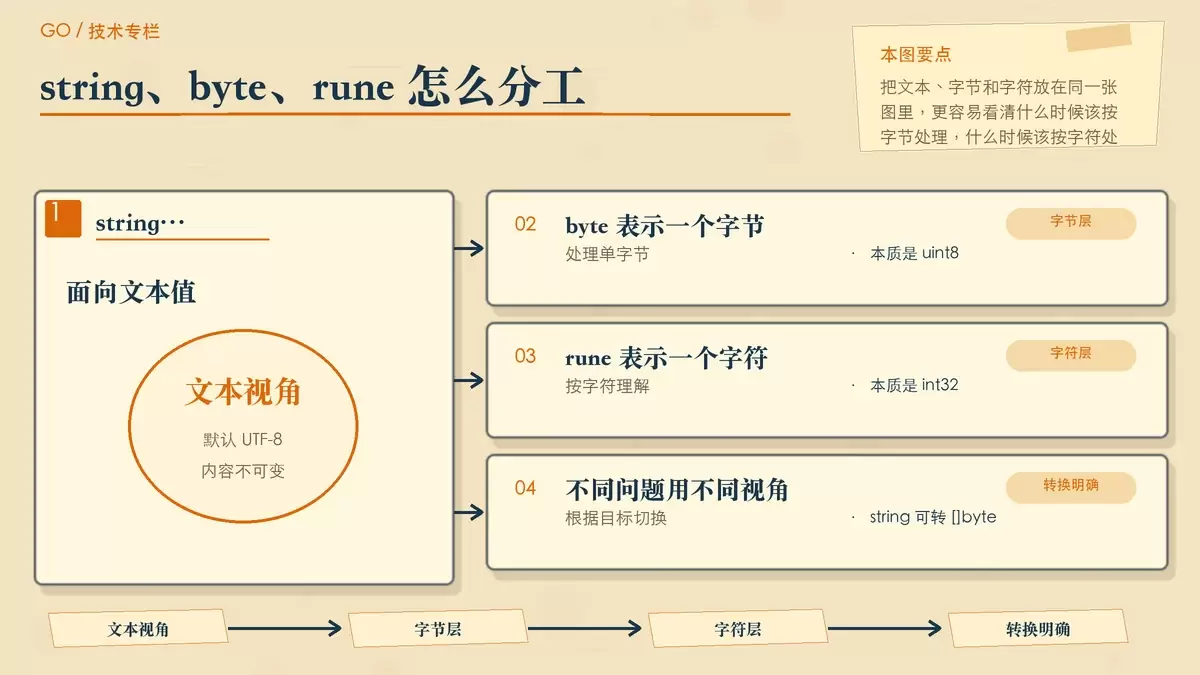
Go 里的 rune 并不神秘,它本质上是 int32 的别名,用来按 Unicode 字符而不是按字节处理文本。本文从定义、与 string 和 byte 的关系、类型转换到常见场景,讲清楚为什么中文、日文和 emoji 处理离不开 rune。 在 Go 里,很多人对 rune 并不陌生,但真正踩坑往往发生在中文、日文或 emoji 文本处理时:明明是“一个字符”,按 len 或切片却得出完全不同的结果。
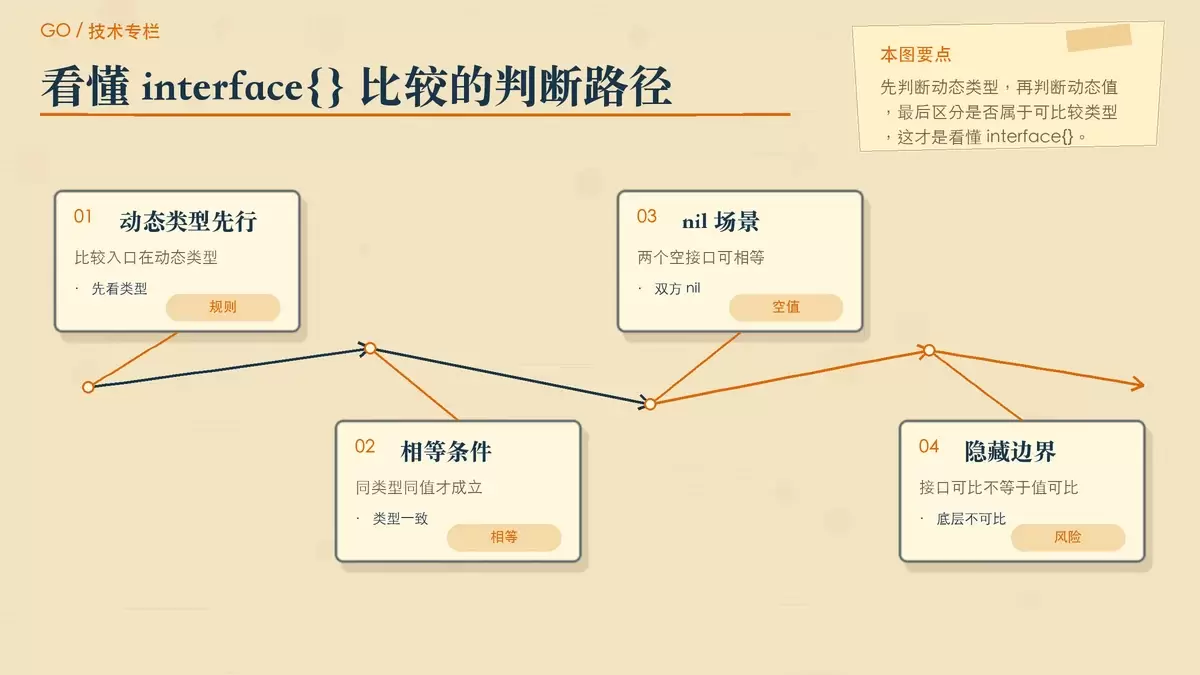
在 Go 里,两个 `interface{}` 能不能直接用 `==` 比较,答案不是简单的是或否。关键在于它们的动态类型、动态值,以及底层具体类型是否本身可比较;一旦把 `slice`、`map`、`func` 装进接口再硬比,就可能在运行时直接 `panic`。
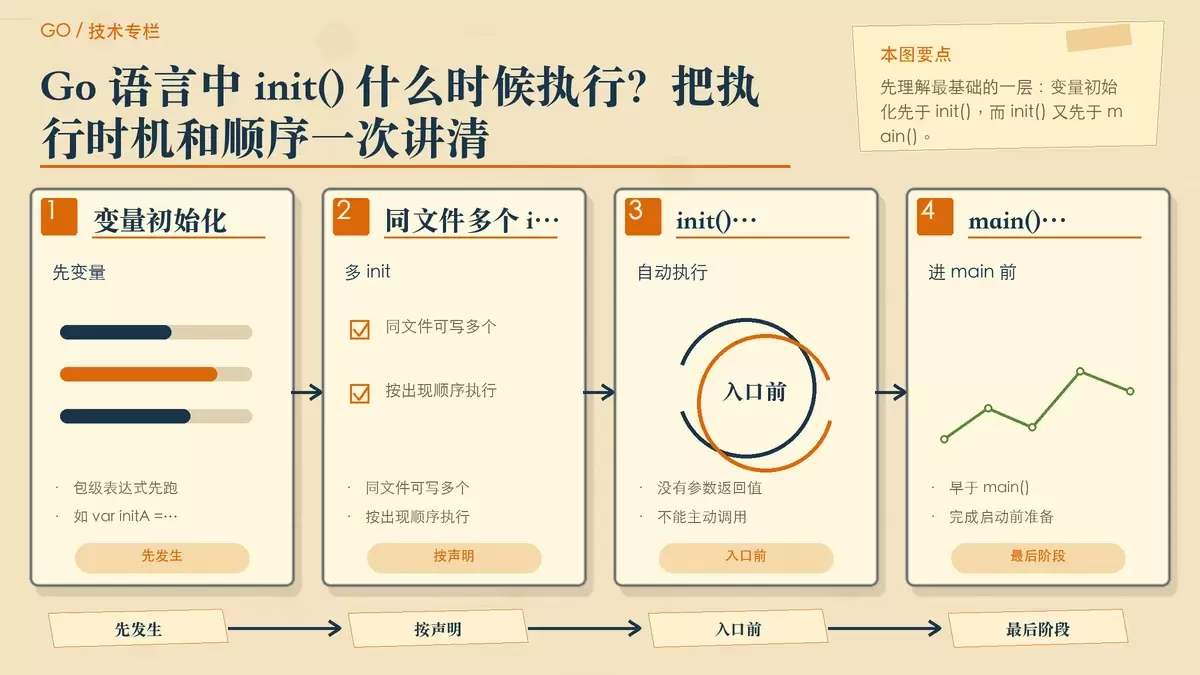
Go 里的 init() 常被说得很神秘,实际可以拆成几个明确规则:变量初始化先于 init() ,同文件内按出现顺序执行,同包内跨文件通常按文件名顺序执行,而跨包则先执行被依赖包。把这些顺序梳理清楚,才能判断哪些初始化方式适合放进 init() 。
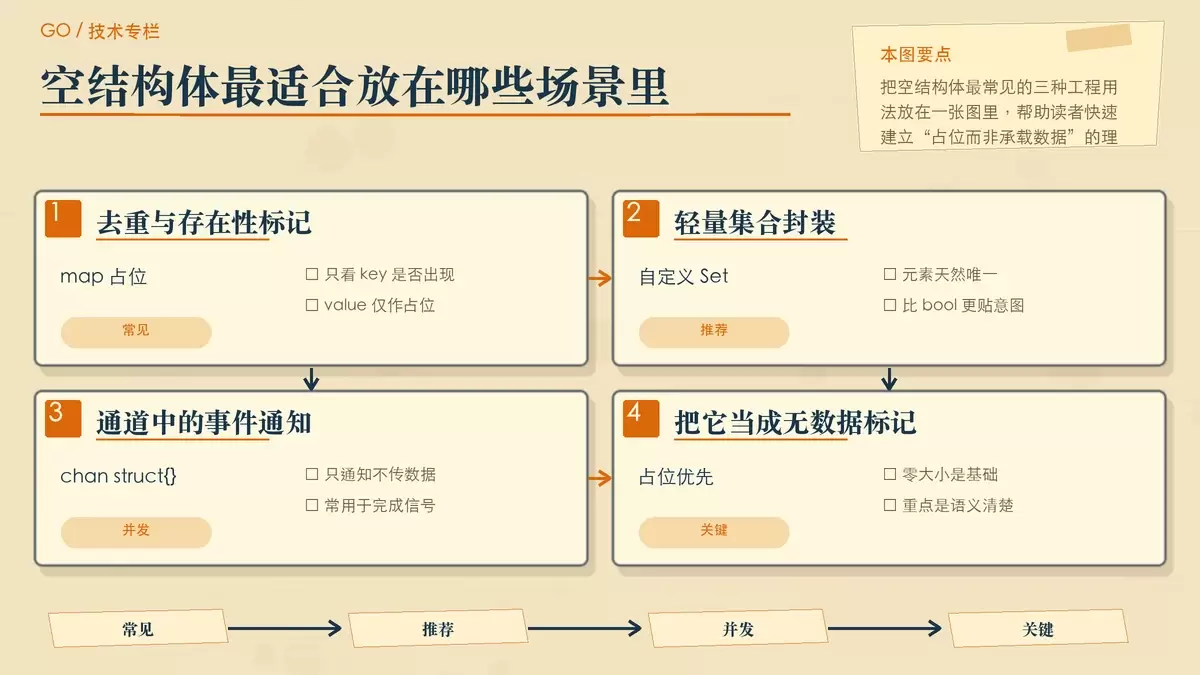
Go 里的空结构体 `struct{}` 看起来只是“没有字段”的类型,真正有价值的地方在于它的零大小特性,以及由此带来的占位、去重、信号通知等常见用法。本文结合代码示例梳理它在项目中的实际场景,也说明“零内存”与“地址可能相同”分别该怎样理解。
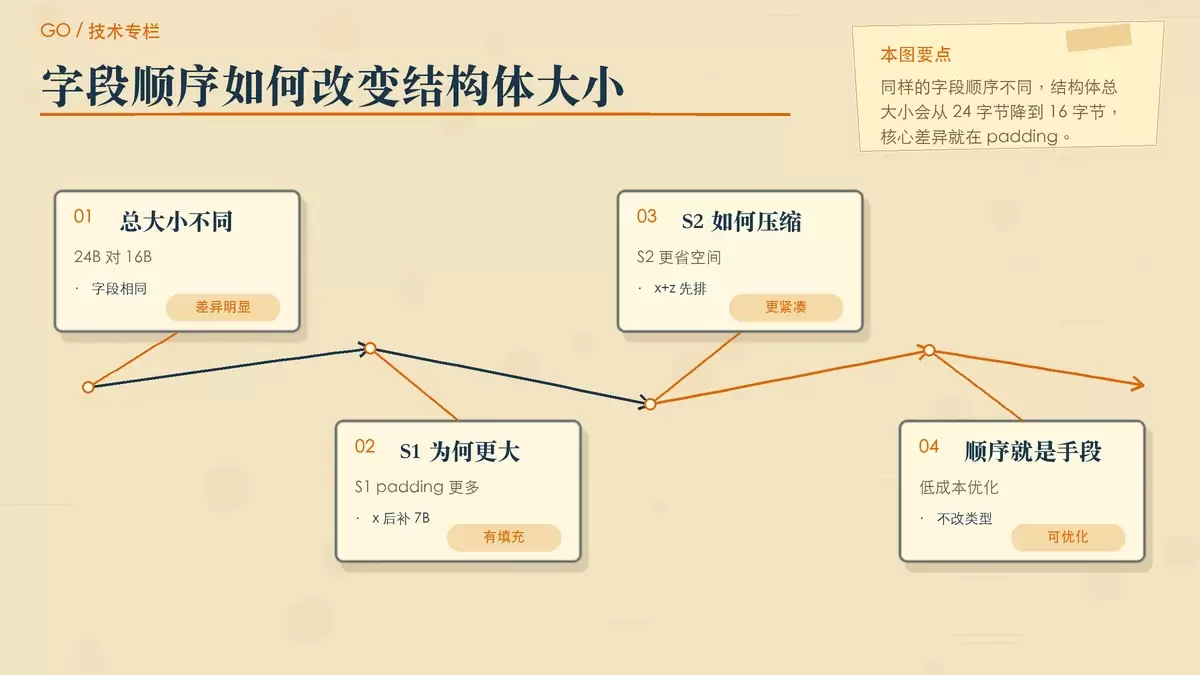
Go 结构体的字段顺序,不只是代码风格问题,直接影响实际占用内存。本文从两个大小不同但字段相同的结构体出发,解释 Go 的对齐规则、padding 的产生方式,以及 `unsafe` 包里 `Sizeof`、`Alignof`、`Offsetof` 该怎么配合判断结构体布局。
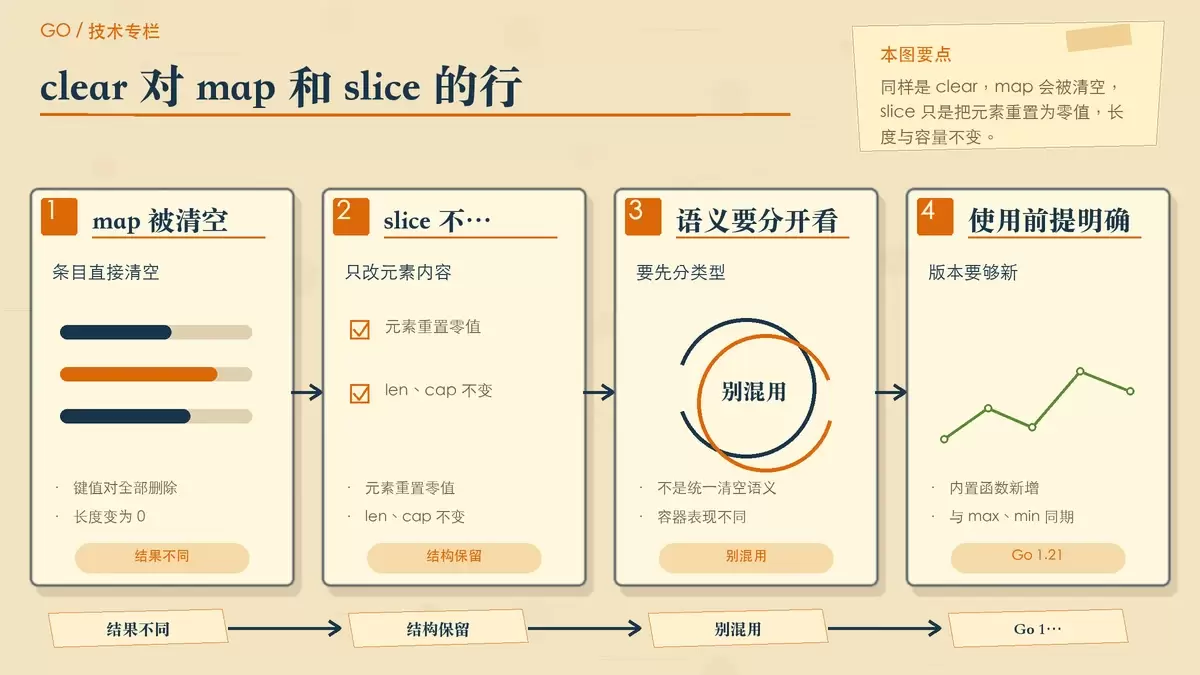
Go 1.21 新增的内置函数 clear,专门用于 map 和 slice,但两者的行为并不相同:map 会被清空,slice 只会把元素重置为零值。本文结合官方定义和代码示例,讲清它的适用范围、实际效果,以及在泛型场景下应如何理解。
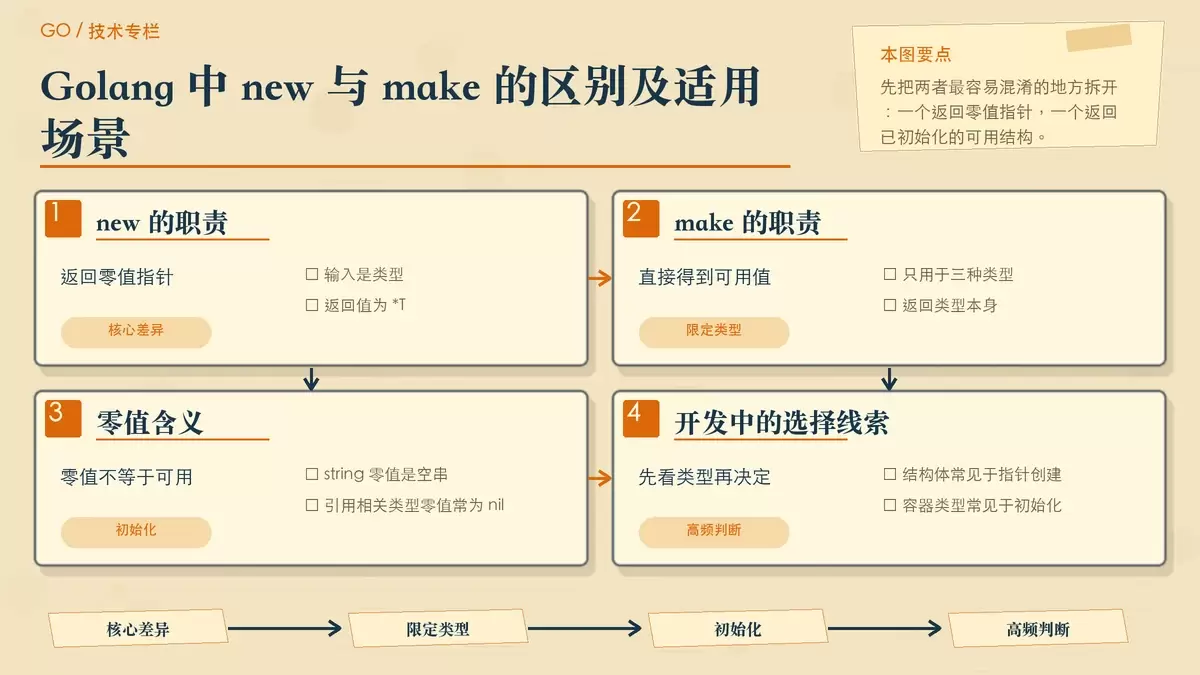
在 Go 里,`new` 和 `make` 都和内存分配有关,但职责并不相同。前者返回某个类型的零值指针,后者只服务于 `slice`、`map`、`channel`,并直接完成可用结构的初始化。理解这层差异,才能避免 `nil map`、空通道这类常见问题。 刚接触 Go 时, new 和 make 很容易被当成“两个都能申请内存的函数”来记忆,但一到写结构体、切片或映射时,差别马上就会暴露出来。
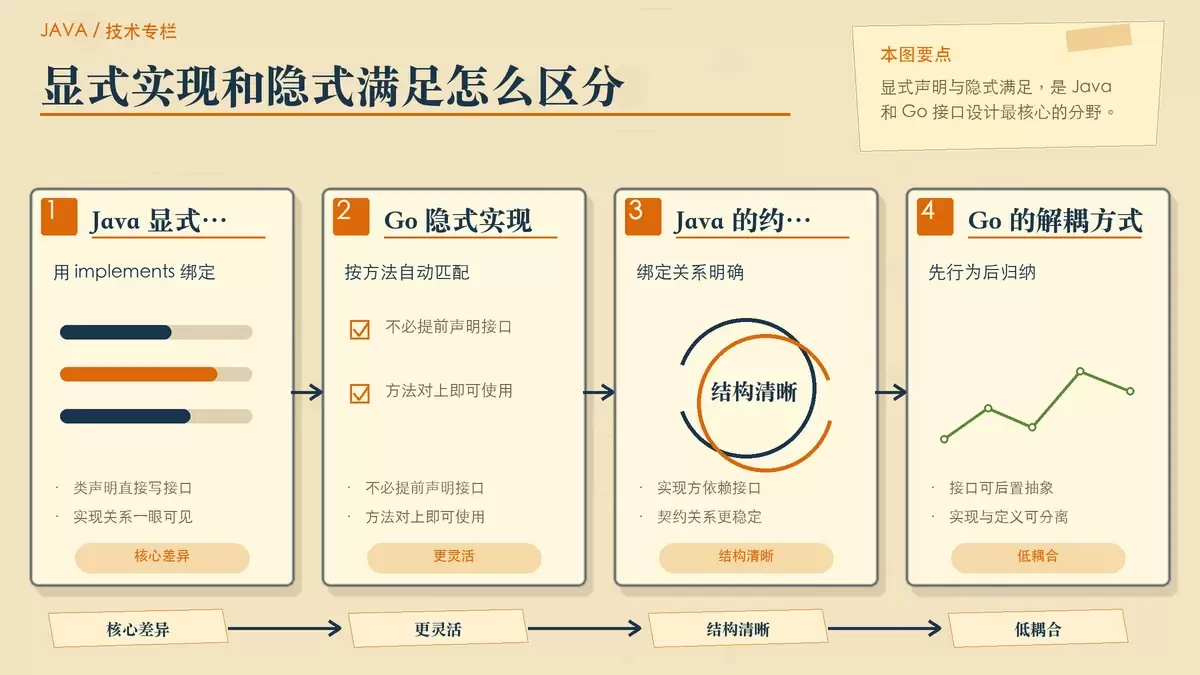
Java 和 Go 都把接口当作行为契约,但两者在“怎么实现接口”这件事上走了两条路。Java 依赖显式声明和更强的类型约束,Go 则用隐式实现和接口组合强调行为匹配。理解这组差异,有助于判断两种语言各自适合的抽象方式。
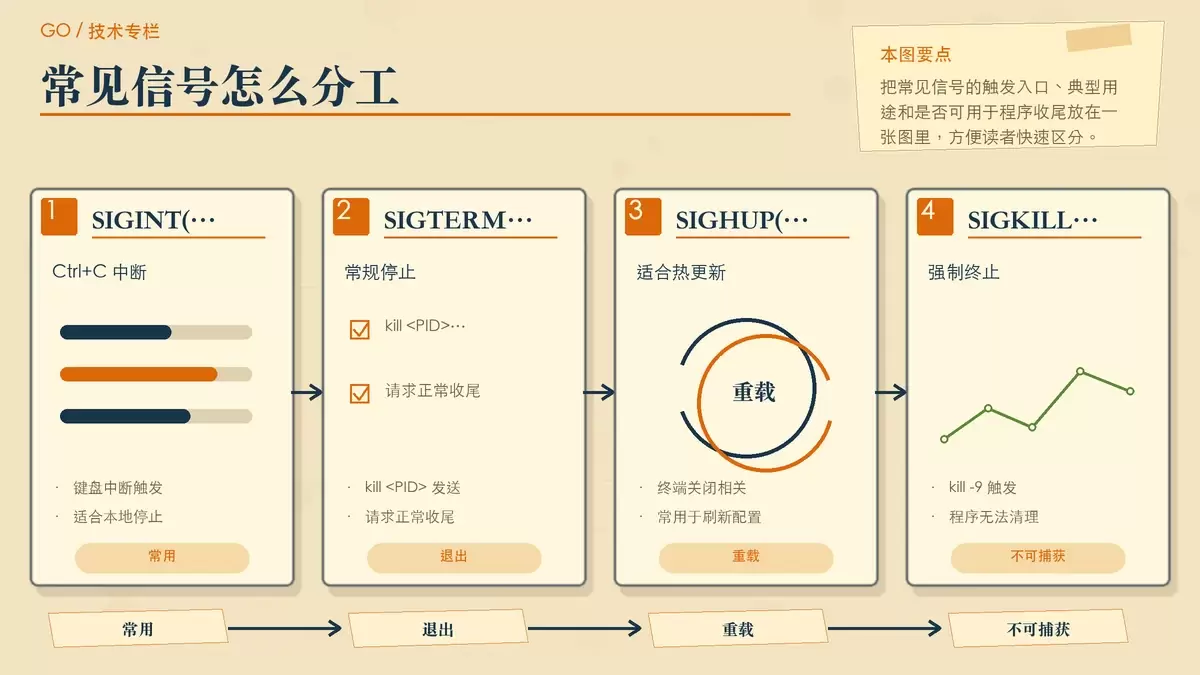
在 Go 程序里接收系统信号,核心并不复杂:用 `os/signal` 监听,用带缓冲通道接收,再按 `SIGINT`、`SIGTERM`、`SIGHUP` 等类型决定退出、清理或重载。文章结合基础示例和 HTTP 服务优雅退出,梳理信号处理的常见做法与边界。