


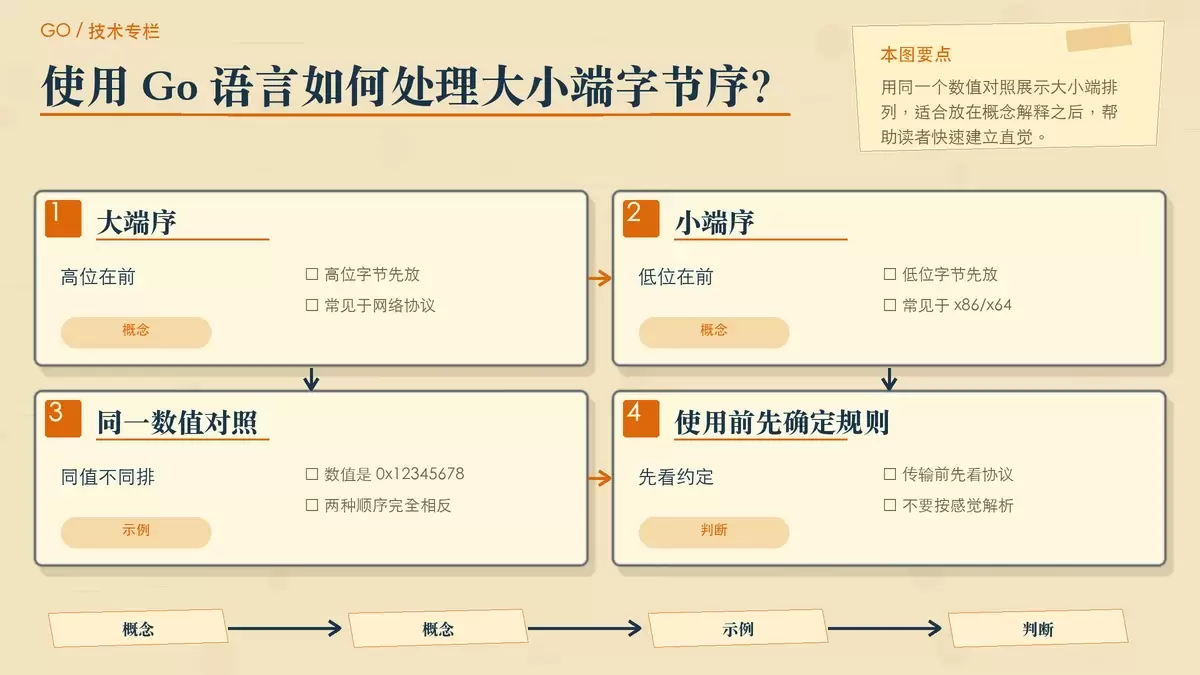
只要涉及二进制协议、文件格式解析,或者和其他语言、其他机器对接,字节序就绕不过去。Go 标准库已经把大小端处理做成了现成工具,关键不在“会不会调 API”,而在于先判断数据来源要求什么字节序,再选择合适的读写方式,避免解析错位、兼容性问题和不必要的性能损耗。
先搞清楚:什么是大小端字节序
字节序(Endianness)指的是多字节数据类型在内存存储或传输时的字节排列顺序,常见于 int32、uint64 这类长度超过 1 字节的数据。
大端序与小端序的区别
大端序(Big-Endian):高位字节放在低地址,或者说先传输高位字节。
例如,0x12345678 按大端序存储时,对应字节序列是:
[]byte{0x12, 0x34, 0x56, 0x78}小端序(Little-Endian):低位字节放在低地址,或者说先传输低位字节。
同样的 0x12345678,按小端序存储时,对应字节序列是:
[]byte{0x78, 0x56, 0x34, 0x12}实际开发里通常怎么用
- 网络传输,尤其是 TCP/IP 协议相关场景,默认使用大端序,也就是常说的“网络字节序”;
- 现代 CPU,例如 x86、x64,通常采用小端序。
这也是为什么很多 Go 项目平时几乎碰不到字节序,但一旦进入网络协议、二进制文件解析或跨语言通信,就必须明确处理它。
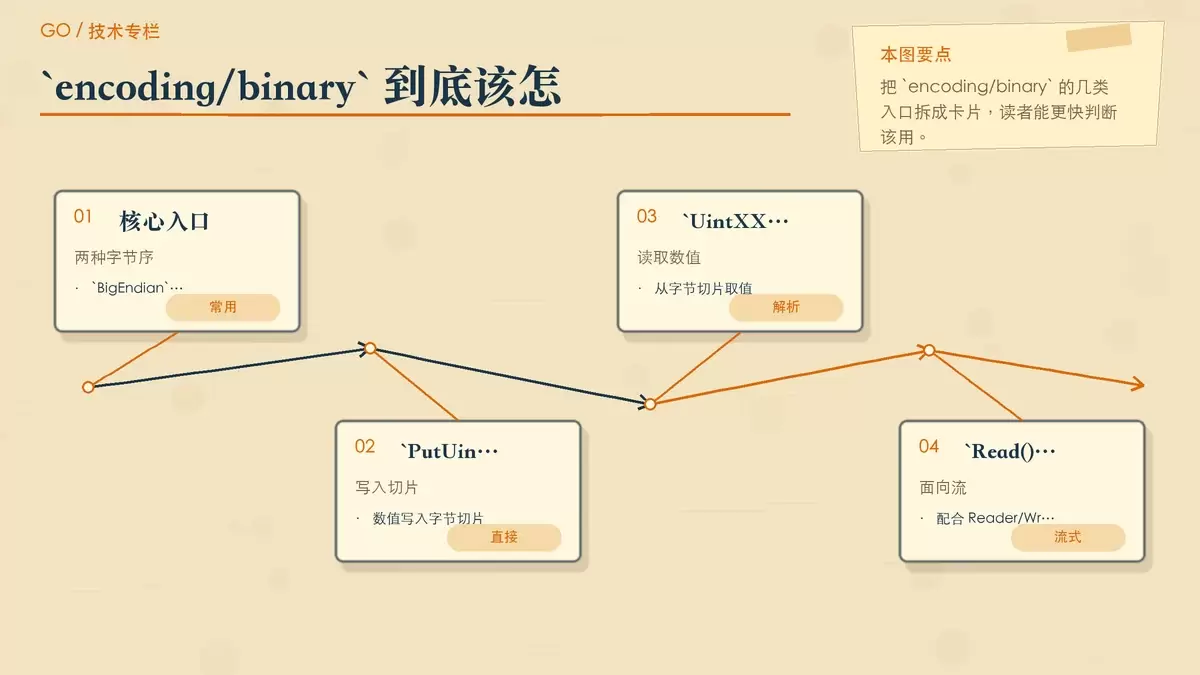
Go 里怎么处理:`encoding/binary` 的核心能力
Go 标准库通过 encoding/binary 提供完整的大小端支持。最常用的是两个全局变量:
binary.BigEndianbinary.LittleEndian
它们都实现了 ByteOrder 接口,可以用来完成数值和字节序列之间的转换,也可以直接做流式读写。
常用方法可以分成三类
| 方法 | 功能 | 示例 |
|---|---|---|
| PutUint16/32/64() | 数值 → 指定字节序的字节序列 | binary.BigEndian.PutUint32(buf, num) |
| Uint16/32/64() | 字节序列 → 指定字节序的数值 | num := binary.LittleEndian.Uint32(buf) |
| Read()/ Write() | 面向 io.Reader / io.Writer 的流式读写 |
binary.Read(reader, binary.BigEndian, &data) |
一段代码看懂互转过程
package main
import (
    "encoding/binary"
    "fmt"
    "bytes"
)

func main() {
    // 数值 → 字节序列(大端序)
    num := uint32(0x12345678)
    buf := make([]byte, 4)
    binary.BigEndian.PutUint32(buf, num)
    fmt.Printf("BigEndian: %xn", buf) // 输出: 12 34 56 78

    // 字节序列 → 数值(小端序)
    data := []byte{0x78, 0x56, 0x34, 0x12}
    decoded := binary.LittleEndian.Uint32(data)
    fmt.Printf("Decoded: 0x%xn", decoded) // 输出: 0x12345678
}
这类场景里,如果你已经拿到了固定长度的字节切片,通常优先使用 PutUintXX() 和 UintXX()。它们直接、清晰,也更适合对性能敏感的代码路径。
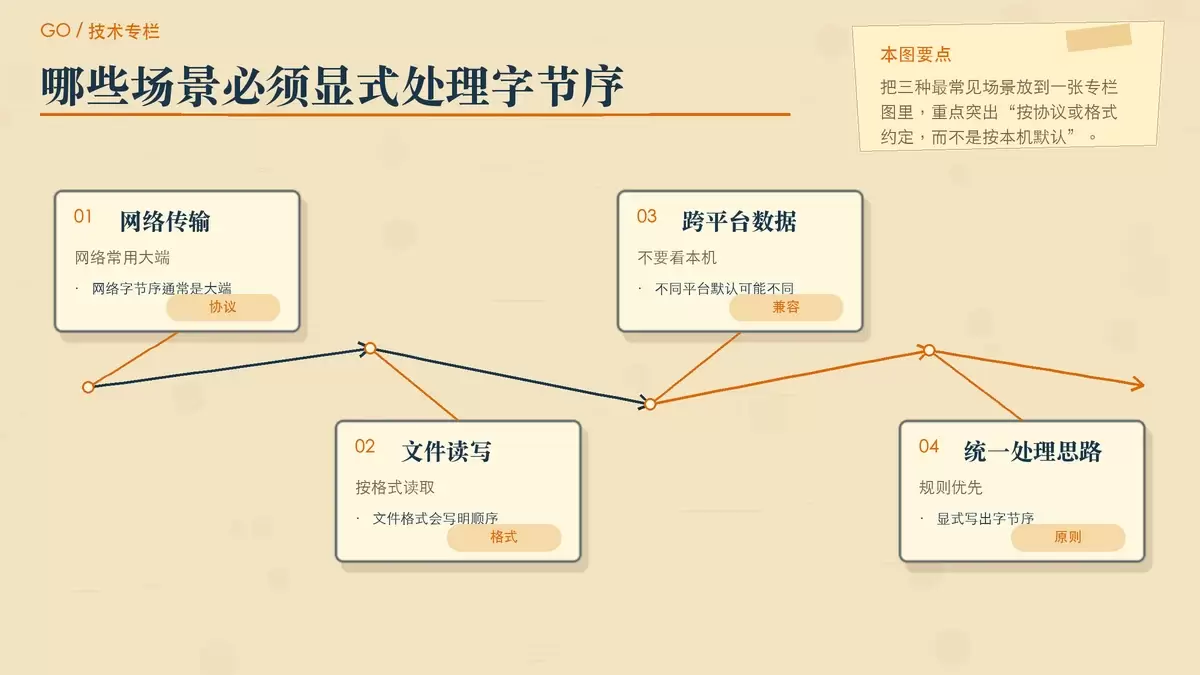
三类常见场景:网络、文件与跨平台兼容
字节序最常见的价值,不是在“概念理解”,而是在对接场景里保证双方读到的是同一个值。
网络传输:协议一般要求大端序
网络协议通常以大端序作为统一格式,发送前要显式转换:
// 发送数据
var num uint32 = 500
buf := new(bytes.Buffer)
binary.Write(buf, binary.BigEndian, num) // 转为大端序
conn.Write(buf.Bytes())                 // 发送字节流[3](@ref)
如果协议文档已经写明是网络字节序,这里就不应根据本机 CPU 的字节序做判断,而是直接按大端序编码。
文件读写:解析二进制格式时必须明确字节序
读取二进制文件时,字节序不是“猜出来”的,而是由文件格式定义决定的:
file, _ := os.Open("data.bin")
defer file.Close()
var data uint32
binary.Read(file, binary.BigEndian, &data) // 按大端序读取[3](@ref)
只要字节序选错,读出来的值就会完全不同。对文件格式解析来说,这往往比读取失败更难排查,因为程序可能还能继续运行,只是结果全错。
跨平台数据兼容:统一规则比依赖本机更重要
不同硬件平台的默认字节序可能不同,因此跨平台通信时要优先遵循协议或格式约定,而不是依赖本地行为:
// 接收网络数据后解析
received := []byte{0x00, 0x00, 0x01, 0xFF}
value := binary.BigEndian.Uint32(received) // 强制按大端序解析[1](@ref)
这类写法的重点就在“强制按约定解析”。只要输入格式固定,程序就应该显式写出对应的 BigEndian 或 LittleEndian。
Go 如何检测当前系统字节序
Go 本身没有直接提供系统字节序检测 API。如果确实要判断当前平台是大端还是小端,可以借助 unsafe 包完成:
import "unsafe"

func IsLittleEndian() bool {
    var i int16 = 0x0001
    firstByte := *(*byte)(unsafe.Pointer(&i))
    return firstByte == 0x01 // 首字节为1 → 小端序[4](@ref)
}
注意:
unsafe操作需要谨慎,通常只建议在底层开发、调试验证或必须贴近内存布局的场景中使用。
不过大多数业务代码并不需要真的去“检测系统字节序”。更稳妥的做法是:数据协议要求什么,就按什么解析和编码。只有在处理底层内存布局、设备接口、运行时兼容等问题时,系统字节序检测才真正有意义。
容易出错的几个细节
- 数据类型要和字节长度匹配:例如
uint32需要 4 字节,长度不对就可能触发 panic,或者得到错误结果。 - 有符号整数要注意类型转换:如果处理的是带符号值,通常需要显式转换,例如
int32(num)。 - 流式读取要保证读满:从
io.Reader读取时,不能默认一次就拿到完整字节数,必要时应配合io.ReadFull使用。 - 复杂结构体不能想当然直接套用:字符串、变长字段、复杂结构通常需要手动序列化,或者改用
encoding/gob、encoding/json等更适合的方案。
性能上也有一个简单判断
如果只是做固定整数和字节切片之间的转换,优先使用 PutUintXX() 和 UintXX(),通常比 binary.Read/Write 更直接,也能避开反射带来的额外开销。后者更适合和文件、连接、缓冲区这类流式接口一起使用。
怎么选才不容易出错
字节序本质上是二进制数据解释规则的一部分。真正重要的不是当前机器是大端还是小端,而是你的数据来源、协议文档或文件格式要求什么顺序。
在 Go 里,处理这件事并不复杂:
- 需要直接做数值与字节切片互转时,用
encoding/binary的BigEndian或LittleEndian; - 做网络协议时,优先按大端序理解“网络字节序”;
- 解析文件或跨平台通信时,把字节序写死为协议规定值,不要依赖宿主环境;
- 对性能敏感的场景,优先选择
PutUintXX()和UintXX()。
只要先把“数据约定”确认清楚,再落到具体 API,Go 里的大小端处理通常会比想象中简单很多。









