

Python异常处理基础:try-except语法与实战示例
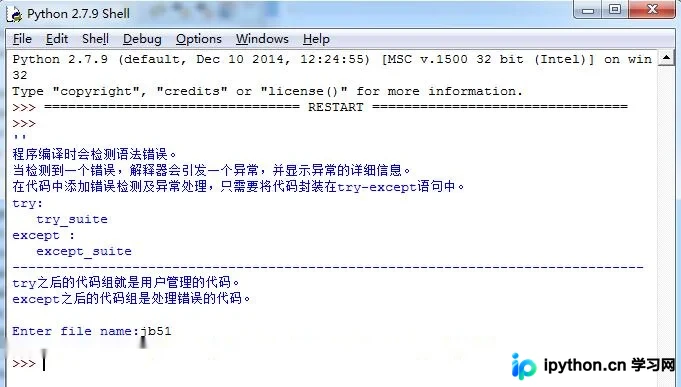
本文详解Python中的错误与异常处理机制,重点介绍try-except语句的用法。通过文件读取的完整代码示例,展示如何捕获IOError并处理运行时异常,帮助开发者掌握Python程序中的错误检测与异常处理技巧。
2026-10-13
6

本文详解Python中的错误与异常处理机制,重点介绍try-except语句的用法。通过文件读取的完整代码示例,展示如何捕获IOError并处理运行时异常,帮助开发者掌握Python程序中的错误检测与异常处理技巧。
本文深入解析Python中json与pickle两大序列化模块。json用于字符串与通用数据类型转换,支持跨语言数据交换;pickle专用于Python特有类型及全数据类型序列化,仅限Python环境。通过对比dumps、loads、dump、load四个核心功能及文件读写模式(文本vs二进制),明确两者在数据类型支持、语言兼容性及使用场景上的关键差异,帮助开发者根据需求选择合适的序列化方案。
本文系统梳理Python中用于文件与文本处理的核心标准库模块。从linecache的行级缓存读取、dircache的目录管理,到filecmp的文件对比、fileinput的快速迭代,以及os.path的路径解析和shutil的高级归档操作,逐一解析其功能与适用场景,帮助开发者高效处理各类文件任务。
本文介绍了使用Python随机读取指定文件夹下文件的具体实现方法。通过os.walk遍历目录获取文件列表,并利用random模块随机选取其中一个文件路径。文中提供了完整代码示例,并强调了Python3.5环境测试通过及rootdir参数需根据实际目录修改的注意事项,旨在帮助开发者快速掌握该技巧。
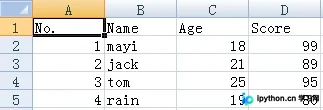
本文详细介绍Python中csv模块的使用方法,涵盖如何读取CSV文件的全部数据及指定列。通过对比reader和DictReader两种读取方式,解析字符串类型处理及按列名查询的技巧,并演示如何追加写入新数据到CSV文件,帮助开发者高效处理表格数据。
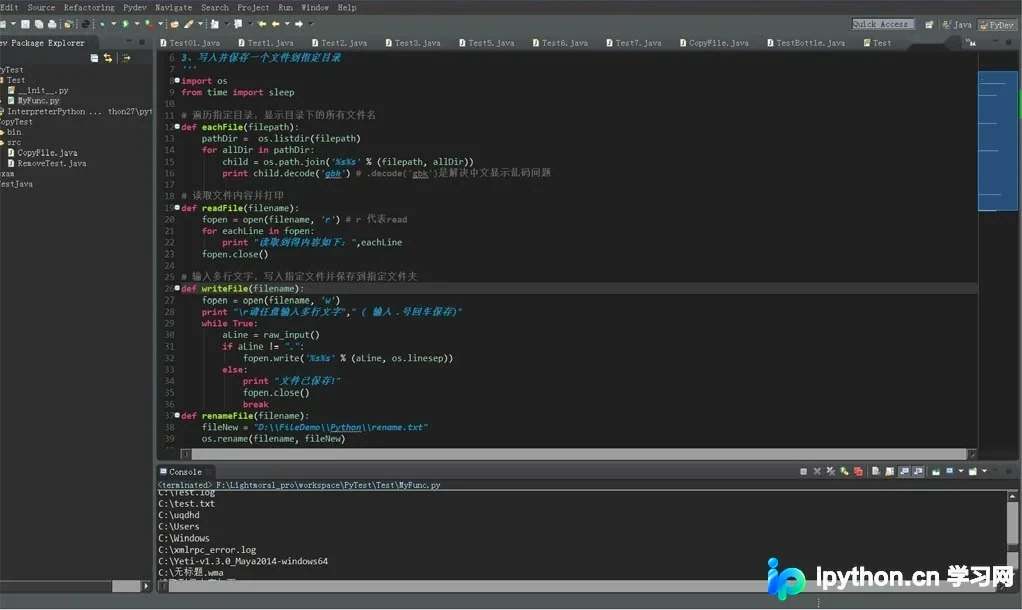
本文介绍如何使用Python实现指定目录下的文件遍历、文件内容读取以及新文件的创建与保存。通过调用os模块,仅需约40行代码即可完成相关功能,相比Java更为简洁。文章提供了完整的Python代码示例,涵盖文件列表打印、内容读取及多行文字写入的具体实现。
本文介绍使用Python统计文本文件字数及词频的方法。通过读取file.txt,预处理标点符号并转换为小写,利用字典统计单词出现次数。代码包含按频率排序及输出Top N单词的功能,适合Python初学者参考文件处理与基础算法实现。
本文介绍使用 Python 编写的一个简单脚本,用于统计指定目录下的代码行数。通过遍历文件并过滤特定后缀,可快速计算总文件数及有效代码行,适用于送测前的代码量评估及后续自动化统计场景。
本文详细介绍如何使用Python通过文件路径计算文件的Hash值。重点强调必须以二进制模式('rb')打开文件,否则会导致计算结果错误。文中对比了MD5和SHA1算法中digest()与hexdigest()方法的位数差异,并提供了完整的代码示例及在线加密工具链接,帮助开发者准确进行文件完整性校验。
本文详细介绍Python中index()和seek()两个常用函数的用法。index()用于在序列中查找指定元素并返回首次出现的索引,支持通过beg和end参数指定搜索范围;seek()用于文件操作中移动读取指针,支持从文件头、当前位置或末尾进行偏移。文章通过具体代码示例演示了如何处理多次出现的情况及文件指针的移动技巧。
本文详细介绍Python标准库shutil模块的核心文件操作功能。涵盖shutil.copy()单文件复制、shutil.copytree()整文件夹备份、shutil.move()文件移动与重命名,以及结合os模块实现的永久删除操作。通过具体代码示例解析各函数的参数行为、返回值及常见错误处理,帮助开发者掌握高效的文件管理技巧。
本文介绍在Python中如何获取文件名和文件路径。通过os模块的basename、dirname、realpath以及listdir和walk函数,可以分别提取URL或本地路径中的文件名与目录,列出指定目录内容,并递归遍历文件夹获取所有文件信息。