

Python遍历目录树实现代码示例
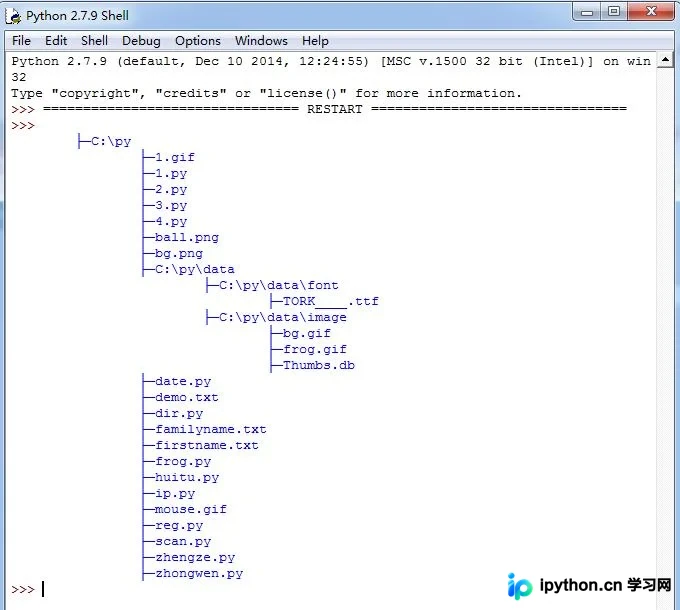
本文提供了一段基于Python的递归函数代码,用于遍历指定目录并输出树状结构。通过判断文件与文件夹类型,利用os.listdir获取子项并递归调用,实现目录树的可视化展示。代码包含存在性检查及基础的文件名打印逻辑,适合需要快速处理目录结构的场景参考。
2026-10-13
6

本文提供了一段基于Python的递归函数代码,用于遍历指定目录并输出树状结构。通过判断文件与文件夹类型,利用os.listdir获取子项并递归调用,实现目录树的可视化展示。代码包含存在性检查及基础的文件名打印逻辑,适合需要快速处理目录结构的场景参考。
本文介绍Python中读取文件最后N行及最后一行的两种方法。第一种适用于小文件,直接读取所有行后切片;第二种针对大文件,通过计算文件大小和块大小,利用seek定位读取末尾数据,避免全量加载内存。文中包含完整代码示例及日志格式说明,供Python开发者参考。
本文介绍如何利用Python内置的os模块,通过os.path.dirname和os.path.split函数,从完整文件路径中准确提取父目录路径及文件名。
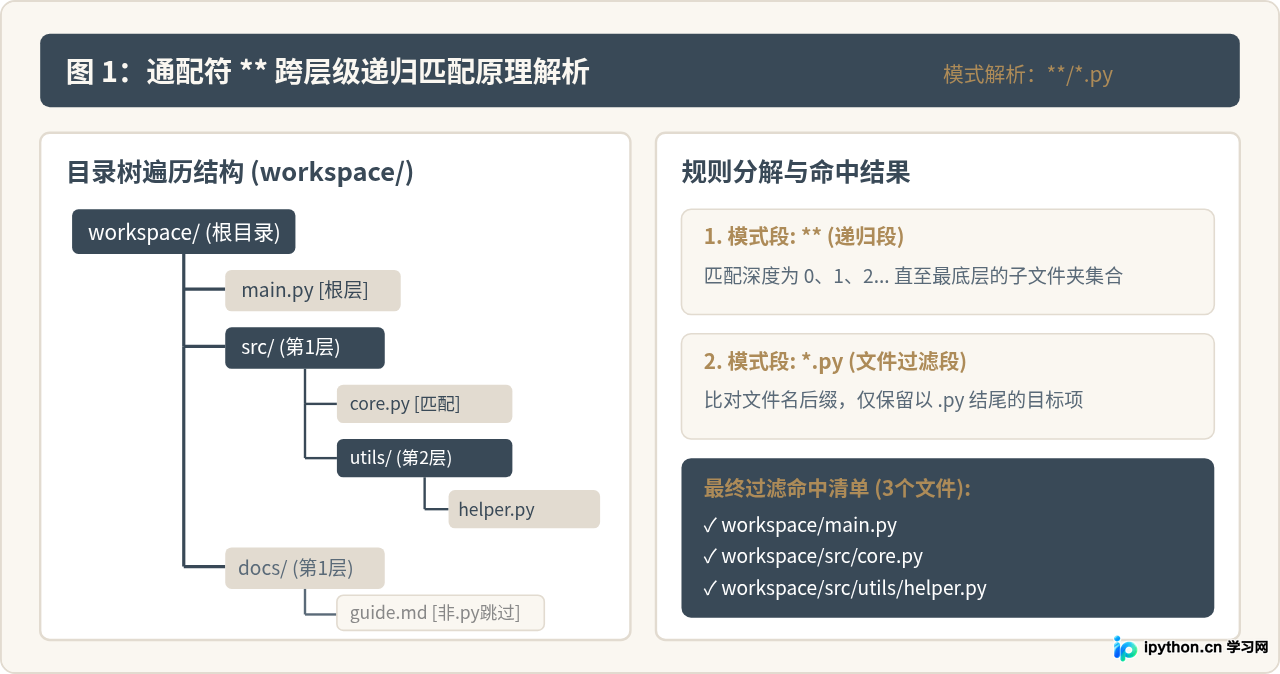
在Python中递归搜索文件主要有面向对象的pathlib模块与内置的glob模块两种途径。本文详解pathlib.Path.rglob与glob.glob在递归遍历目录时的语法规范、模式匹配原理、代码示例及性能选型差异。
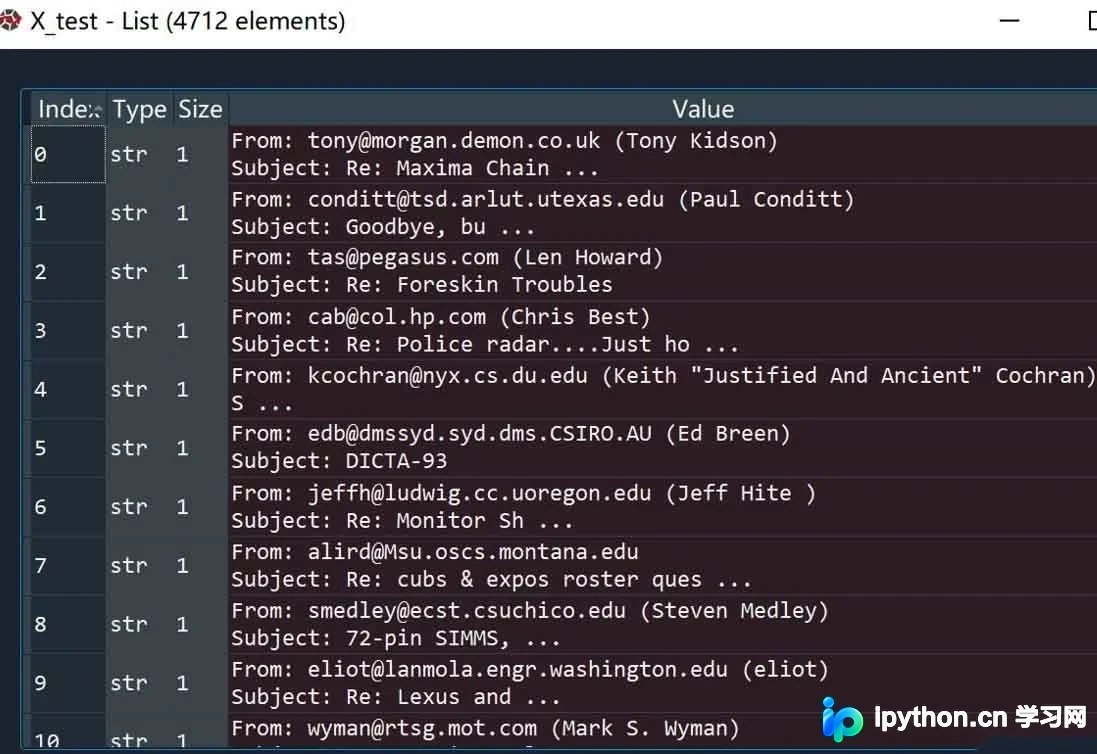
本文介绍如何使用Python循环批量保存和读取文本文件。以新闻文本主题分类数据为例,通过遍历列表将每个子列表保存为独立txt文件,并利用os模块遍历目录循环读取所有文件内容。代码包含保存与读取两个核心部分,适用于需要处理大量文本数据的场景,提供完整可运行的Python实现方案。
掌握Python文件读写需遵循打开、操作、关闭的标准流程。本文详解open函数的路径、模式与编码参数,对比read、readline与readlines的读取差异,说明w(清空覆盖)与a(追加写入)的底层行为及缓冲区机制,并提供with语句的安全管理规范,帮助开发者快速准确地进行文本处理。
本文详解Python中文件处理的核心流程,涵盖字符编码配置、文件打开参数、全文与逐行读取方法以及读写权限的区别。通过标准代码示例演示如何安全创建、读取、写入与追加文本文件,有效规避资源泄露与文件锁定问题,帮助开发者快速掌握本地数据存取的标准操作。
本文提供基于Python开发常用文件处理工具的完整方案,涵盖使用内置函数读写文本、利用os.path识别后缀、通过zipfile打包及子进程调用的解压方案,配合目录遍历获取全量路径。附可复用代码与运行核对方法,适合集成至自动化批处理脚本。
在Python项目中准确定位文件位置是数据读取与资源配置的基础。本文针对脚本所在目录与当前工作目录的差异,详细对比pathlib面向对象方法与os.path传统接口的实现逻辑,并提供Jupyter及交互式环境下的安全回退方案与路径拼接最佳实践,帮助开发者彻底解决相对路径解析失败问题。
本文详细解析Python文件读写的核心流程,从open()函数的常用模式切入,重点讲解利用with语句实现自动资源回收的安全语法。涵盖read系列读取API、write方法写入技巧及二进制操作注意事项,最后通过日志管理脚本演示完整的工程化应用,助力开发者高效处理文本与数据文件。
本文演示如何利用Python内置的os与shutil库,通过获取参考目录文件名、拼接源文件路径并调用移动函数,实现将大文件夹中特定图片快速迁移至独立目标目录。代码已整合循环遍历、异常捕获与执行状态统计,保障批量操作的安全与可追溯。
本文介绍如何利用Python编写自动化脚本,实现USB驱动器插入时自动复制指定类型文件。通过psutil获取可移动磁盘列表,结合shutil进行文件拷贝,并支持速度限制与重复检测。脚本持续监控新插入设备,将图片及文本文件安全备份至目标路径,提升数据管理效率。