

Python文件读写实战指南:从基础文本到CSV JSON处理
掌握Python文件读写的核心方法,可覆盖纯文本处理到CSV、JSON等结构化数据的日常开发需求。本文梳理了基于open函数的基础读取与写入操作,对比了全量读取与按行遍历的内存差异,并详解csv与json模块的标准用法,帮助开发者快速匹配不同场景的最佳实践。
2026-10-12
6

掌握Python文件读写的核心方法,可覆盖纯文本处理到CSV、JSON等结构化数据的日常开发需求。本文梳理了基于open函数的基础读取与写入操作,对比了全量读取与按行遍历的内存差异,并详解csv与json模块的标准用法,帮助开发者快速匹配不同场景的最佳实践。
面对GB级文本、CSV或二进制文件,一次性加载极易引发内存溢出。本文系统梳理Python中高效处理大型文件的7种核心方案,涵盖逐行迭代、固定分块读取、内存映射、Pandas/Numpy分批解析及随机访问技巧。提供完整代码模板与适用场景对照,帮助开发者根据数据类型灵活选型,显著提升I/O性能与程序稳定性。
本文深入讲解如何利用 Python 内置 iter 函数创建迭代器,实现高效逐行读取文件的方法。通过基础示例、自定义 sentinel 终止条件及性能对比分析,帮助用户针对不同文件大小和场景选择最佳读取策略,有效避免内存溢出问题。
本文详细解析 Python 标准库 pathlib 模块的核心应用。对比传统 os 模块,逐步演示如何利用 Path 对象实现安全的路径拼接、目录增删、属性解析、存在性校验及高效读写与通配符搜索,助开发者编写更简洁稳定的文件系统交互代码。
Python 处理本地数据时,常需自动获取目录文件列表以替代繁琐的手动筛选。本文基于标准库 os,详细演示如何精准提取单层目标文件、递归收集多级子目录内容,并结合实际业务流完成文件批量重命名。代码附带路径安全校验与异常处理机制,帮助开发者快速搭建稳定的自动化数据预处理管道。
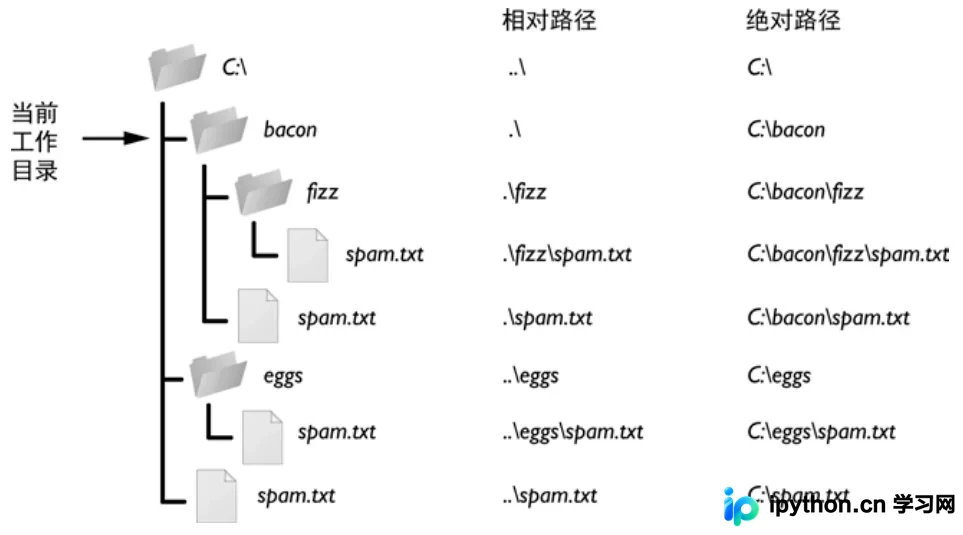
本文详解Python中文件路径的核心概念与常用操作方法。涵盖绝对路径与相对路径的区别、跨平台路径表示规范,以及使用os.path和glob模块进行目录创建、路径拼接拆分与通配符匹配。结合年月日尺度及内部元数据排序的实战代码,帮助开发者高效管理多文件批量处理流程。
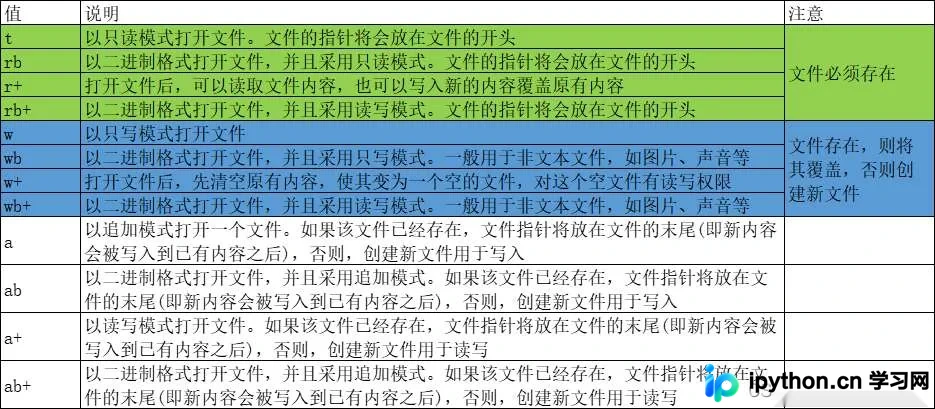
本文系统化梳理 Python 文件读写核心流程,详解 open 函数多模式配置、read 与 readlines 场景化选取,以及 tell 与 seek 字节级指针控制,附参数对照与完成状态校验标准,助力快速构建稳定数据存取模块。
在 Python 中处理外部文本数据时,需依赖内置模块完成安全读写。本文演示如何通过 open 函数结合 with 语句建立文件连接,详细拆解 read、readlines 用于提取内容,以及 write、writelines 用于持久化输出的操作逻辑。附带路径存在性检查与模式参数说明,确保脚本在不同工作目录下稳定运行。
本文详解如何利用 Python 内置 struct 模块进行结构化二进制数据的打包与解包。涵盖格式化字符串编写、字节序与对齐控制,以及 rb/wb 文件模式的操作细节。提供标准代码示例与常见报错排查方案,帮助开发者高效处理底层数据流,彻底规避文本模式导致的截断与跨平台换行符转换问题。
针对杂乱无章的文件命名痛点,本教程演示如何利用Python内置库自动抓取文件修改时间,并按标准化格式重写文件名。通过递归遍历目录树并构建新旧路径对照表,可在彻底保留原始文件夹层级的前提下完成清理任务。文末附带防覆盖机制与终端调试技巧,助力开发者安全落地自动化流程。
本文介绍利用Python标准库urllib实现文件路径与URL相互转换的具体方法。通过调用pathname2url和url2pathname函数,可完成路径到URL格式及反向的转换操作,适用于需要处理本地文件路径与网络资源地址映射的场景。
Python 标准库 fileinput 模块专为高效迭代读取一个或多个文本文件而设计。它提供逐行遍历能力,支持直接原地修改文件并自动生成备份,同时可实时获取文件名与行号等元信息。本文详解其核心参数、内置方法,并提供多文件批处理、正则过滤与替换的完整实战代码,适用于日志分析、批量文本清洗及命令行自动化脚本开发。