

Python批量处理文件与文件夹的脚本实现
本文提供基于Python的批量处理文件与文件夹的完整代码示例。通过os.walk遍历目录,结合shutil实现文件的批量移动至新建子文件夹,以及根据特定关键词批量删除同名文件夹的功能。代码包含详细注释,适用于需要自动化整理大量分散文件的场景,可直接替换路径参数运行。
2026-10-13
6

本文提供基于Python的批量处理文件与文件夹的完整代码示例。通过os.walk遍历目录,结合shutil实现文件的批量移动至新建子文件夹,以及根据特定关键词批量删除同名文件夹的功能。代码包含详细注释,适用于需要自动化整理大量分散文件的场景,可直接替换路径参数运行。
本文介绍 Python 中扫描目录的两种核心方法:os.listdir 和 os.walk。os.listdir 返回当前路径文件名列表,需递归获取子目录文件;os.walk 则通过三元组 (root, dirs, files) 高效遍历目录树。文章还列举了 os.path 模块中分离文件名、判断存在性及获取大小等常用辅助方法,帮助开发者批量处理文件与目录。
本文介绍了一个使用Python实现的简单文件夹同步脚本。通过结合os、shutil和filecmp模块,该程序能够检测两个指定目录间的差异,并自动将左侧目录的新增或修改文件同步至右侧目录。代码包含基础的日志记录功能,适合用于本地开发环境下的文件备份与同步场景。
本文详细介绍Python中csv模块的基本使用方法,涵盖通过csv.reader读取CSV文件、使用csv.writer写入普通数据以及利用csv.DictWriter和DictReader处理字典格式数据的完整代码示例,帮助开发者快速掌握CSV文件的创建与解析技巧。
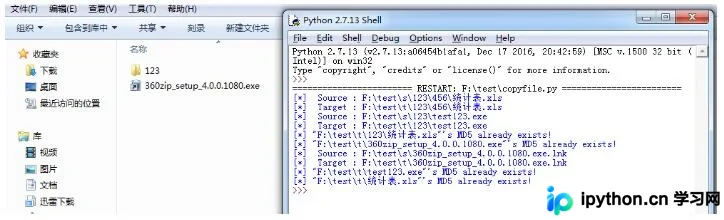
本文详细介绍如何使用Python实现两个文件夹的同步功能。内容涵盖从基础的系统命令对比,到利用os模块进行递归遍历,再到通过MD5哈希值进行文件去重的完整实现过程。文章提供了分阶段的代码示例,解决多重文件夹处理及重复文件跳过问题,帮助开发者构建高效的文件夹同步工具。
本文介绍如何使用Python实现大文件的分割与合并功能。通过定义FileOperationBase类,利用splitFile方法按指定chunksize将文件拆分为多个块,并使用mergeFile方法将这些块重新合并为原始文件。代码包含详细的注释和异常处理,适用于需要处理大文件传输或存储的场景。
本文详细解析Python中文件处理的三个核心函数:list、read和seek。list用于将文件内容按行转换为列表;read支持指定字符数或全量读取文件内容;seek则用于移动文件指针,支持从文件头、当前位置或末尾进行字节级偏移。文章结合代码示例,帮助开发者掌握文件读写与定位技巧。
本文介绍如何在Python中读取指定字节长度的文本内容。通过open打开文件,利用seek设置文件指针偏移量,结合read读取指定字节数。示例展示了从文件起始位置读取第8-16字节,以及从当前位置偏移后读取后续内容的具体代码实现与结果分析。
本文介绍了在已获取图片链接的前提下,使用 Python3 下载网络图片的两种主要方式。第一种通过 urllib2 模块进行文件读写,第二种利用 urllib.request 中的 urlretrieve 方法。文章提供了相应的代码示例,帮助开发者快速实现图片下载功能。
本文深入探讨 Python 文件处理的三种进阶技巧。首先推荐使用 pathlib 模块简化路径操作并兼容旧接口;其次演示如何通过 iter 函数结合生成器实现大文件的高效分块读取,显著降低内存占用;最后讲解如何通过依赖“类文件对象”提升函数的可测试性与通用性,适用于 StringIO 和 subprocess 等多种场景。
本文详解Python中修改文件的两种核心机制:全量加载内存后覆盖与逐行读取重写。通过对比全量处理与逐行处理的代码示例,解析如何利用临时文件配合os模块实现原文件替换,帮助开发者根据文件大小选择合适的修改策略。
本文介绍在Python中处理包含大量数据的大文件时,如何避免全量加载导致内存溢出。通过分段读取与覆盖写入的策略,定位目标行后利用seek和truncate方法实现单行删除,确保低内存占用下完成文件修改操作。