

Python 模拟创建 Seafile 目录操作示例
本文介绍如何使用 Python 模拟创建 Seafile 目录的操作。通过 requests 库进行身份验证,获取 CSRF Token 后,构造 POST 请求并发送 JSON 数据,实现远程目录的创建。
2026-10-13
6

本文介绍如何使用 Python 模拟创建 Seafile 目录的操作。通过 requests 库进行身份验证,获取 CSRF Token 后,构造 POST 请求并发送 JSON 数据,实现远程目录的创建。
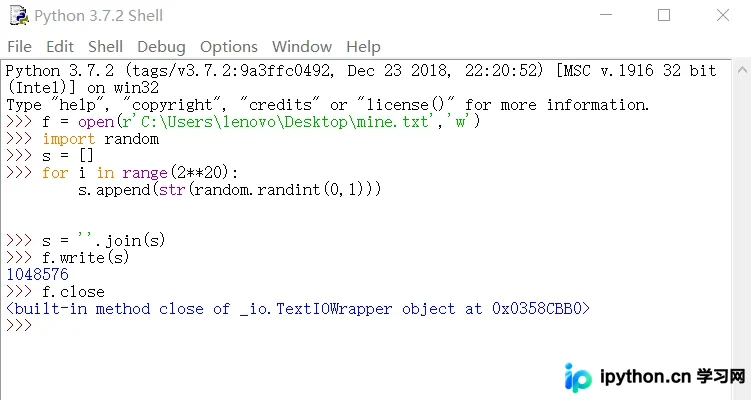
本文详细解析使用Python生成测试数据文件的完整过程。涵盖文件指针f与路径处理、读写模式'r'与'w'的区别,以及random模块的导入。通过构建空列表、循环生成2**20个数据项、利用append追加及join拼接字符串,最终写入文件并调用close保存。
本文详细介绍如何使用Python实现基于本地文件的用户登录与注册功能。通过封装文件读取与写入方法,结合面向对象编程思想,实现了用户信息的持久化存储与验证逻辑。代码包含账号密码的输入处理、文件数据解析及登录状态判断,适合Python初学者理解文件IO与基础业务逻辑的结合应用。
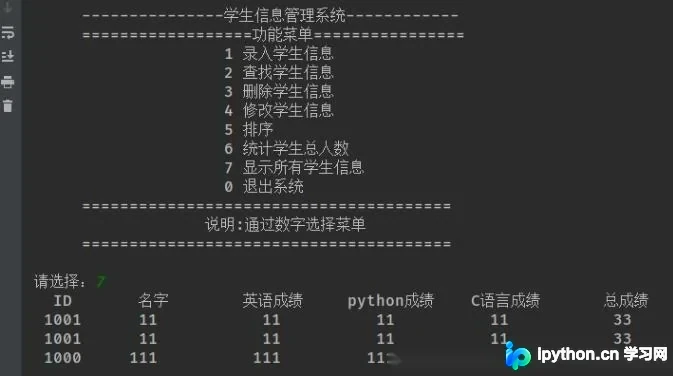
本文详细介绍使用Python编写的简易学生信息管理系统。系统涵盖录入、查询、删除、修改、排序、统计及显示全部信息等功能,数据持久化存储于文本文件。文章逐段解析核心代码逻辑,包括主菜单交互、文件读写处理及异常捕获机制,适合Python初学者理解面向对象编程思想与文件IO操作的实际应用。
本文介绍使用Python Tkinter模块开发的简易成绩录入系统。系统包含学生类定义、成绩录入、查询、排序及退出功能,并通过all_student.txt和all_lesson.txt两个文本文件分别存储学生基本信息与课程字典数据,实现数据的持久化保存与读取。
本文介绍Python中读取文件的核心方法。通过open()函数指定文件名,利用with语句自动关闭文件以节省资源。文章详细说明了如何区分相对路径与绝对路径来定位不同目录下的文件,帮助初学者掌握文件操作的基本流程与注意事项。
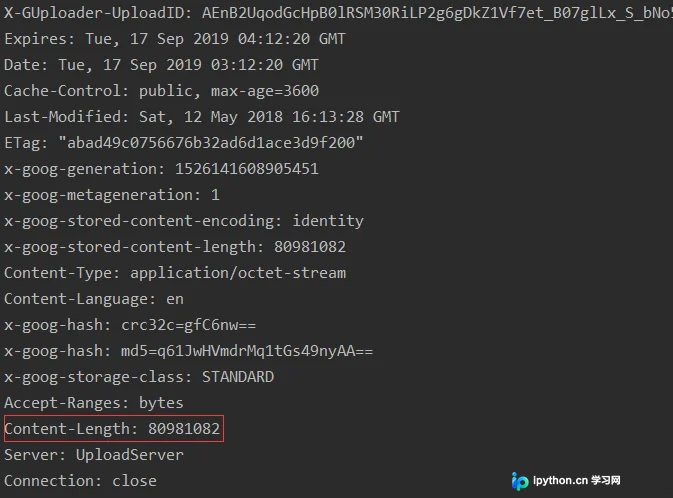
本文介绍在Python3中如何使用urllib模块获取远程URL的文件大小。重点解决urllib2迁移至urllib.request后的代码适配问题,并指出服务器返回的Content-Length头字段大小写敏感导致的获取失败现象,提供修正后的完整示例代码。
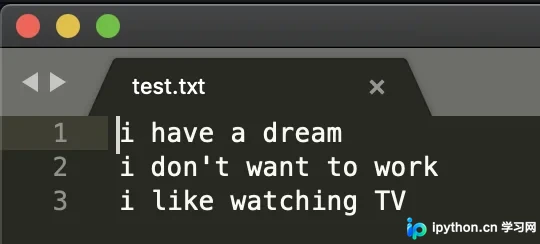
本文详细解析Python中open函数的基本用法,涵盖w、r、a等多种文件打开模式及二进制操作。通过示例演示readline与readlines的区别,讲解如何去除换行符,并介绍文件写入与关闭的标准流程,帮助开发者掌握基础文件IO操作。
本文介绍了在Python 3.6.1环境下实现文件复制及带延时功能的批量复制脚本。通过shutil模块完成简单文件重命名复制,并扩展加入time模块实现循环中的延时控制,适用于测试客户端报文传输速率等场景。
针对系统自带复制功能处理2000G海量数据耗时过长的问题,本文提供基于Python 2.7的两种自定义脚本方案。CopyFiles1实现目录结构的完整镜像复制,保持文件层级美观;CopyFiles2则支持按格式筛选文件并扁平化存放至目标目录,虽结构混乱但速度极快。通过对比两种方法,帮助用户根据实际需求选择高效的批量复制策略。
本文提供基于Python的批量处理文件与文件夹的完整代码示例。通过os.walk遍历目录,结合shutil实现文件的批量移动至新建子文件夹,以及根据特定关键词批量删除同名文件夹的功能。代码包含详细注释,适用于需要自动化整理大量分散文件的场景,可直接替换路径参数运行。
本文介绍 Python 中扫描目录的两种核心方法:os.listdir 和 os.walk。os.listdir 返回当前路径文件名列表,需递归获取子目录文件;os.walk 则通过三元组 (root, dirs, files) 高效遍历目录树。文章还列举了 os.path 模块中分离文件名、判断存在性及获取大小等常用辅助方法,帮助开发者批量处理文件与目录。