

Python实现文件夹同步:从基础复制到MD5去重

本文详细介绍如何使用Python实现两个文件夹的同步功能。内容涵盖从基础的系统命令对比,到利用os模块进行递归遍历,再到通过MD5哈希值进行文件去重的完整实现过程。文章提供了分阶段的代码示例,解决多重文件夹处理及重复文件跳过问题,帮助开发者构建高效的文件夹同步工具。
系统原生命令与Python实现对比
在Windows或Linux系统中,若仅需实现两个文件夹的简单同步,直接使用系统自带的复制命令并添加相应参数即可满足基本需求。
Windows环境下,可以使用xcopy命令配合参数进行复制。
xcopy 源文件夹\* 目标文件夹 /s /e /yLinux环境下,通常使用cp命令配合递归参数进行目录复制。
cp -r 源文件夹/* 目标文件夹为了获得更灵活的控制及增强功能(如去重),下面将使用Python语言来实现上述基本功能,并在此基础上进行优化。
基础文件复制实现
第一步:将源文件夹中的文件复制至目标文件夹。
实现文件夹同步的基本思路是:首先遍历源文件夹中的所有条目,并将源文件夹中的文件复制到目标文件夹中。
在Python中,可以使用os模块中的listdir函数来遍历文件夹内容。
import os

path_s = 'F:\\test\\s'
path_t = 'F:\\test\\t'

for filename in os.listdir(path_s):
 filename_s = path_s+os.sep+filename
 print '[*] Source :',filename_s
 filename_t = path_t+os.sep+filename
 print '[*] Target :',filename_t
 with open(filename_s,'rb') as f_s:
 with open(filename_t,'wb') as f_t:
  f_t.write(f_s.read())
然而,上述简单方法并未考虑源文件夹中可能包含子文件夹甚至多层嵌套文件夹的情况,因此需要更复杂的处理逻辑。
处理多重文件夹的递归逻辑
第二步:处理源文件夹中存在多重文件夹的情况。
一种直观的解决思路是:在遍历源文件夹内的文件时,首先判断当前条目是普通文件还是文件夹。如果当前条目是文件夹,则进入该文件夹继续遍历其中的文件;若其中仍包含子文件夹,则继续递归遍历。通过这种递归方法,可以处理任意层级的目录结构,具体代码如下:
import os


path_s = 'F:\\test\\s'
path_t = 'F:\\test\\t'

def copy_file(paths,patht):
 for filename in os.listdir(paths):
 filename_s = paths+os.sep+filename
 filename_t = patht+os.sep+filename
 if os.path.isdir(filename_s):
  if not os.path.exists(filename_t):
  os.mkdir(filename_t) #在目标文件夹中创建对应的文件夹
  copy_file(filename_s,filename_t) # 递归
 else:
  print '[*] Source :',filename_s

  print '[*] Target :',filename_t
  with open(filename_s,'rb') as f_s:
  with open(filename_t,'wb') as f_t:
   f_t.write(f_s.read())


copy_file(path_s,path_t)
至此,基础的文件夹复制功能已经实现。
基于文件存在的简单去重策略
第三步:避免复制目标文件夹中已存在的文件。
一个简单的方法是在向目标文件夹复制文件之前,先利用os.path.exists函数判断该文件是否已经存在。
import os


path_s = 'F:\\test\\s'
path_t = 'F:\\test\\t'

def copy_file(paths,patht):
 for filename in os.listdir(paths):
 filename_s = paths+os.sep+filename
 filename_t = patht+os.sep+filename
 if os.path.isdir(filename_s):
  if not os.path.exists(filename_t):
  os.mkdir(filename_t)
  copy_file(filename_s,filename_t)
 else:
  if os.path.exists(filename_t):
  print '[*] "%s" already exists! ' % filename_t
  else:
  print '[*] Source :',filename_s

  print '[*] Target :',filename_t
  with open(filename_s,'rb') as f_s:
   with open(filename_t,'wb') as f_t:
   f_t.write(f_s.read())

copy_file(path_s,path_t)
这种方法虽然避免了一部分已有文件的重复复制操作,减少了不必要的读写开销,但无法消除内容相同但名称或路径不同的重复文件。
基于MD5哈希的高级去重方案
第四步:利用MD5值判定重复文件。
目前判断两个文件是否相同,除了逐字节对比这种耗时较长的方法外,常用且简单的办法是利用MD5或CRC校验,或者按一定规律提取文件指定位置的数据块进行对比。
本文采用文件的MD5值作为判断依据。具体做法是:将目标文件夹中已有文件的MD5值保存到列表或字典中,每在源文件夹中读取一个文件时,判定该文件的MD5值是否已存在于MD5列表中。若不存在,则执行复制操作,并将该文件的MD5值写入列表。
import os
import hashlib

path_s = 'F:\\test\\s'
path_t = 'F:\\test\\t'
list_file = {}

def create_file_list(path):
 for name in os.listdir(path):
 filename = path+os.sep+name
 if os.path.isdir(filename):
  create_file_list(filename)
 else:
  with open(filename,'rb') as f:
  md5 = hashlib.md5(f.read()).hexdigest()
  if md5 not in list_file:
   list_file[md5] = 1

def copy_file(paths,patht):
 for filename in os.listdir(paths):
 filename_s = paths+os.sep+filename
 filename_t = patht+os.sep+filename
 if os.path.isdir(filename_s):
  if not os.path.exists(filename_t):
  os.mkdir(filename_t)
  copy_file(filename_s,filename_t)
 else:
  if os.path.exists(filename_t):
  print '[*] "%s" already exists! ' % filename_t
  else:
  with open(filename_s,'rb') as f_s:
   data = f_s.read()
   file_md5 = hashlib.md5(data).hexdigest()
   if file_md5 not in list_file:
   list_file[file_md5] = 1
   print '[*] Source :',filename_s
   print '[*] Target :',filename_t
   with open(filename_t,'wb') as f_t:
    f_t.write(data)
   else:
   print '[*] "%s"\'s MD5 already exists! ' % filename_t

create_file_list(path_t)
copy_file(path_s,path_t)
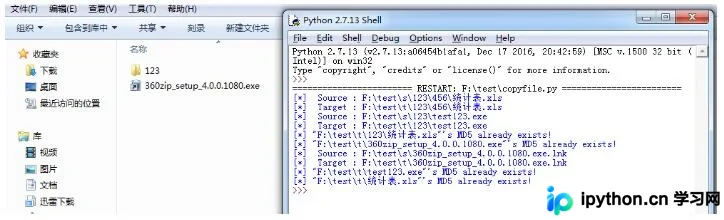
运行结果如图所示,内容相同的几个文件,只有第一次读取到的时候才写入目标文件夹,其他路径下内容相同的文件并未被复制到目标文件夹。
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









