Python爬虫实战:异常处理与BeautifulSoup标签过滤详解
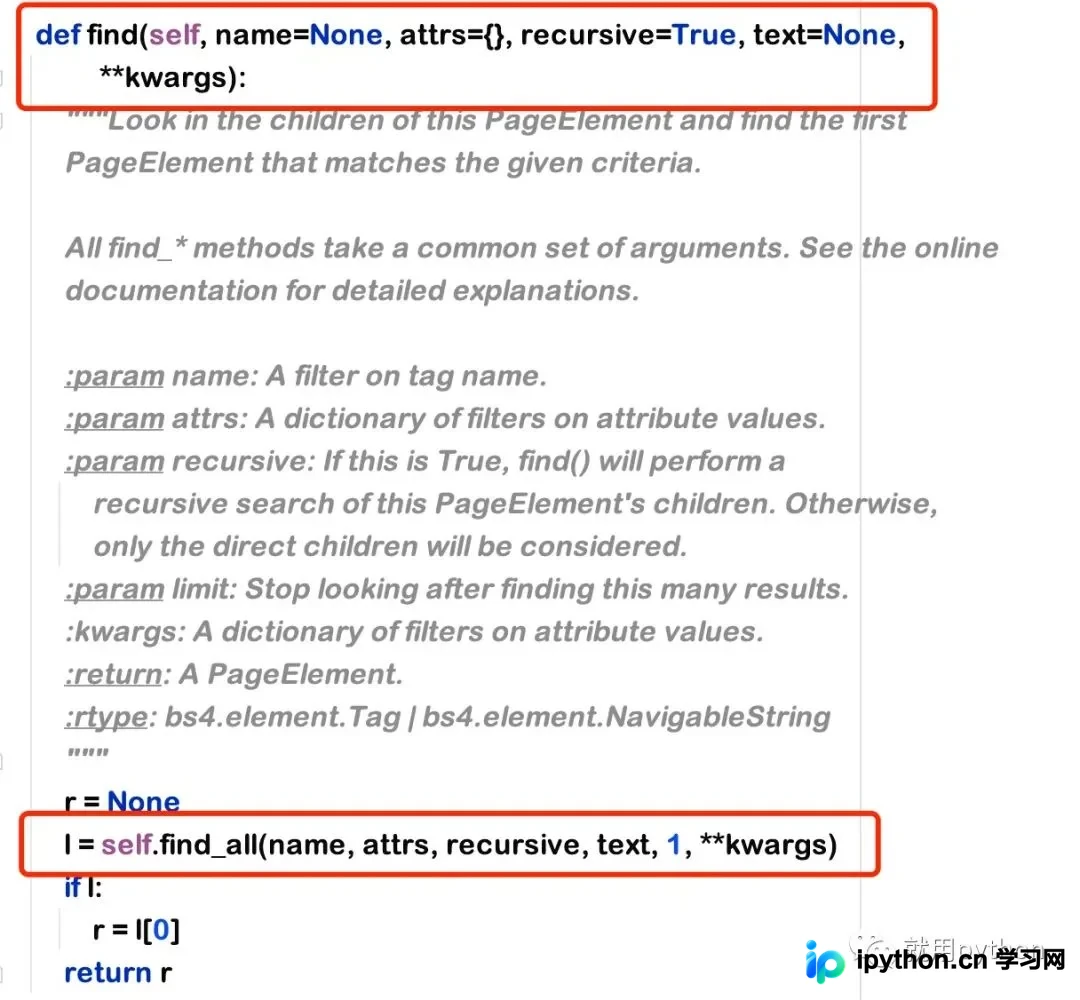
本文详细解析Python爬虫开发中的关键技巧,涵盖网络请求阶段的HTTPError与URLError异常处理,以及BeautifulSoup解析HTML时的NoneType错误防御。深入讲解find与find_all方法的区别、参数配置(如limit、recursive)及属性过滤技巧,通过豆瓣电影数据抓取实例,展示如何高效获取特定标签文本并处理常见编码问题,帮助开发者提升爬虫稳定性与数据提取精度。

本文详解Python中文件读取、写入及追加模式的使用方法,涵盖open、read、readlines等核心函数。深入解析try-except异常处理机制,包括ZeroDivisionError和FileNotFoundError的处理及静默失败技巧。最后介绍利用json模块进行数据持久化存储与重构的最佳实践,帮助开发者掌握文件IO与错误管理的核心技能。

本文介绍如何使用Python的python-docx库在Word文档中插入本地图片。通过示例代码展示基础插入方法,并针对插入特定格式图片时可能出现的异常问题,提供基于PIL库进行格式转换的解决方案,确保图片能正确嵌入Word文档。

本文介绍Python读取含中文文件路径时常见的编码错误及两种解决方案:拆分路径单独编码和对完整路径使用Unicode格式。此外,还记录了在使用pywin32将Word文档转换为Docx时遇到的RPC服务器不可用报错,通过os.path.abspath获取绝对路径成功解决该问题。
本文详解Python Selenium中的异常处理机制,涵盖超时和节点未找到等常见错误的捕获方法。通过try-except-finally结构确保浏览器资源释放,并深入解析sys.exit()在脚本退出时的行为逻辑,帮助开发者构建更健壮的自动化测试脚本。
本文详解Python中raise语句的语法与作用,分析异常触发与传递流程。通过内置异常、自定义异常及异常链携带信息的三个实战示例,展示如何精准抛出和处理错误,提升代码稳定性与调试效率。
本文详细介绍 Python 中 os.remove() 方法的语法、参数及返回值。重点解析其仅适用于删除文件、无法处理非空目录的特性,并通过代码实例演示正确用法及常见报错场景,帮助用户掌握文件清理的最佳实践。
本文深入解析Python中try-except-finally语句的执行逻辑,重点阐述finally块在资源回收中的关键作用。无论try块是否发生异常,finally代码块均会被执行,确保文件、数据库连接等物理资源被正确关闭。通过对比不同异常场景下的执行流程,说明为何finally是处理清理工作的最佳选择,并展示未捕获异常时解释器的行为。
本文深入解析Python中的异常处理机制,涵盖try-except完整语法、异常向调用方传递的规则以及使用raise主动抛出异常的方法。同时详细介绍文件读写操作,重点说明文件指针变化对多次读取的影响,并提供小文件一次性复制与大文件逐行复制的代码实现,帮助开发者掌握稳健的文件处理技巧。
本文详细介绍 Python 中获取异常信息的三种主要方式。通过 str(e) 仅获取错误描述,使用 repr(e) 获取包含类型的完整异常对象字符串,以及利用 traceback 模块获取最详尽的堆栈跟踪信息。文章对比了 print_exc 与 format_exc 的区别,并演示如何将异常日志写入文件,帮助开发者快速定位代码错误。
本文深入解析Python中的异常处理机制,涵盖异常捕获的基本原理、多分支与通用异常的写法,以及使用raise和自定义Exception类创建特定错误。同时探讨assert断言的使用,并强调合理运用异常处理以提升代码健壮性与可读性的最佳实践。
本文详细介绍Python中pickle模块的四大核心方法:dumps、dump、loads和load。内容涵盖pickle支持的数据类型、协议版本差异(0至4)、文件读写模式要求以及PickleError等常见异常处理。通过具体代码示例,帮助开发者掌握Python对象的序列化和反序列化技巧,适用于数据持久化存储场景。