

Scrapy异常处理实战:捕获HTTP错误与代码异常
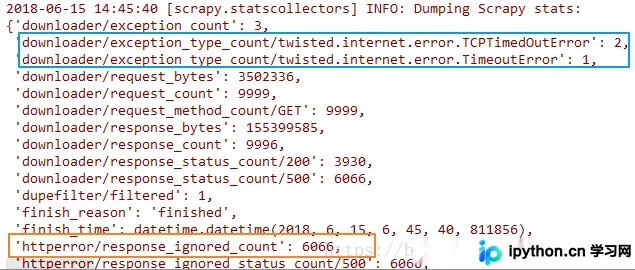
本文详解Scrapy中处理下载错误的两种主要场景:HTTP状态码异常(如403/500)与代码执行异常。通过深入分析RetryMiddleware源码,揭示process_response与process_exception的工作机制,并提供一个自定义中间件模板,用于兜底捕获未重试成功的请求,确保爬虫在长时间运行时的稳定性与数据完整性。
2026-10-14
6

本文详解Scrapy中处理下载错误的两种主要场景:HTTP状态码异常(如403/500)与代码执行异常。通过深入分析RetryMiddleware源码,揭示process_response与process_exception的工作机制,并提供一个自定义中间件模板,用于兜底捕获未重试成功的请求,确保爬虫在长时间运行时的稳定性与数据完整性。
本文介绍利用Python装饰器实现代码异常监控的方法。通过记录异常发生时间并写入日志文件,结合滑动窗口算法判断指定时间段内的异常频率。当短时间内异常次数达到阈值时触发报警,否则视为正常波动,从而有效过滤偶发性干扰,实现精准的自动化异常检测。
本文详细介绍Python中raise语句的基本使用方法。当程序出错时,Python会自动引发异常,但开发者也可通过raise手动触发。文章解析了raise的语法格式,包括异常类型、参数及可选的跟踪对象,并通过具体代码实例演示了如何自定义异常触发条件及后续代码的执行逻辑。
本文详细解析Python Selenium自动化测试中三种常用的断言实现方式。通过if...else判断、try...except异常捕获以及基于unittest框架的assert系列方法,帮助开发者灵活处理页面元素验证。文章结合具体代码示例,对比各方法的适用场景与优缺点,为Web自动化测试提供实用的断言策略参考。
本文深入解析Python中异常嵌套的处理逻辑,包括内外层异常类型的匹配与传播规则。详细讲解except通配符捕获所有异常的潜在风险,以及使用raise ... from ...关联异常链的机制。通过多个代码示例,展示try-finally在嵌套结构中的执行顺序及异常被内部或外部捕获时的不同行为,帮助开发者掌握复杂的错误处理场景。
本文探讨如何在Python的lambda函数中抛出异常。由于直接raise会触发SyntaxError,文章列举了包括生成器throw、除零错误、索引越界及exec执行等多种替代方案,并对比了Python 2与3版本的底层代码构造技巧,帮助开发者在特定场景下灵活使用lambda。
本文详细介绍在Python中判断文件结束符(EOF)的两种常用方法。不同于C语言直接使用scanf返回值,Python主要通过捕获EOFError异常(使用try-except结构)或遍历sys.stdin对象来实现。文章提供了具体的代码示例及执行流程解析,帮助开发者正确处理标准输入流的结束状态。
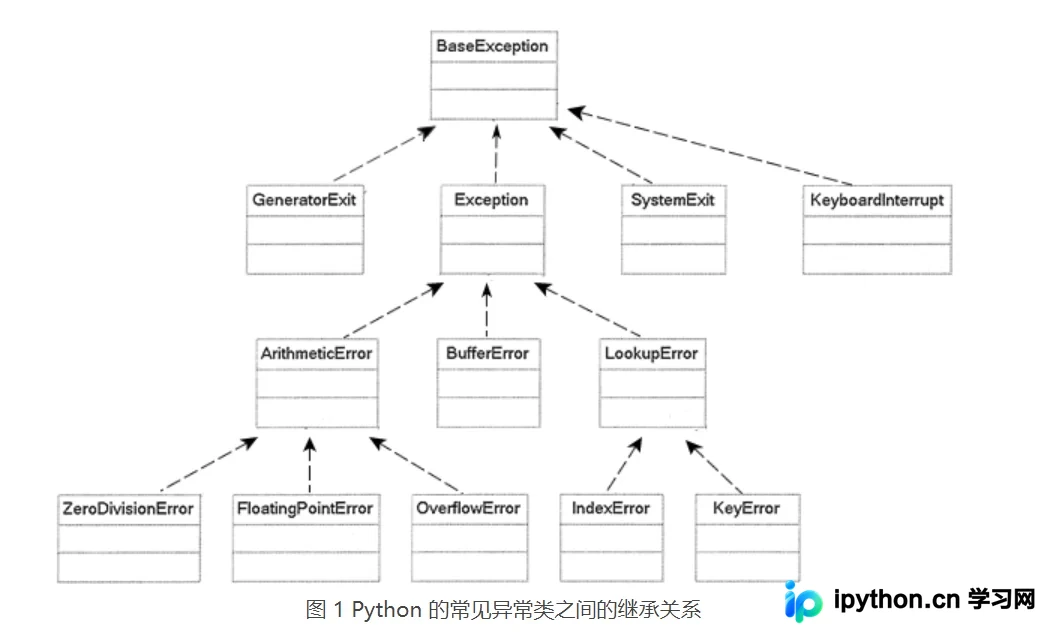
本文深入解析Python中try-except异常处理的底层逻辑,重点阐述Exception作为所有标准异常基类的继承关系。通过代码实例说明解释器如何根据异常类型匹配对应的except块,并强调处理所有异常的except块必须置于末尾且子类在前、父类在后的排序规则,帮助开发者编写更健壮的异常处理代码。
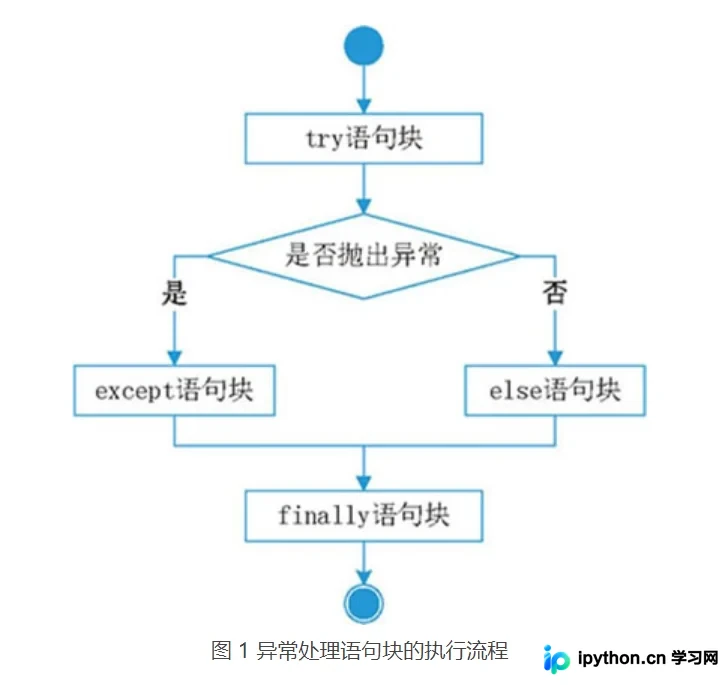
本文详细解析Python异常处理的完整语法结构,涵盖try、except、else及finally块的使用规则与执行顺序。重点阐述finally块的强制执行特性及其在方法中止语句(如return、raise)中的优先级逻辑,通过代码实例说明避免在finally中使用return的重要性,帮助开发者掌握Python错误处理的正确实践。
本文介绍如何在Python中通过sys模块的exc_info()方法获取详细的异常信息。该方法返回包含异常类型、实例和回溯对象的元组,结合traceback模块可打印完整的错误堆栈,包括文件名、行号及具体代码,从而辅助程序调试与问题定位。
本文详细介绍Python中traceback模块的使用方法,用于获取异常传播轨迹。通过示例演示如何追踪异常源头,解析print_exc()和format_exc()函数的区别与参数,并展示如何将异常信息输出至控制台或指定文件,帮助开发者快速定位程序错误。
本文详细解析 Python 中 Traceback 错误信息的结构与阅读方法。通过 NameError、TypeError 及嵌套异常等实例,展示如何从最后一行异常类型向上追溯至具体代码行,帮助开发者快速定位拼写错误、参数不匹配及逻辑异常,提升 Python 代码调试效率。