

Python文件字节处理实战:读写、编码与转换详解
本文详细讲解Python中如何使用字节模式处理文件。通过添加mode参数'b',文件方法将返回bytes对象。示例展示了如何识别PNG文件头,以及如何将文件字节流转换为十六进制字符串、Base64编码,并将十六进制数据还原为二进制文件写入,涵盖常见文件处理场景。
2026-10-12
3

本文详细讲解Python中如何使用字节模式处理文件。通过添加mode参数'b',文件方法将返回bytes对象。示例展示了如何识别PNG文件头,以及如何将文件字节流转换为十六进制字符串、Base64编码,并将十六进制数据还原为二进制文件写入,涵盖常见文件处理场景。
在Python中,print语句前加u表示定义Unicode字符串。该前缀不仅适用于中文,也适用于任何字符串,用于指定Unicode编码。英文字符通常无需此标识,而中文字符若未明确编码易出现乱码。建议统一采用UTF-8编码以确保兼容性。
本文详解 Python 字符串核心操作。涵盖驻留机制原理、字符查询与替换、大小写对齐、切片比较及三大格式化方案,并梳理 Unicode 编码转换规范。掌握相关方法与底层逻辑,可显著提升文本处理效率并规避性能陷阱。
在 Web 开发与安全处理中,经常需要将 HTML 原始字符串转换为安全的实体编码。本文将详细演示如何利用 Python 标准库轻松完成 HTML 字符转义,确保特殊符号不被浏览器误解析,附带可直接运行的测试代码。
本文详细解析了C++调用Python时出现中文乱码的原因,并提供完整的解决方案。通过设置执行字符集和实现GBK到UTF-8的转换函数,确保中文字符在跨语言调用中正确传递。
本文详细解析Python中字符编码转换的原理与操作。重点对比Python 2与Python 3在字符串处理上的差异,通过具体代码示例演示GBK与UTF-8编码的互转过程。文章涵盖encode与decode的使用场景,以及不同版本中字符串类型的变化,帮助开发者解决乱码问题。
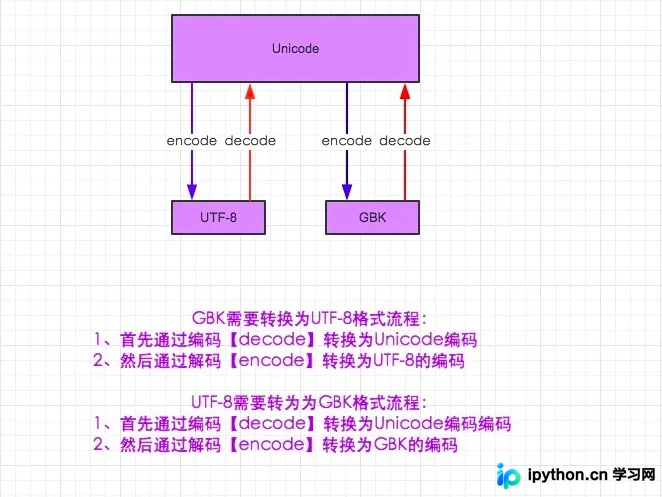
本文详解 Python3 中处理中文文件读写的方法。Python3 默认使用 Unicode 字符串,读写文件时需指定编码(如 utf-8 或 gb2312)。通过 codecs.open 可简化编码处理,避免手动 decode/encode 转换。文章提供具体代码示例,展示如何读取、写入及转换不同编码的文本文件,解决中文乱码问题。