

Python 3.5 实现检测路由器流量并写入 txt 的方法实例

本文介绍使用 Python 3.5 检测路由器流量并保存至 txt 文件的简单方法。重点解决网页编码识别(如 ISO-8859-1)及 bytes 转 str 的问题,演示利用 chardet 库、split 截取字符串及 open 函数处理换行符的技巧,适合初学者参考。
前言
本文主要介绍如何利用 Python 3.5 检测路由器流量并将其写入 txt 文件。内容旨在为读者提供参考与学习,以下是详细步骤介绍。
运行环境:Windows 10 系统,Python 3.6。
代码实现非常简洁。
- 未涉及模拟登录功能。
- 未进行网页标签过滤。
- 未使用多线程技术。
- 文本处理仅涉及字符串截取操作。
- 实现了本地文本写入功能。
代码之所以简单,是因为该路由器页面质量较差,无需复杂处理。不过这种写法适合初学者阅读,后续计划尝试添加更多功能。
首先分析需求,作为新手,应将复杂问题简单化、模块化,理清思路后逐步实现,最后进行整合。
1、获取数据
- 网页编码处理不当会引发报错,需注意相关函数。
- 编码转换:read() 方法获取的数据非字符串类型,需预先处理。
2、处理数据
- 方法多样,如正则表达式、字符串截取等,选择适合的方法即可。虽然正则表达式功能强大,但有时较为晦涩难懂。
3、保存数据
- 注意 Windows 与 Linux 系统下路径写法的差异。
- 写入文件时需处理编码类型。
重点讲解遇到的常见问题。
通常右键查看页面编码,如图所示,国外网站的编码格式往往比较特殊。
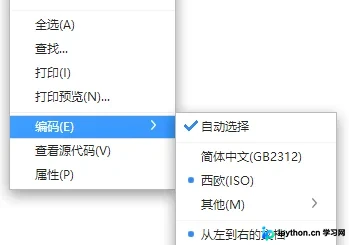
当时对此感到困惑,不知如何处理。
此时需要用到 chardet 库来判断编码类型。以百度为例,可自行搜索安装 Python 第三方库的方法,此处不再赘述。
import chardet
import urllib.request
html = urllib.request.urlopen('http://www.baidu.com/').read()
print (chardet.detect(html))
得到的结果如下所示:
C:\python\python.exe D:/python/test/2.py
{'encoding': 'utf-8', 'confidence': 0.99, 'language': ''}

Process finished with exit code 0
1. 获取字符串
import urllib.request
import os
from bs4 import BeautifulSoup
import time
def getHtml(url):
 html = urllib.request.urlopen(url).read()
 return html
#获取字符串,因为我在国外,路由器low到爆,编码格式也蛋疼了我很久
html = getHtml("http://192.168.0.254/pub/fbx_info.txt")
#将read()获取的是bytes编码转化成str
html = html.decode("ISO-8859-1")
由于访问的是欧洲网站,获取到的网页编码为 【ISO-8859-1】。
由于使用 read() 方法读取,获取到的是 bytes 类型,此时需转换为 str 类型才能进行后续处理,否则会出现以下错误。
TypeError: a bytes-like object is required, not 'str'
这里可以使用 decode() 方法进行处理。
html = html.decode("ISO-8859-1")
使用 type() 方法检测编码类型。
print(type(html))
反馈结果如下。
<class 'str'>
2. 处理字符串
#操作字符串
html = html.split('WAN')[1].split('Ethernet')[0]
time = time.strftime("%Y-%m-%d %H:%M:%S", time.localtime())
#因为使用记事本,在记事本中换行只认\r\n
str = time+html+"\r\n"
这里使用的是 split() 方法,建议查阅手册学习具体用法,此处不再详细解释。
通过 split() 方法截取所需字符串,然后使用 time() 函数获取当前本地时间,利用 + 连接符将时间与处理后的字符串连接,并在末尾添加换行符 \r\n。由于仅使用记事本,换行符的处理算是一个小坑。
3. 写入 txt 文件
# 保存文件为txt,win环境路径
outfile = open("C:\\Users\\sw\\Desktop\\route.txt","a+",encoding="utf-8",newline='\n')
outfile.write(str)
outfile.close()
print("文件已保存到本地")
关于 open 函数的每个参数,这篇博文讲解得非常清楚详细,感谢博主的整理,大家可以参考,建议收藏。
https://www.jb51.net/article/58002.htm
需要强调两个参数。
encoding 和 newline,因为使用较少,很多文章并未提及。
有人可能会说,这确实很懒。
没错,我就是懒,而且写得不如别人好,何必误导他人。
下面贴上全部代码。
import urllib.request
import os
from bs4 import BeautifulSoup
import time
def getHtml(url):
 html = urllib.request.urlopen(url).read()
 return html

#获取字符串,因为我在国外,路由器low到爆,编码格式也蛋疼了我很久
html = getHtml("http://192.168.0.254/pub/fbx_info.txt")
#将read()获取的是bytes编码转化成str
html = html.decode("ISO-8859-1")
#再次检测编码
#print(type(html))
#操作字符串
html = html.split('WAN')[1].split('Ethernet')[0]
time = time.strftime("%Y-%m-%d %H:%M:%S", time.localtime())
#因为使用记事本,在记事本中换行只认\r\n
str = time+html+"\r\n"
# 保存文件为txt,win环境路径
#print(type(str))
outfile = open("C:\\Users\\sw\\Desktop\\route.txt","a+",encoding="utf-8",newline='\n')
outfile.write(str)
outfile.close()
print("文件已保存到本地")
最初的想法是每秒获取一次流量,写入 txt,再读取 txt 数据绘图。
但因有事暂时搁置,目前仅通过 Windows 计划任务定时运行,勉强凑合使用,日后再学习补充。
总结
以上就是本文的全部内容,希望本文的内容对大家的学习或工作有一定的参考借鉴价值。如有疑问欢迎留言交流,感谢支持。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









