


Node.js 应用在 Ubuntu 上部署并不难,真正麻烦的是服务一旦异常退出、请求报错或日志刷屏,问题到底出在系统环境、进程管理,还是业务代码本身。本文按“先定位层级,再补齐日志能力”的思路展开,带你从系统日志、systemd 与应用日志入手,再到 PM2、Winston 和常见报错处理,建立一套更适合线上环境的追踪方法。
先从系统与应用日志判断问题落点
Ubuntu 系统日志能看出什么
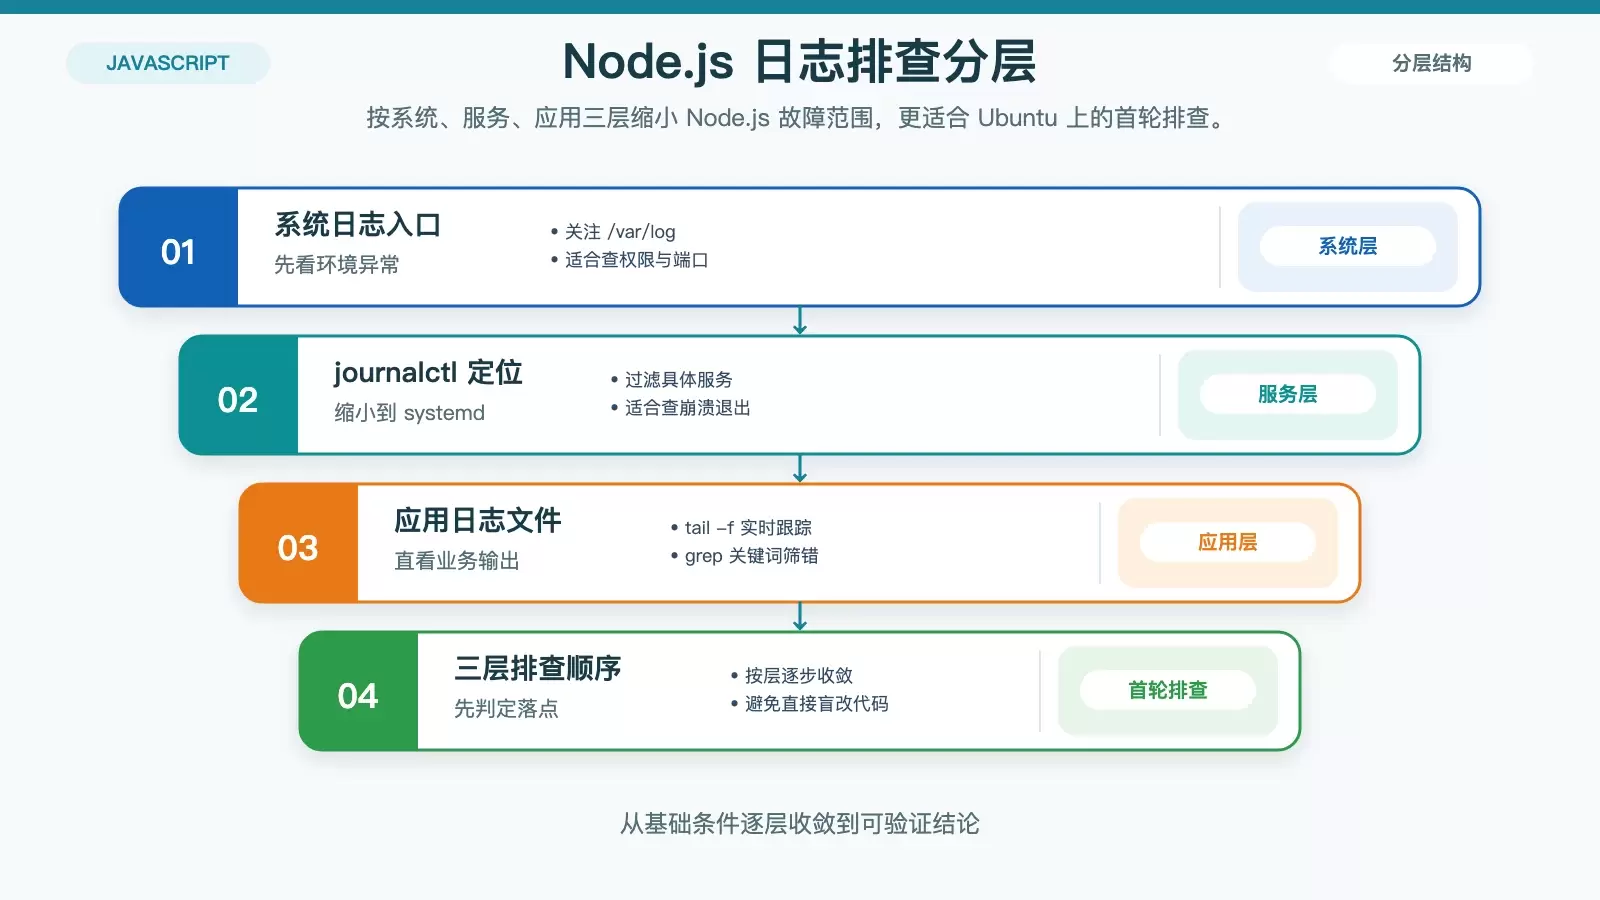
如果 Node.js 进程在 Ubuntu 上运行异常,第一步通常不是直接改代码,而是先确认系统层有没有给出明确信号。像端口冲突、权限不足、底层资源异常这类问题,往往会先出现在 /var/log 下的系统日志中。
常用命令可以先记住这几条:
cat /var/log/syslog:查看系统综合日志,适合先做全局排查。cat /var/log/kern.log:查看内核相关日志,适合排查崩溃是否和内核、驱动或底层资源有关。cat /var/log/error.log:聚焦系统级严重错误,适合确认是否存在环境层异常。
这一步的意义在于先分清楚:问题是不是根本不在 Node.js 代码里,而是环境本身已经报错。
systemd 服务优先用 journalctl
如果你的 Node.js 应用不是手工跑起来的,而是通过 systemd 管理,例如使用 systemctl start your-node-service 启动,那么比起翻系统大日志,更高效的做法是直接查看服务级日志。
journalctl -u your-nodejs-service-name -t "node"
# -u指定服务名,-t过滤"node"标签
journalctl 适合用来确认服务启动失败、进程异常退出、未捕获异常等问题。在线上场景中,只要应用纳入 systemd,这通常就是第一入口,因为它能把问题直接收敛到具体服务。
应用自身日志文件怎么跟
如果应用已经把标准输出和错误输出重定向到文件,那定位速度通常会更快,因为这里保存的是最贴近业务执行过程的日志。
例如下面这种启动方式,就会把输出统一写入 logs/app.log:
node app.js > logs/app.log 2>&1 &
# 将标准输出和错误输出重定向到logs/app.log
排查时可以直接实时追踪:
tail -f logs/app.log
# 实时显示日志末尾新增内容
如果你已经知道错误大概和异常信息有关,也可以先筛关键词:
grep -i "Error" logs/app.log
# -i忽略大小写,筛选含"Error"的行
这种方式适合处理两类场景:一类是问题能稳定复现,你想边操作边看日志;另一类是已经知道错误关键词,需要快速从大量输出中把异常行筛出来。
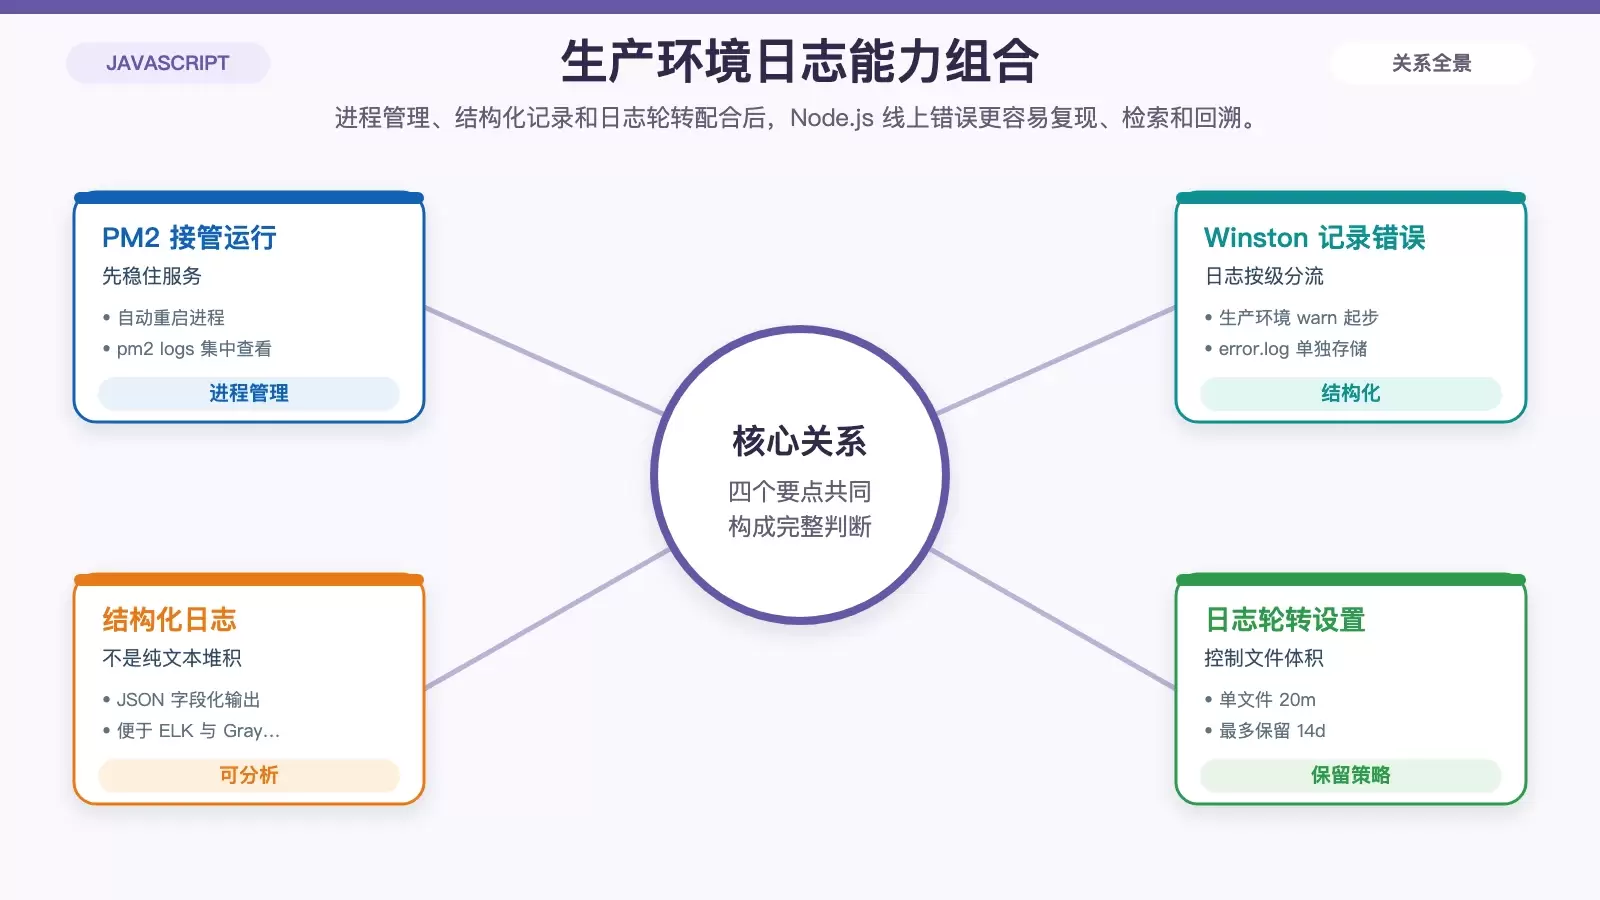
生产环境里,用 PM2 把进程和日志一起管起来
为什么手工追日志不够用
开发环境里,直接跑 node app.js 看报错往往就够了;但到了生产环境,进程崩溃后的自动拉起、日志集中查看、服务重启后的恢复能力,都会变得很重要。只靠手工启动和文件重定向,排查效率通常不稳定,也容易漏掉关键上下文。
这时候可以交给 PM2 来统一管理。它既是 Node.js 进程管理器,也能承担日志入口的角色。
PM2 的基本用法
- 全局安装 PM2:
npm install pm2 -g - 启动应用:
pm2 start app.js --name "my-app" - 查看日志:
pm2 logs my-app - 保存当前进程列表:
pm2 save - 生成开机自启脚本:
pm2 startup
其中最实用的是 pm2 logs my-app。它可以持续输出应用日志和错误堆栈,不需要你自己切换多个文件或手动确认进程状态。对于长期运行的服务来说,这比零散查看单个日志文件更适合日常排障。
如果你的目标是降低线上故障排查成本,PM2 的价值并不只是“能重启”,而是它把进程状态和日志入口放到了同一个管理面上。
代码层补齐错误捕获与结构化日志
用 Winston 替代简单 console 输出
只靠 console.log() 或 console.error(),在生产环境里通常很难满足排查需要。原因很简单:没有分级、没有结构化输出,也不方便后续做检索和归档。更稳妥的做法是接入专门的日志库,例如 Winston 或 Bunyan。
以下是文中给出的 Winston 示例,保留了生产环境日志级别、JSON 输出和错误分文件存储的做法:
const winston = require('winston');
const logger = winston.createLogger({
  level: process.env.NODE_ENV === 'production' ? 'warn' : 'debug', // 生产环境仅记录warn及以上
  format: winston.format.json(), // 结构化日志(便于后续分析)
  transports: [
    new winston.transports.File({ filename: 'logs/error.log', level: 'error' }), // 错误日志单独存储
    new winston.transports.File({ filename: 'logs/combined.log' }), // 所有日志汇总
  ],
});

// 示例:捕获同步错误
try {
  // 业务代码(可能抛出错误)
} catch (error) {
  logger.error('同步错误捕获:', { message: error.message, stack: error.stack }); // 记录错误信息与堆栈
}

// 全局捕获未处理异常
process.on('uncaughtException', (error) => {
  logger.error('未捕获异常:', { message: error.message, stack: error.stack });
  process.exit(1); // 强制退出进程(避免不可控状态)
});

// 全局捕获未处理Promise rejection
process.on('unhandledRejection', (reason, promise) => {
  logger.error('未处理Promise rejection:', { reason, promise });
});
这套配置的重点有三个:一是按环境区分日志级别,避免生产环境被调试信息淹没;二是使用 json() 输出,方便后续接日志平台;三是把严重错误单独写入 logs/error.log,减少筛查成本。
在关键路径记录错误上下文
有了日志库以后,下一步不是“把所有地方都打一遍日志”,而是在最容易丢失上下文的关键点补记录。典型位置包括 HTTP 请求入口、数据库访问、第三方 API 调用和异步任务处理。
例如在 Express 或 Koa 中,可以通过错误处理中间件记录请求维度的信息:
app.use((err, req, res, next) => {
  logger.error(`请求错误 [${req.method} ${req.url}]:`, { error: err.message, stack: err.stack });
  res.status(500).send('Internal Server Error');
});
数据库操作这类高频问题点,也应该记录最基本的执行上下文:
await database.query('SELECT * FROM users')
  .catch(error => logger.error('数据库查询失败:', { query: 'SELECT * FROM users', error: error.message }));
这里真正有价值的,不只是“发生了错误”,而是日志里同时带上请求路径、SQL 语句、堆栈、错误消息等信息。这样回看日志时,才能判断问题发生在什么请求、哪段逻辑、哪一次依赖调用上。
把日志做成可分析、可保留、可告警的形式
结构化日志为什么更适合排查
当日志量增长后,纯文本日志很快就会变得难筛、难聚合。把日志格式化为 JSON,可以直接提升检索和分析效率,也更方便接入 ELK Stack、Graylog 之类的平台。
例如一条结构化错误日志可以写成这样:
{
  "level": "error",
  "message": "数据库连接失败",
  "timestamp": "2025-09-26T10:00:00Z",
  "database": "mysql",
  "error": "Connection refused"
}
相比只输出一句“数据库连接失败”,这种格式更适合后续按字段筛选,比如只看 level=error、只筛选某个数据库、或按时间范围聚合统计。
日志轮转避免单文件失控
如果日志长期追加到同一个文件,最终会带来两个问题:文件过大后查看困难,磁盘空间也可能被持续占用。处理方式通常是做日志轮转,按天或按大小自动切分。
文中的示例使用了 winston-daily-rotate-file:
const DailyRotateFile = require('winston-daily-rotate-file');
const transport = new DailyRotateFile({
  filename: 'logs/application-%DATE%.log',
  datePattern: 'YYYY-MM-DD',
  maxSize: '20m', // 单个文件最大20MB
  maxFiles: '14d', // 保留14天日志
});
const logger = winston.createLogger({
  transports: [transport],
});这里的配置很实用:maxSize: '20m' 控制单文件大小,maxFiles: '14d' 控制保留周期。对于大多数中小型服务,这已经能覆盖日常追踪和回溯需求。
第三方日志服务适合什么场景
如果你需要跨机器集中看日志,或者希望在严重异常出现时自动告警,就可以把日志继续接到第三方平台。文中提到的方案是 Sentry、Loggly 等服务,其中 Sentry 更适合异常收集和堆栈分析。
示例代码如下:
const Sentry = require('@sentry/node');
Sentry.init({ dsn: 'your-sentry-dsn' });
app.use(Sentry.Handlers.errorHandler()); // Express错误处理中间件

// 记录错误到Sentry
logger.error('严重错误:', { error: new Error('Something went wrong') });
Sentry.captureException(new Error('Something went wrong')); // 发送到Sentry
这类服务的作用不是替代本地日志,而是补上“远程聚合、异常告警、按堆栈归类”的能力。对于多实例部署或线上问题偶发、难复现的服务,价值会更明显。
四类常见错误,按现象直接排查
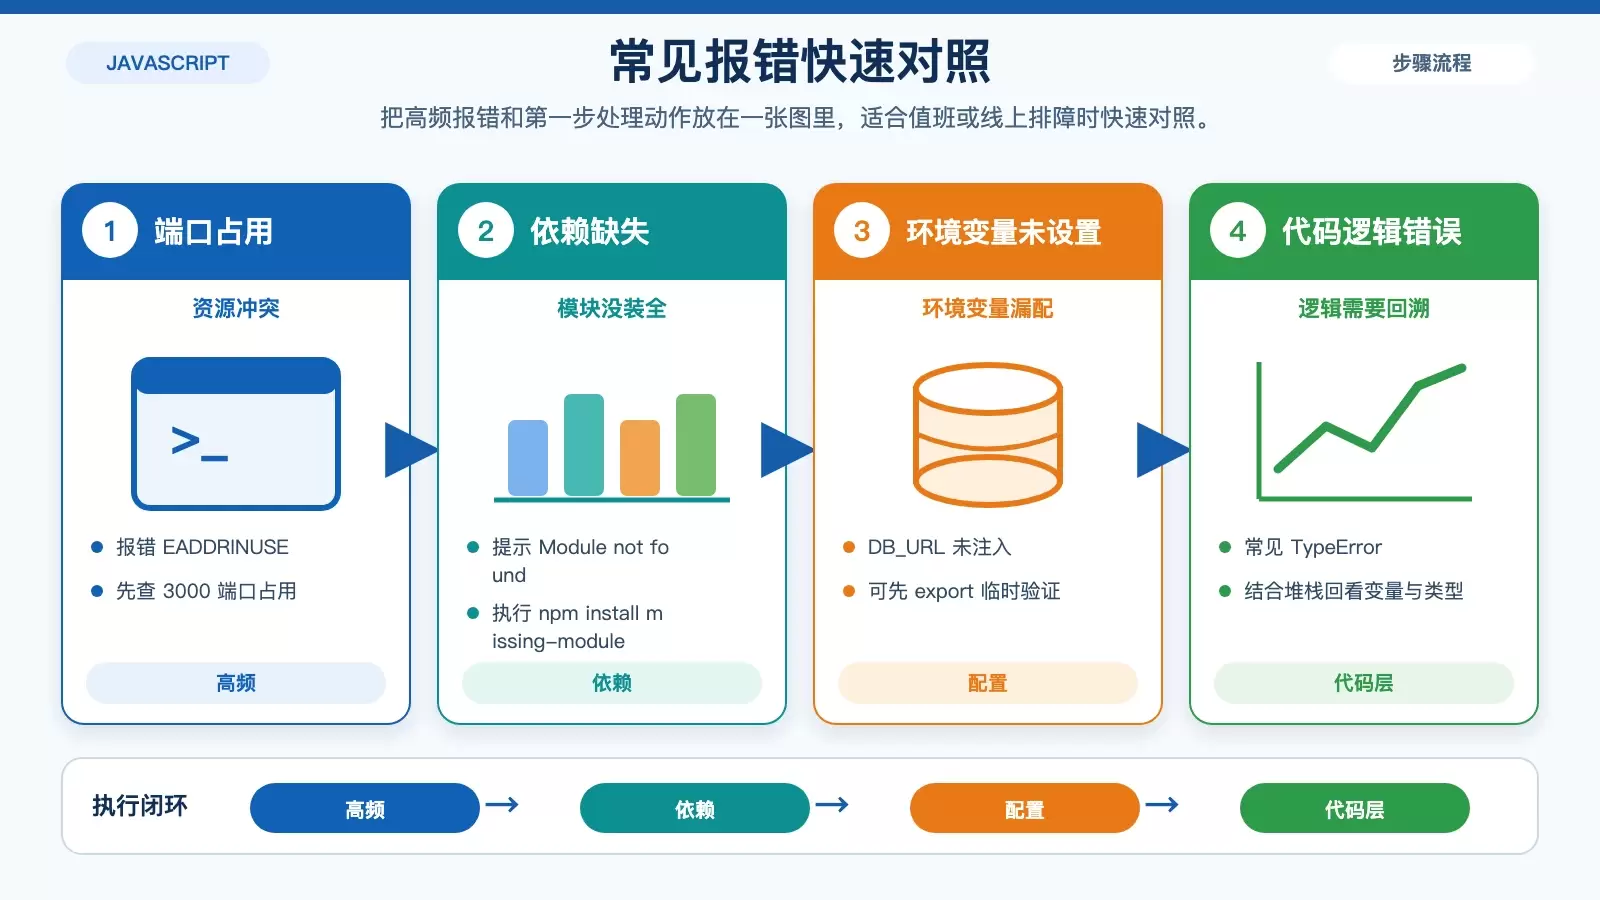
1. 端口占用:EADDRINUSE
如果服务启动时报出 “EADDRINUSE”,通常表示端口已经被其他进程占用。先找出占用者,再决定是结束旧进程,还是调整服务端口:
sudo lsof -i :3000确认对应进程后,可使用:
kill -9 <PID>这类问题本质上不是代码逻辑错误,而是运行环境中的资源冲突。
2. 依赖缺失:Module not found
如果日志里出现 “Module not found”,优先检查依赖是否真的安装、部署时是否漏掉了某个模块。最直接的处理方式就是安装缺失依赖:
npm install missing-module如果问题反复出现,还应继续检查部署流程、锁文件和运行目录是否一致。
3. 环境变量缺失:process.env.DB_URL is undefined
当错误提示类似 “process.env.DB_URL is undefined”,说明应用依赖的环境变量没有注入成功。可以先手工设置确认行为是否恢复:
export DB_URL=your_url如果手工设置后恢复正常,就要继续回头检查 systemd、PM2 或部署脚本中的环境变量配置是否完整。
4. 代码逻辑错误:TypeError / ReferenceError
看到 “TypeError” 或 “ReferenceError”,排查重点通常就回到了代码本身。此时要结合错误堆栈、请求上下文和业务日志,检查变量定义、类型使用和异步逻辑是否符合预期。
这类错误最怕日志信息不完整,因此前面提到的全局异常捕获、中间件记录和结构化输出,都会在这里直接体现价值。
排查 Node.js 日志,核心是分层定位
在 Ubuntu 上追踪 Node.js 错误,最有效的方式不是盲目翻日志,而是按层级推进:先看系统和服务状态,再看应用输出,最后回到代码里的异常捕获和上下文记录。只要这三层信息能接起来,多数线上报错都能更快收敛到具体原因。
如果你的应用已经进入生产环境,至少应补齐三件事:用 PM2 或 systemd 稳定管理进程,用 Winston 记录结构化错误日志,再配合日志轮转或第三方平台保留分析能力。这样不仅能找到错误,也能在下一次故障出现时少走很多弯路。









