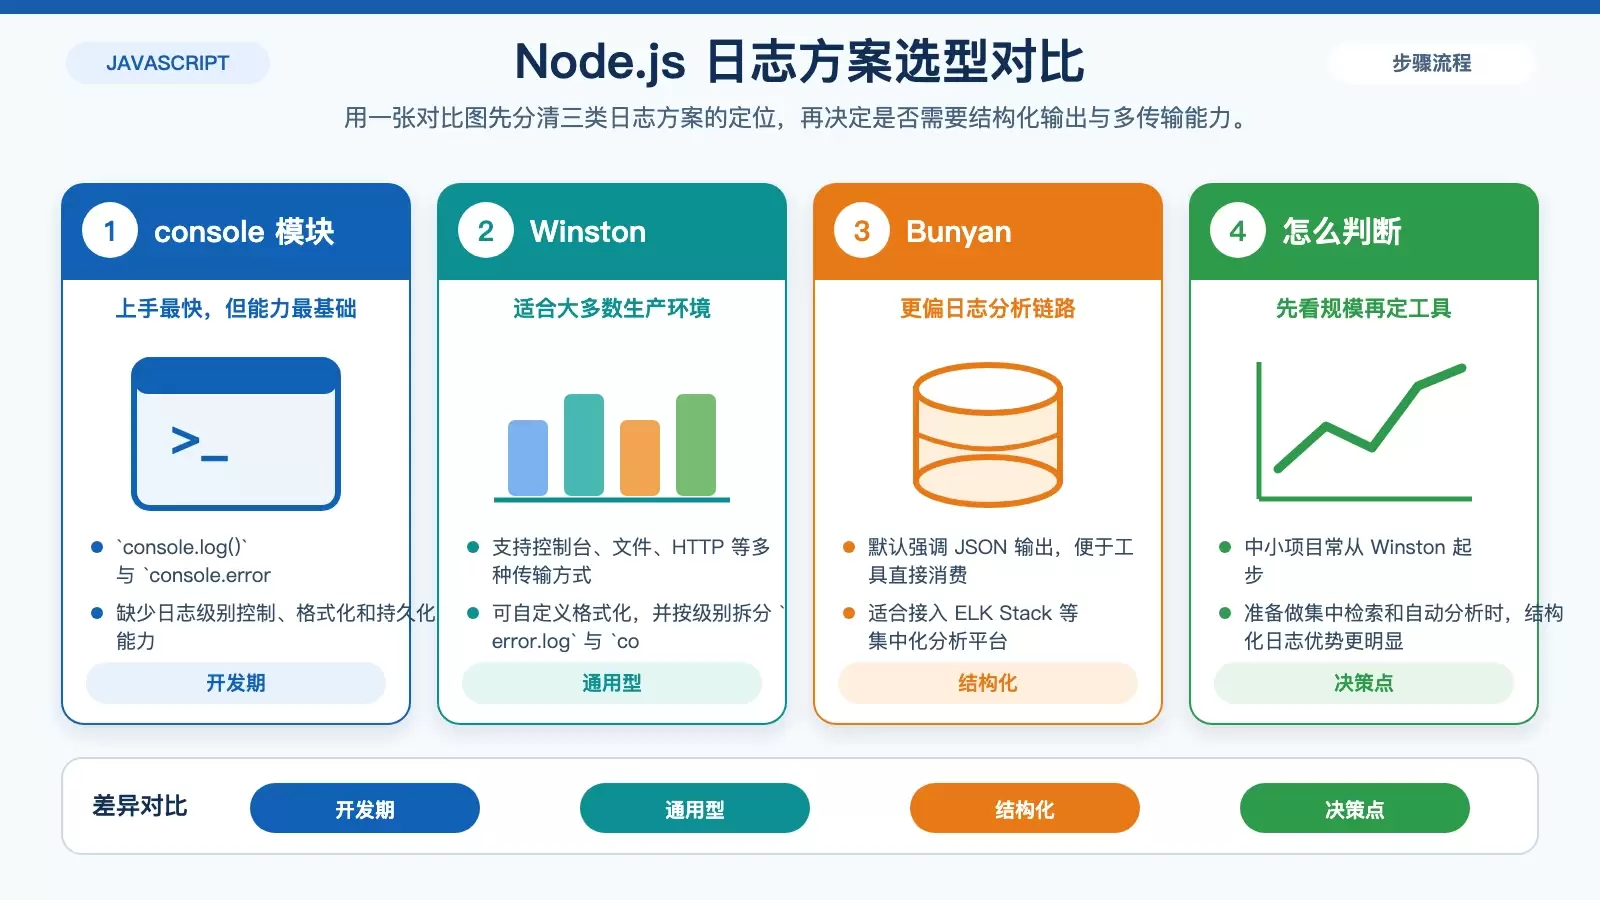
Ubuntu 上配置 Node.js 日志管理:从基础输出到生产级方案
这篇文章按 Ubuntu 上 Node.js 日志管理的实际落地顺序,梳理了从 `console`、Winston 与 Bunyan,到日志轮转、PM2 以及 ELK 集中化方案的配置思路。重点不是工具越多越好,而是根据部署规模判断何时需要结构化日志、何时必须做轮转与统一检索。
2026-08-24
142

这篇文章按 Ubuntu 上 Node.js 日志管理的实际落地顺序,梳理了从 `console`、Winston 与 Bunyan,到日志轮转、PM2 以及 ELK 集中化方案的配置思路。重点不是工具越多越好,而是根据部署规模判断何时需要结构化日志、何时必须做轮转与统一检索。
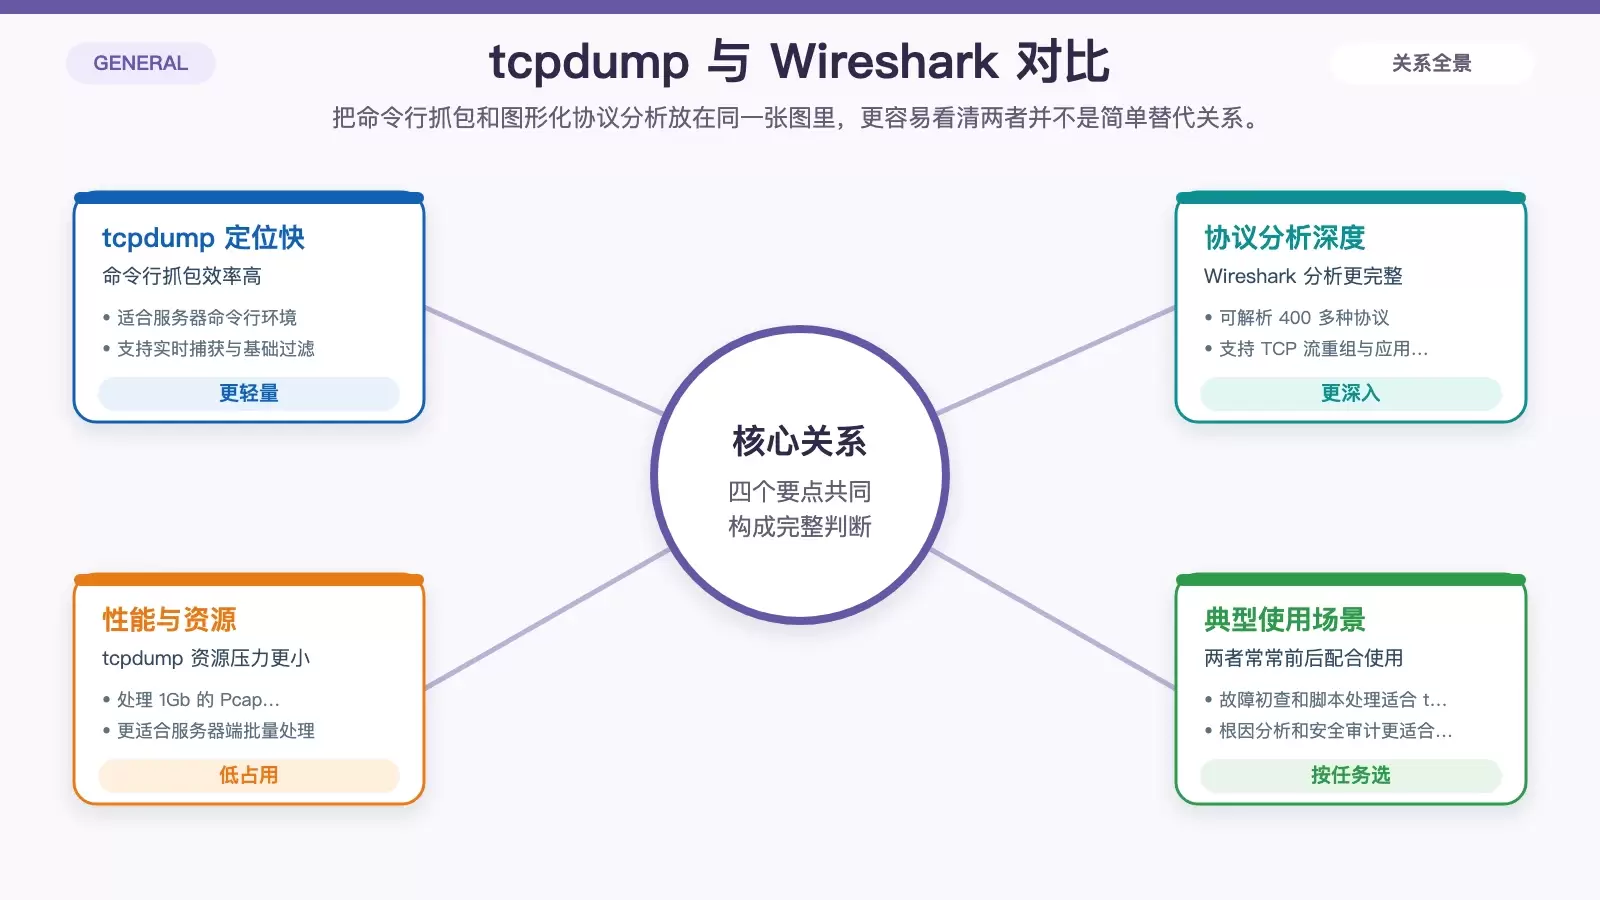
tcpdump 仍是 CentOS 服务器上最常用的抓包工具,但它并不适合所有场景。本文把 tcpdump 与 Wireshark、iftop、nethogs、nload 放在同一张表里比较,重点看功能深度、资源占用和适用场景,帮助你按问题类型选工具。 在 CentOS 服务器上,tcpdump 往往是排查网络问题时最先想到的工具,但“能抓包”并不等于“适合所有问题”。
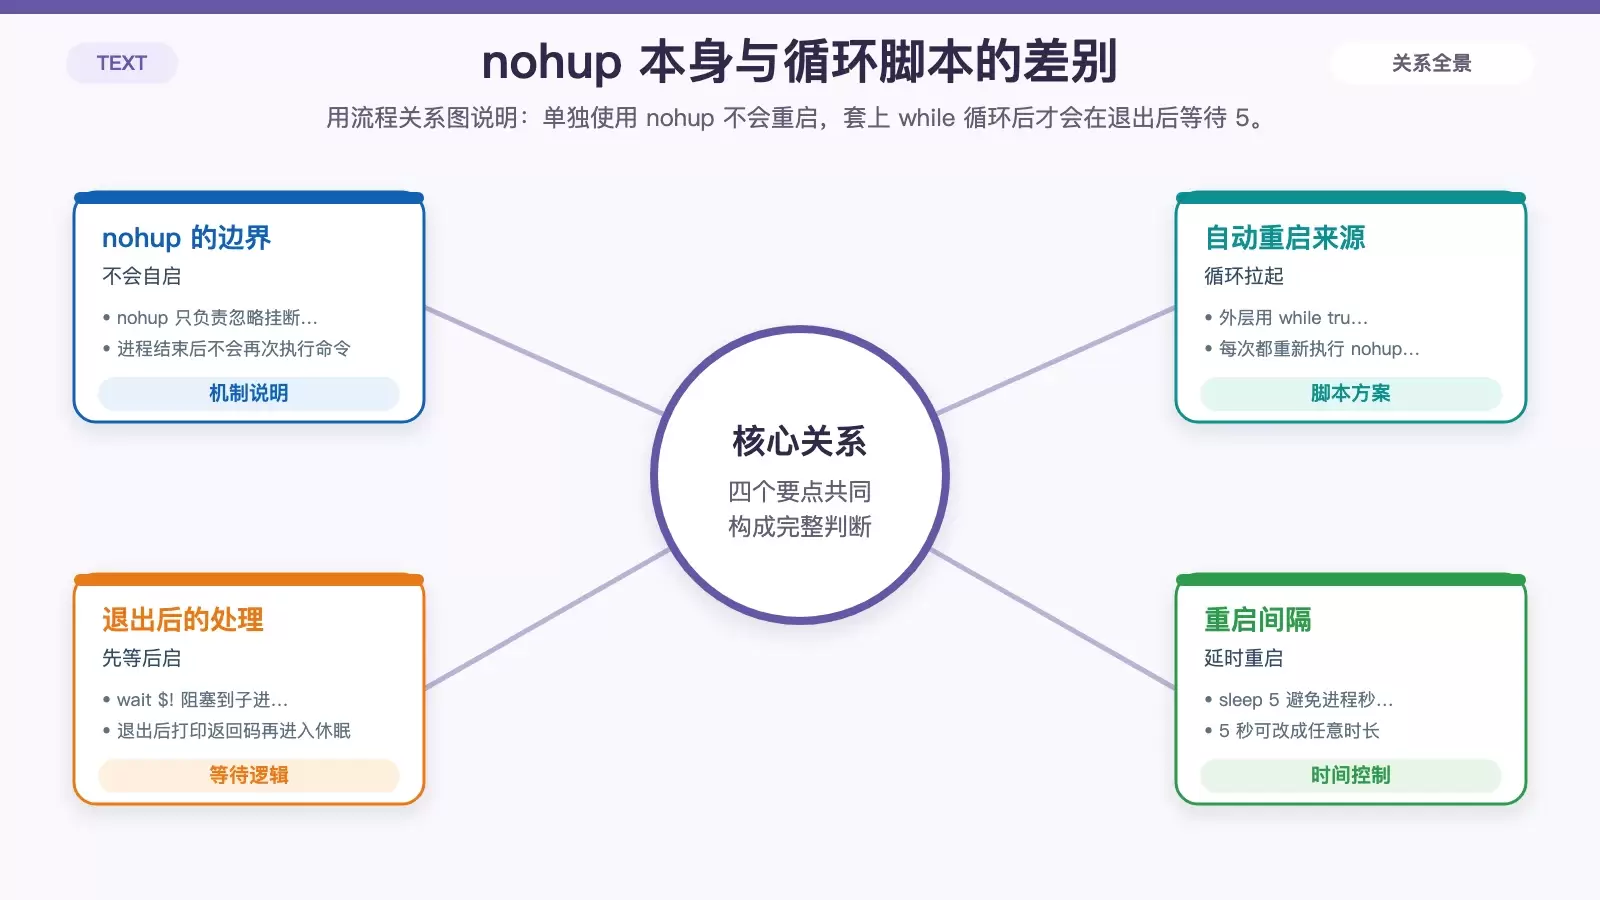
`nohup` 只能让进程在退出终端后继续运行,并不负责拉起已崩溃的程序。本文把常见的 4 种补救方案拆开讲清:循环脚本、`systemd`、`supervisord` 和 `cron`,并说明各自适合的部署环境与取舍。 很多人会把 nohup 当成“后台常驻”的通用解法,但它只能保证退出终端后进程继续跑,不能在进程崩溃后自动拉起。
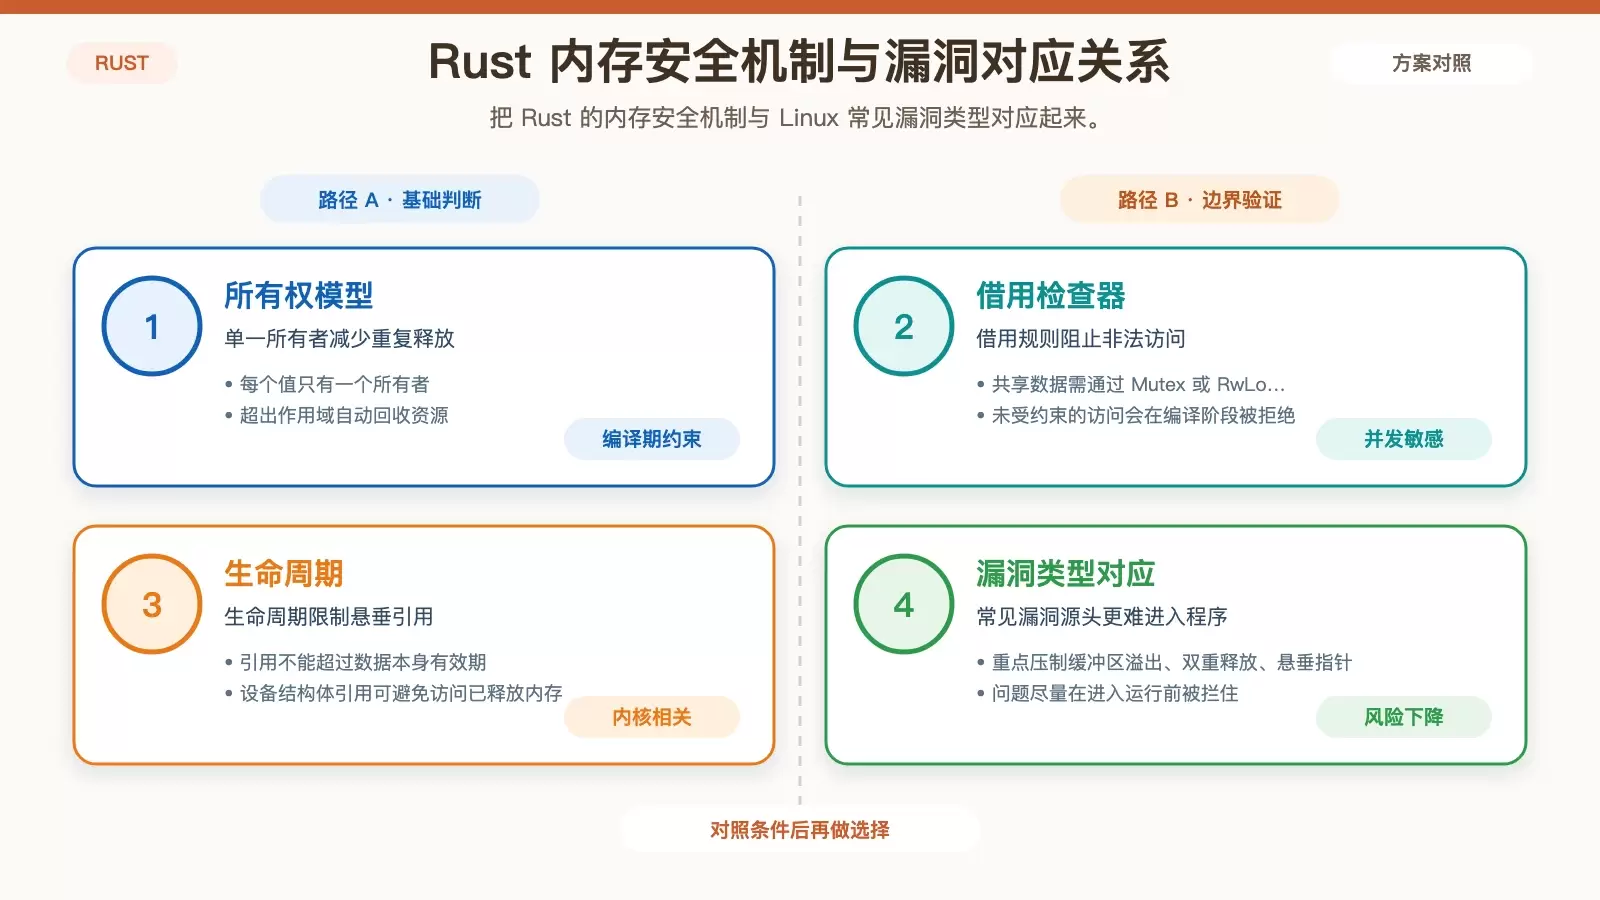
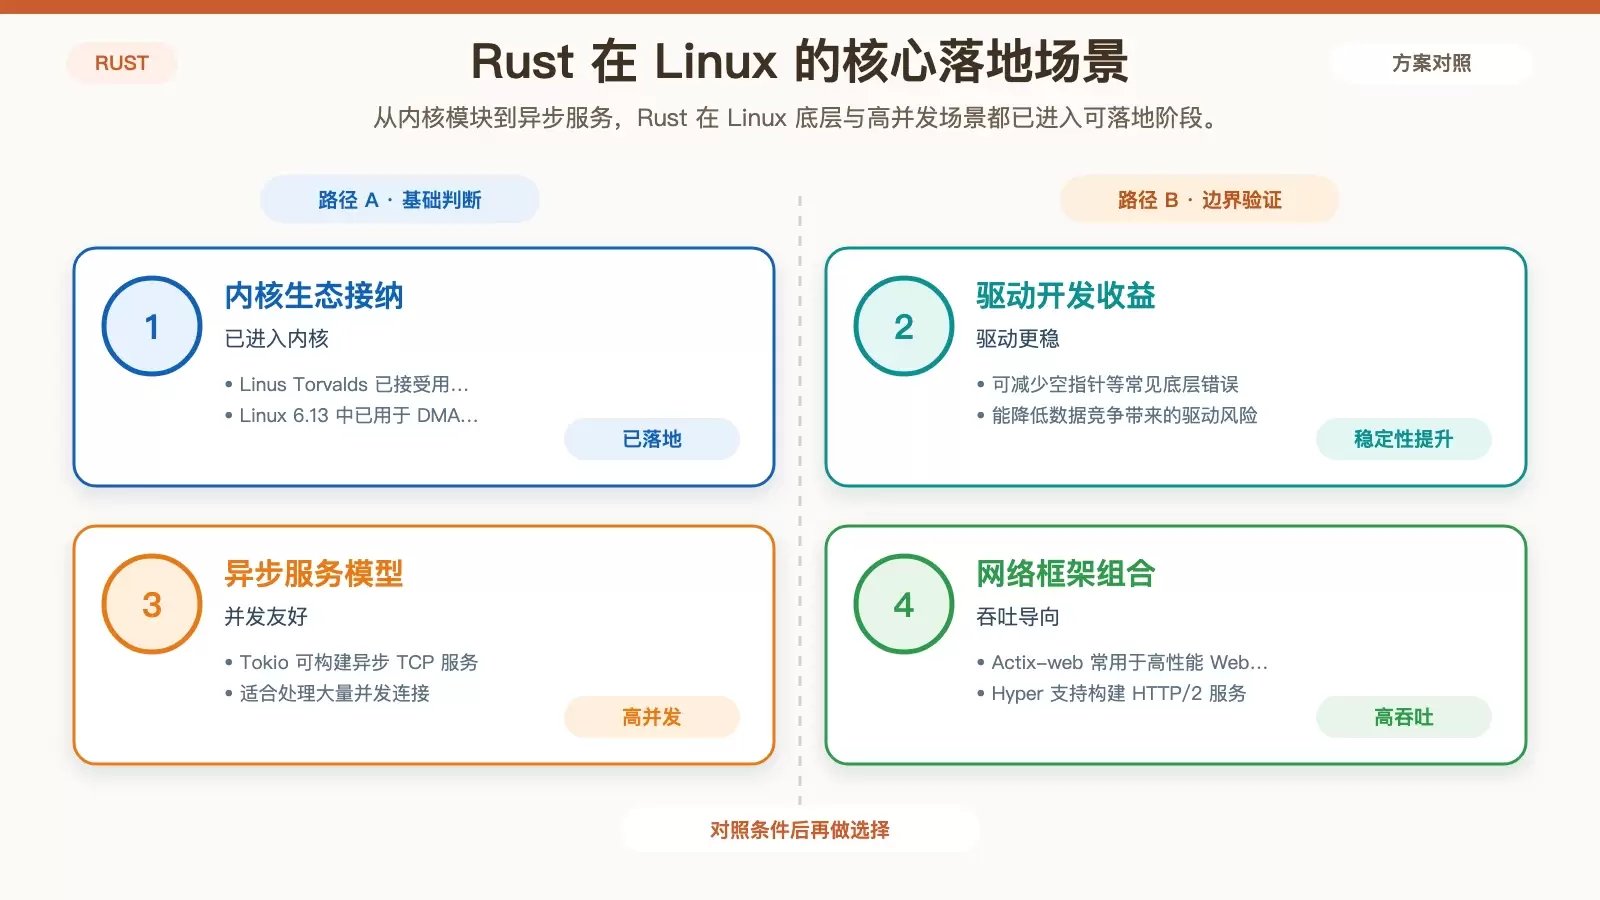
Rust 在 Linux 生态中的价值,已经从语言优势走向实际落地:内核驱动、服务器、系统工具、嵌入式、安全服务到跨平台部署,都出现了明确案例。本文按场景拆解 Rust 为何适合这些任务,以及它真正带来的工程收益。
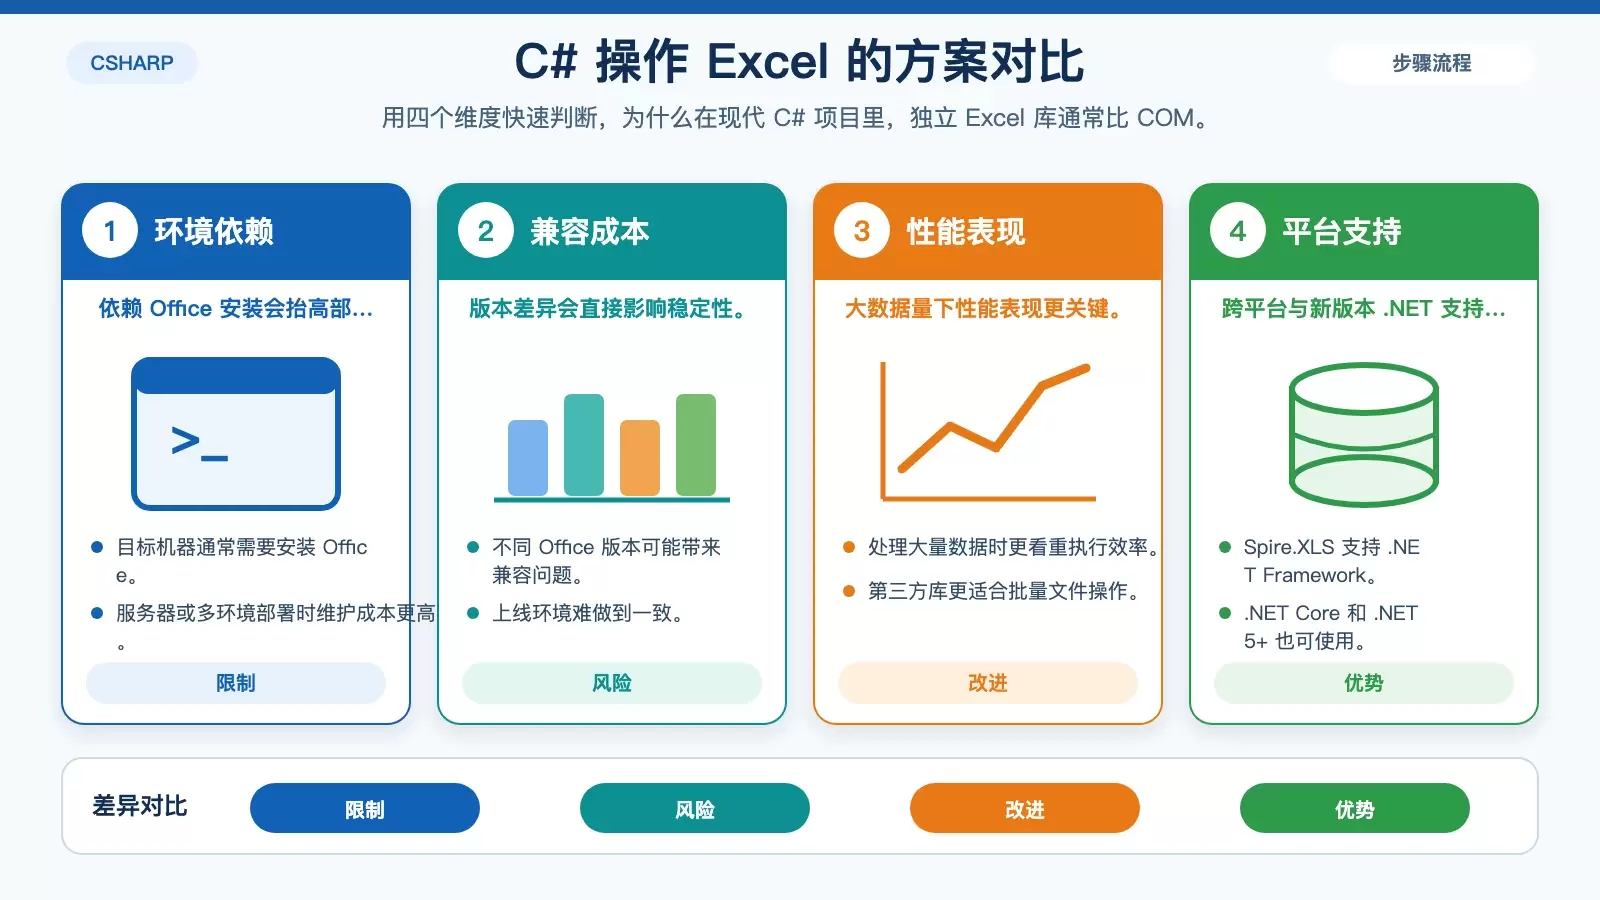
这篇文章围绕 C# 中常见的 Excel 增删改查需求,整理了使用 Spire.XLS for .NET 的实际做法。相比依赖 Office 的 COM Interop,它在部署、性能和跨平台支持上更省事,适合做导入导出、报表生成和批量数据处理。 在 C# 项目里处理 Excel,看似只是文件读写,实际往往牵扯部署环境、性能表现和后续维护成本。
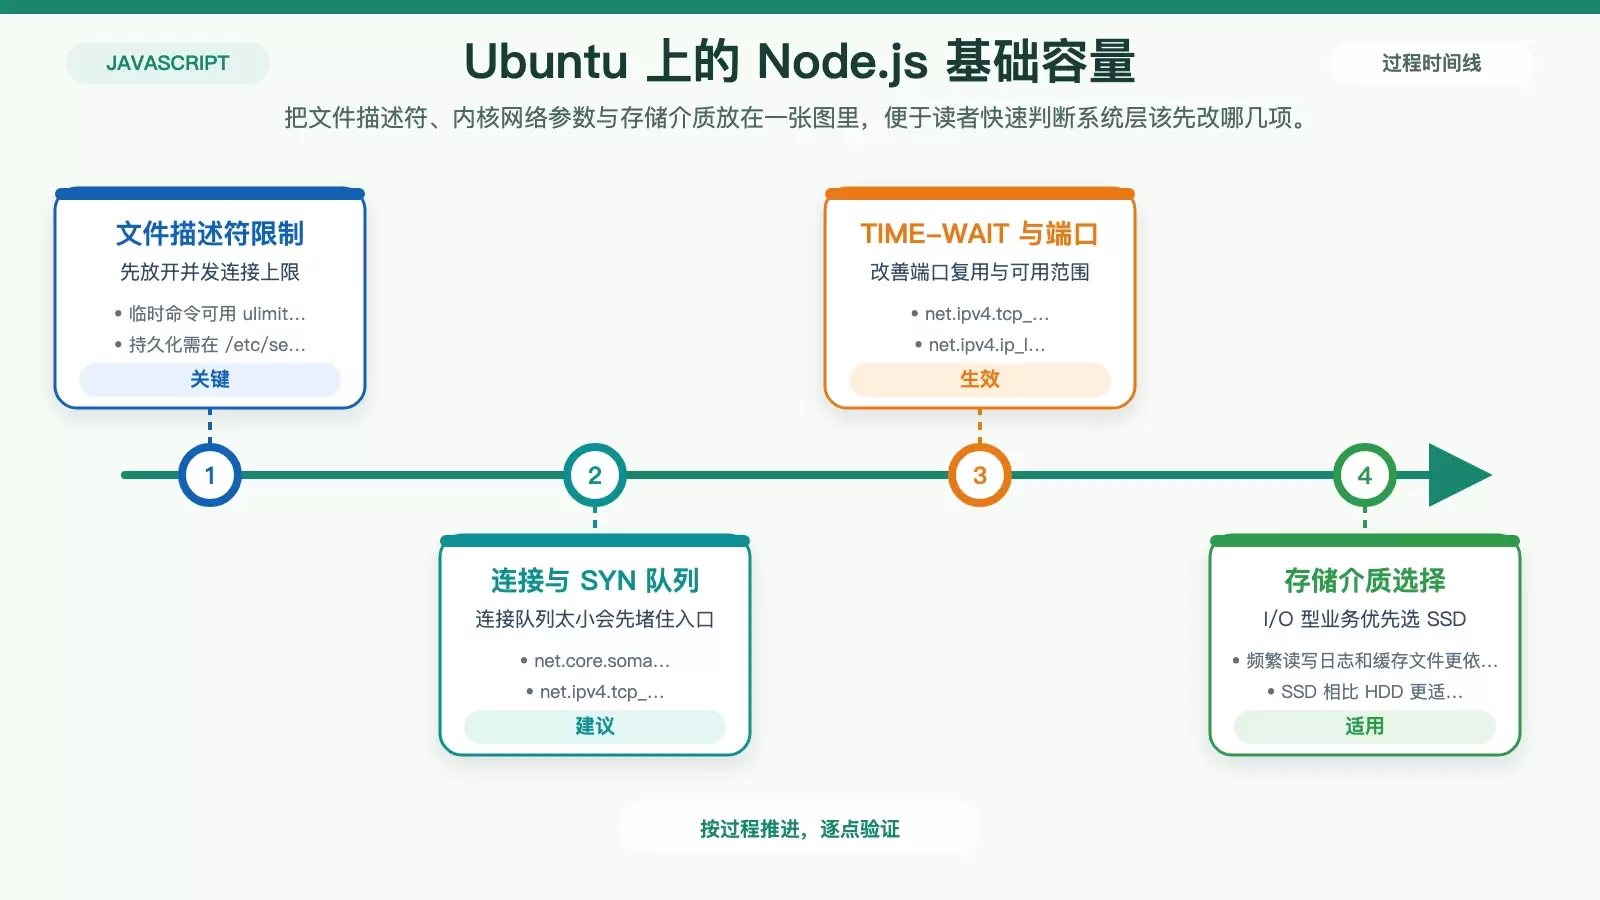
Ubuntu 上优化 Node.js 项目,不能只盯着代码层。系统参数、并发模型、缓存与数据库访问方式,都会直接决定应用在高并发下是否稳定、是否还能继续提速。 Node.js 项目部署到 Ubuntu 后,性能瓶颈往往不会只出在一层:系统参数、事件循环、数据库访问和多核利用方式,任何一个环节都可能把吞吐拖下来。
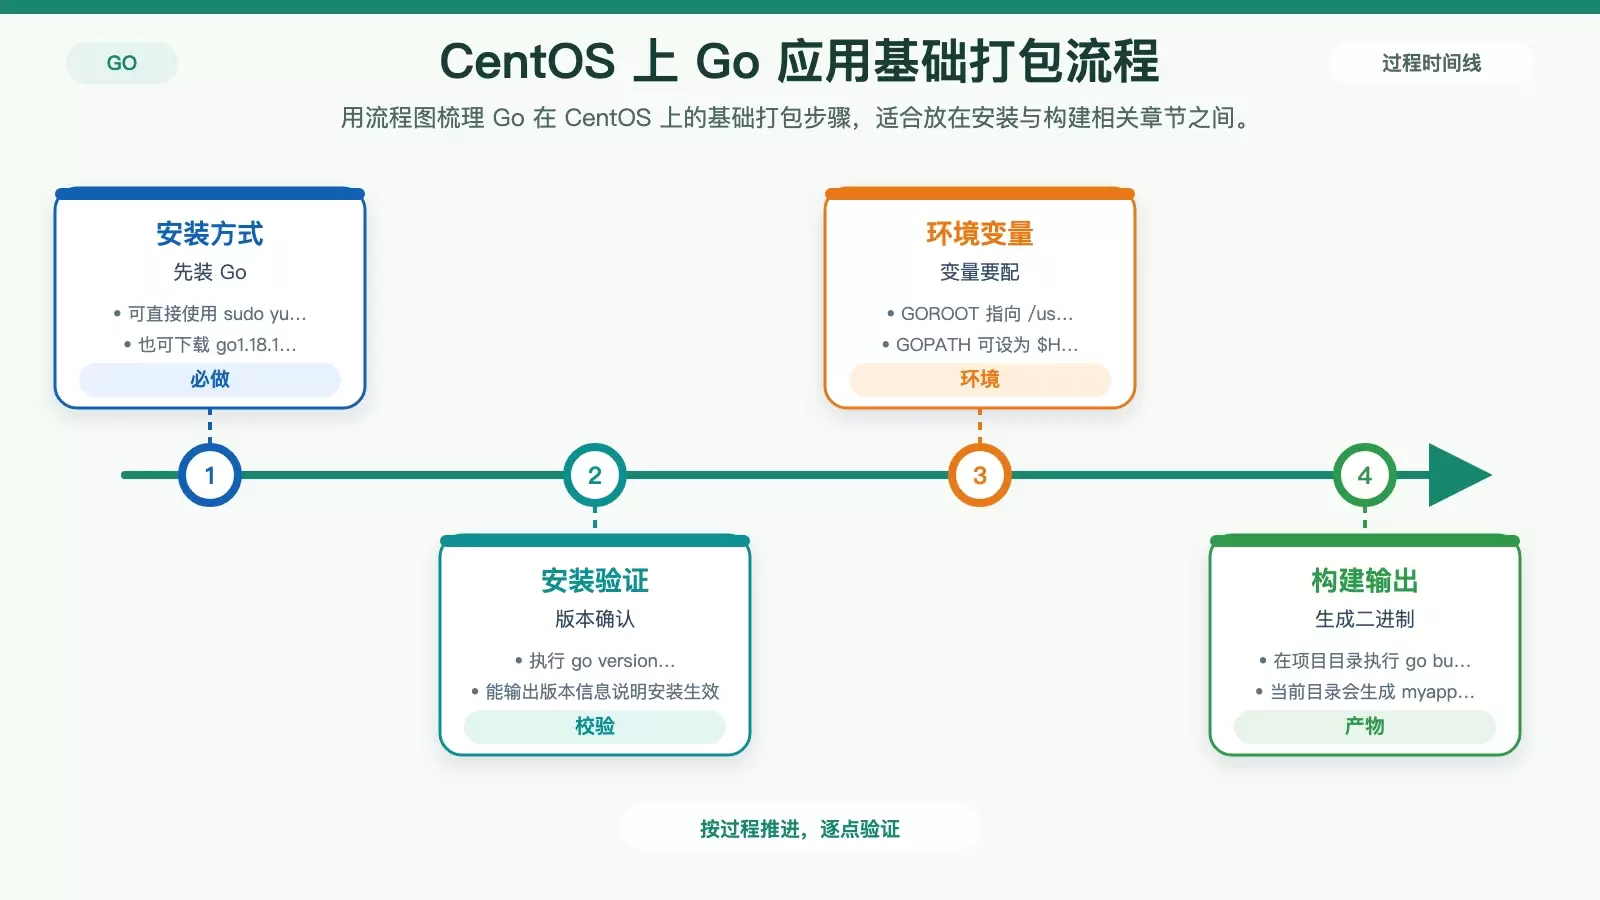
这篇文章把在 CentOS 上打包 Go 应用的流程拆成安装、环境变量、构建、压缩和服务化几个环节,并补充了 CentOS 7/8 下可直接使用的命令。对于需要跨环境部署的场景,文中也给出静态编译和容器化的判断建议。
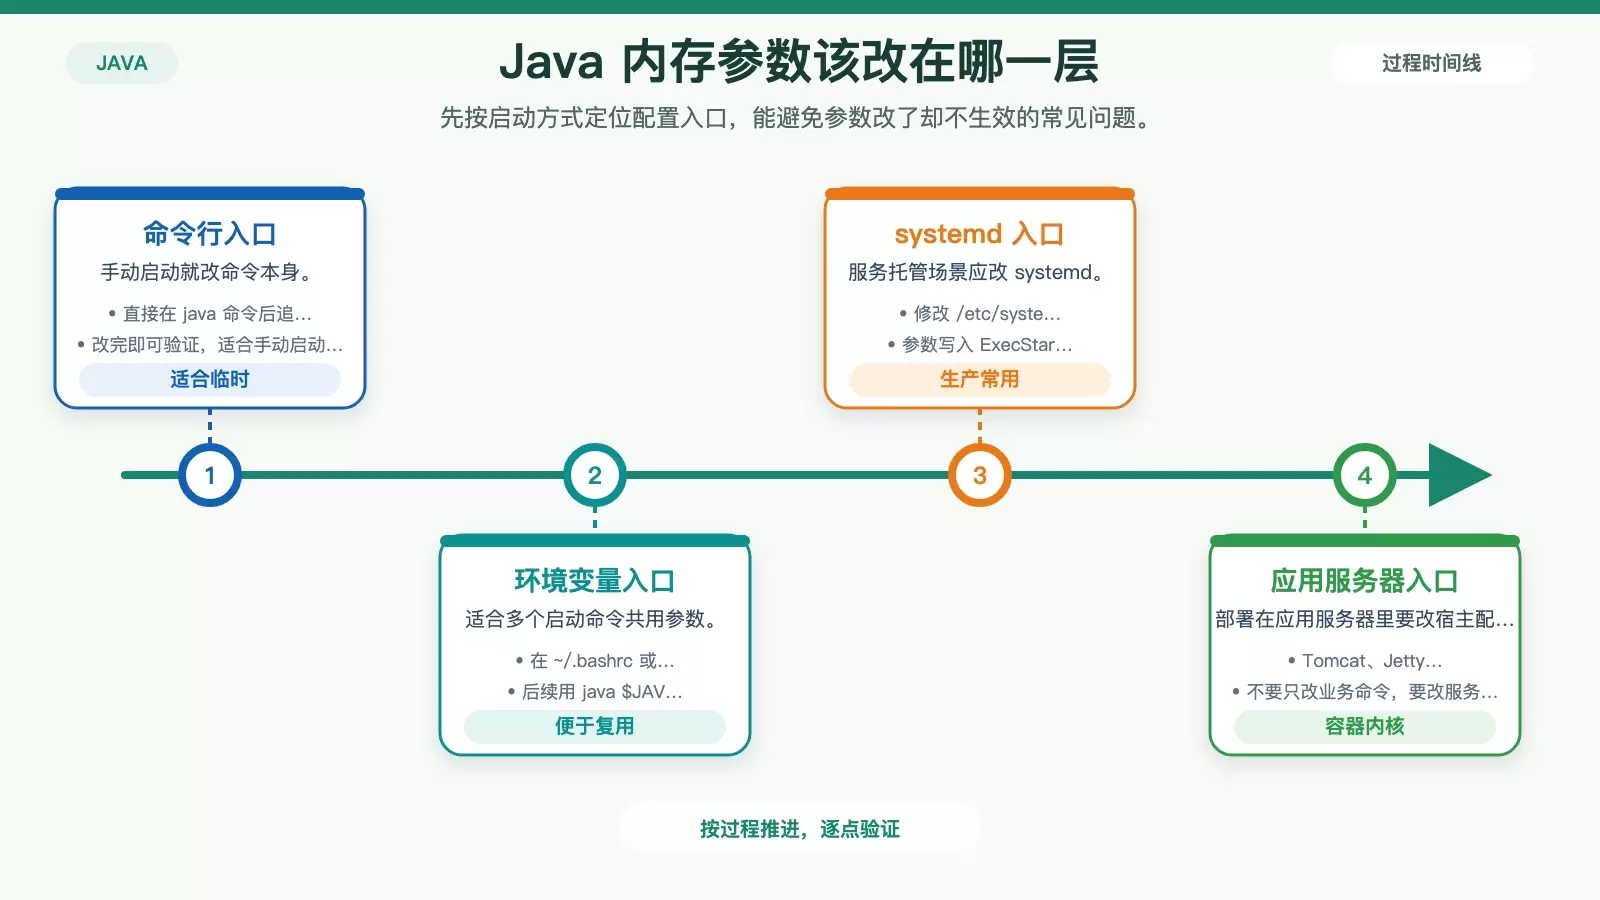
在 Debian 上给 Java 应用调内存,关键是把 `-Xms` 和 `-Xmx` 放到正确的启动入口。本文按命令行、环境变量、systemd 服务和 Tomcat/Jetty 等应用服务器四种场景拆开讲,方便你根据部署方式快速落地,并在调整后用监控工具验证参数是否合适。
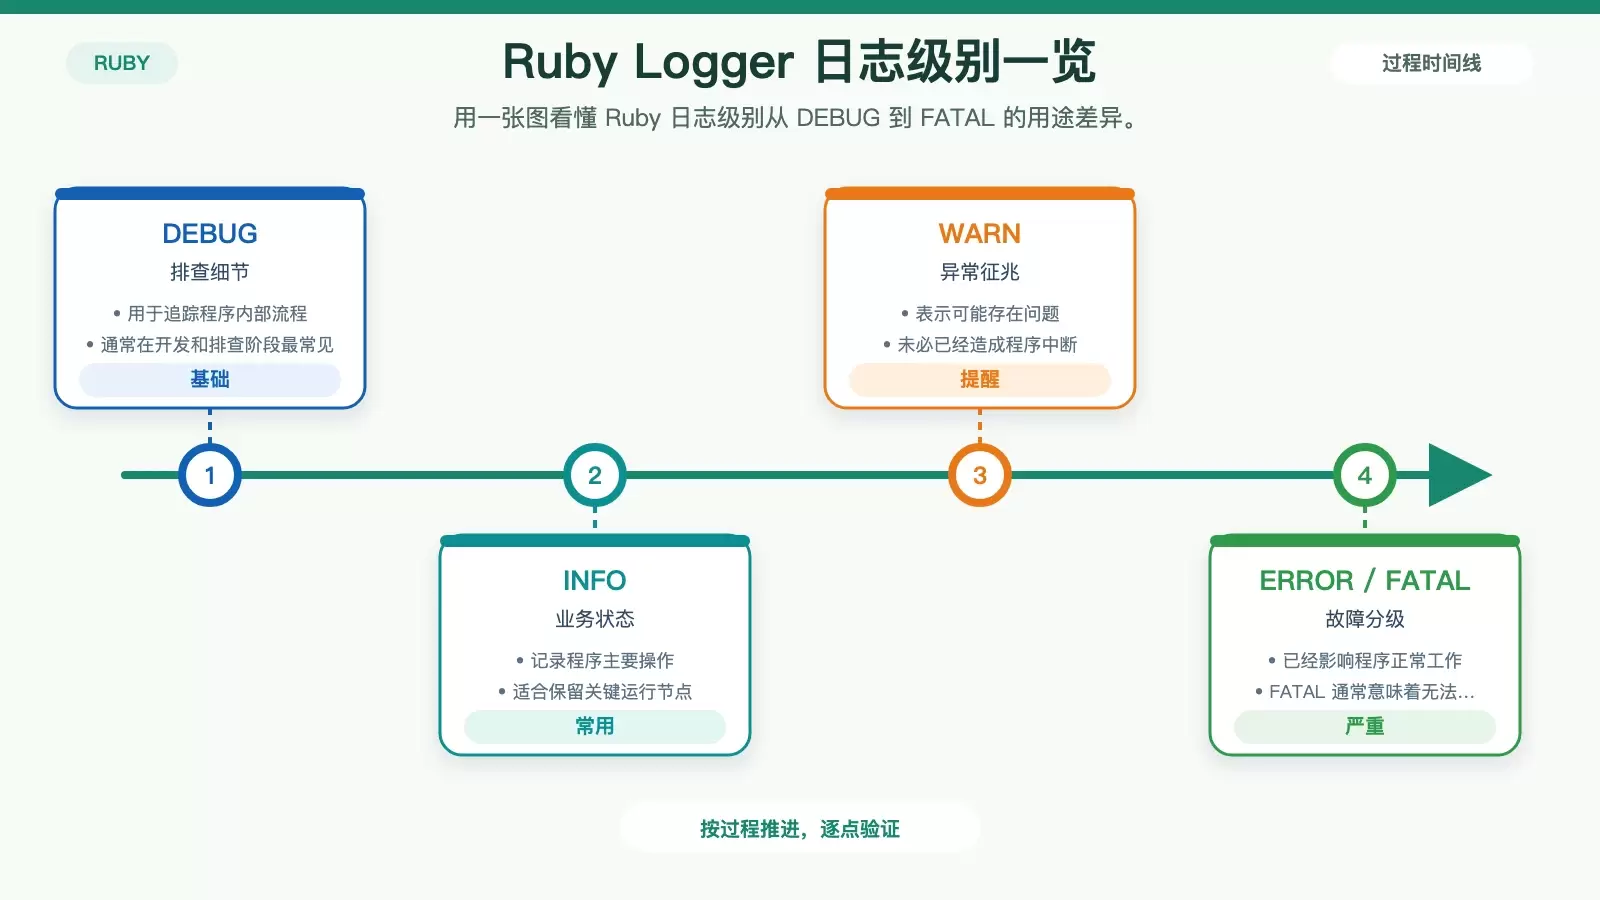
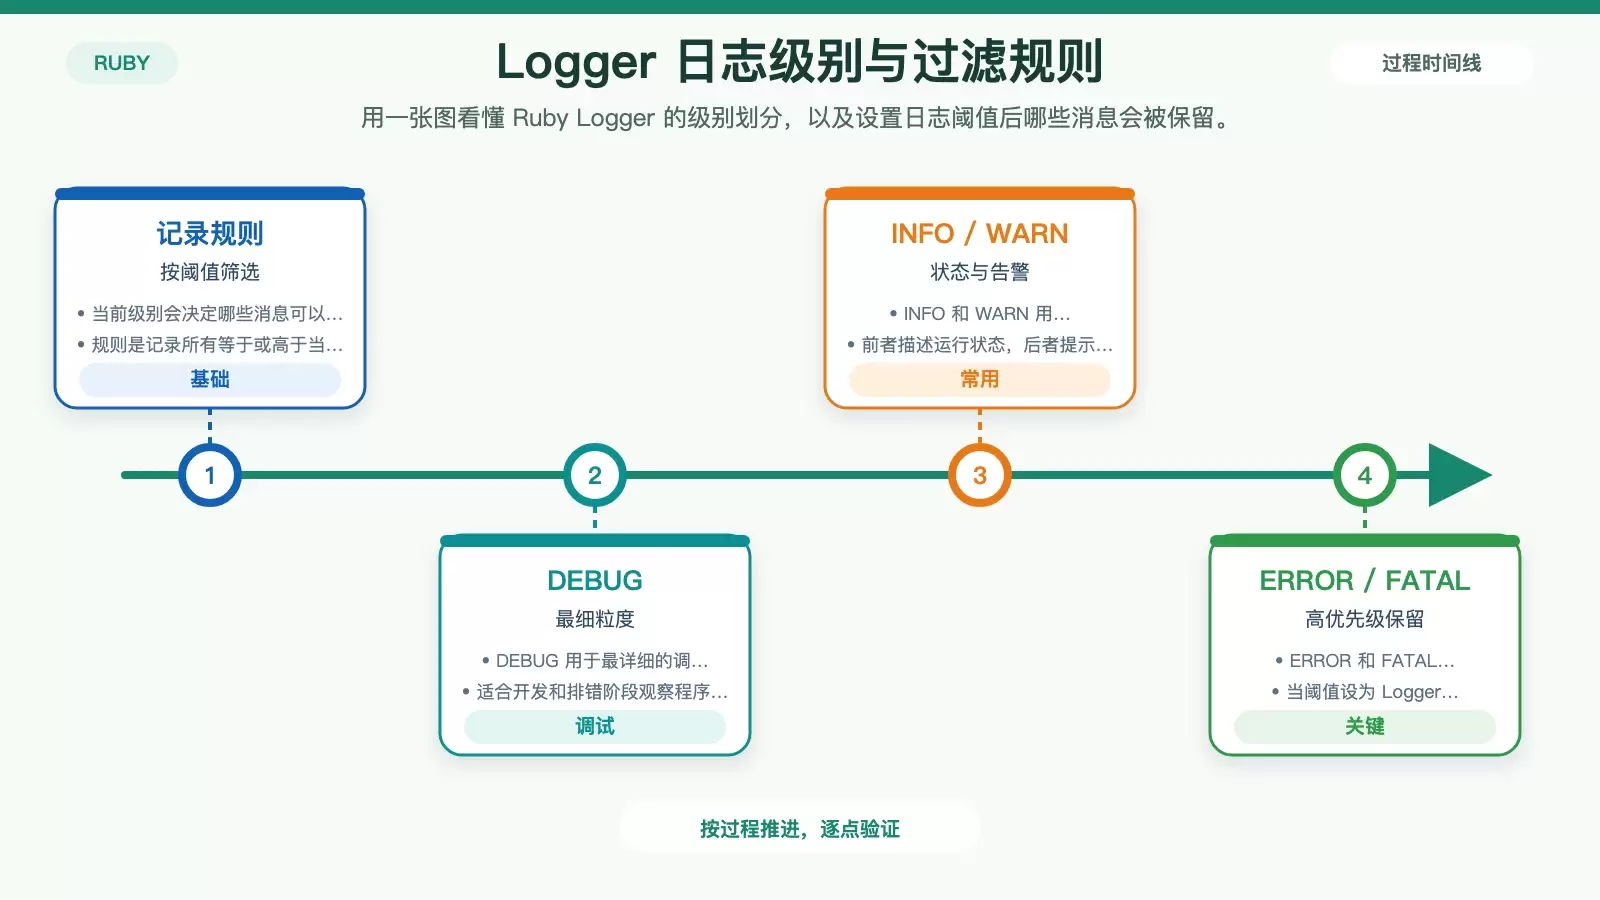
这篇文章围绕 Ruby 自带的 Logger 展开,梳理了日志级别、基础用法、自定义格式、多个输出目标和生产环境中的轮转思路。对于刚接触后端日志的 Ruby 开发者,可以据此快速判断何时记、记什么,以及怎样把日志写得更可维护。
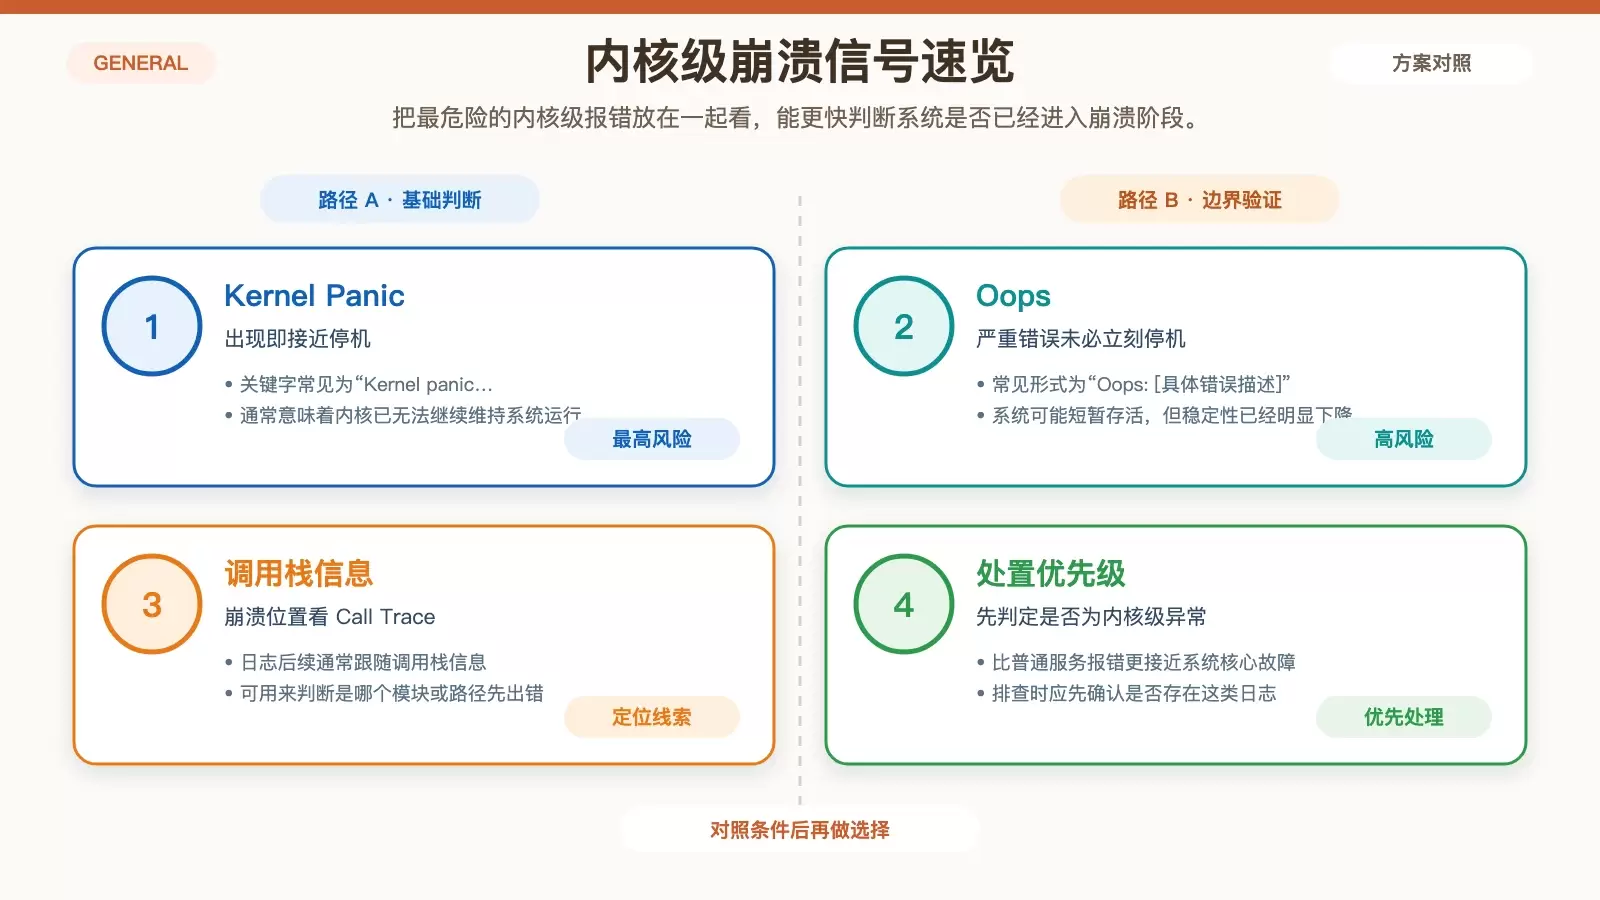
系统并不总是突然崩溃,很多时候内核早已通过 dmesg 发出警告。本文按故障类型梳理常见预兆,结合典型日志关键字,帮助你判断问题更可能出在内核、硬件、驱动、内存还是文件系统。
Ruby 标准库自带 Logger,足以覆盖多数脚本和应用的日志需求。本文从日志级别、实例创建、消息记录到格式定制、滚动策略与多目标输出,梳理 Logger 的常见用法,并指出示例里哪些写法更适合直接上手。
Rust 在 Linux 上的价值,不只是性能更高,更关键的是它把内存安全、并发安全和错误处理前移到编译阶段。本文按内存、并发、类型系统、内核模块与运维实践几个层面拆解 Rust 如何借助 Linux 安全机制降低漏洞与运维风险。