


日志记录在前端场景里不算显眼,但在后端服务、脚本任务和运维排障中,它往往就是定位问题的第一入口。Ruby 已经内置了 Logger,入门门槛不高,但真正写得有用,关键在于理解日志级别、输出方式和生产环境下的控制策略。下面按“先能用、再好用”的顺序梳理 Ruby 日志记录的核心做法,并说明哪些地方适合直接上手,哪些地方需要额外留意。
Ruby 为什么要用日志
对 Ruby 应用来说,日志最直接的作用有三类:记录运行过程、保留错误现场、帮助后续排查。尤其是在服务端程序里,很多问题无法只靠报错提示复现,这时日志就是判断程序做过什么、在哪一步出错的主要依据。
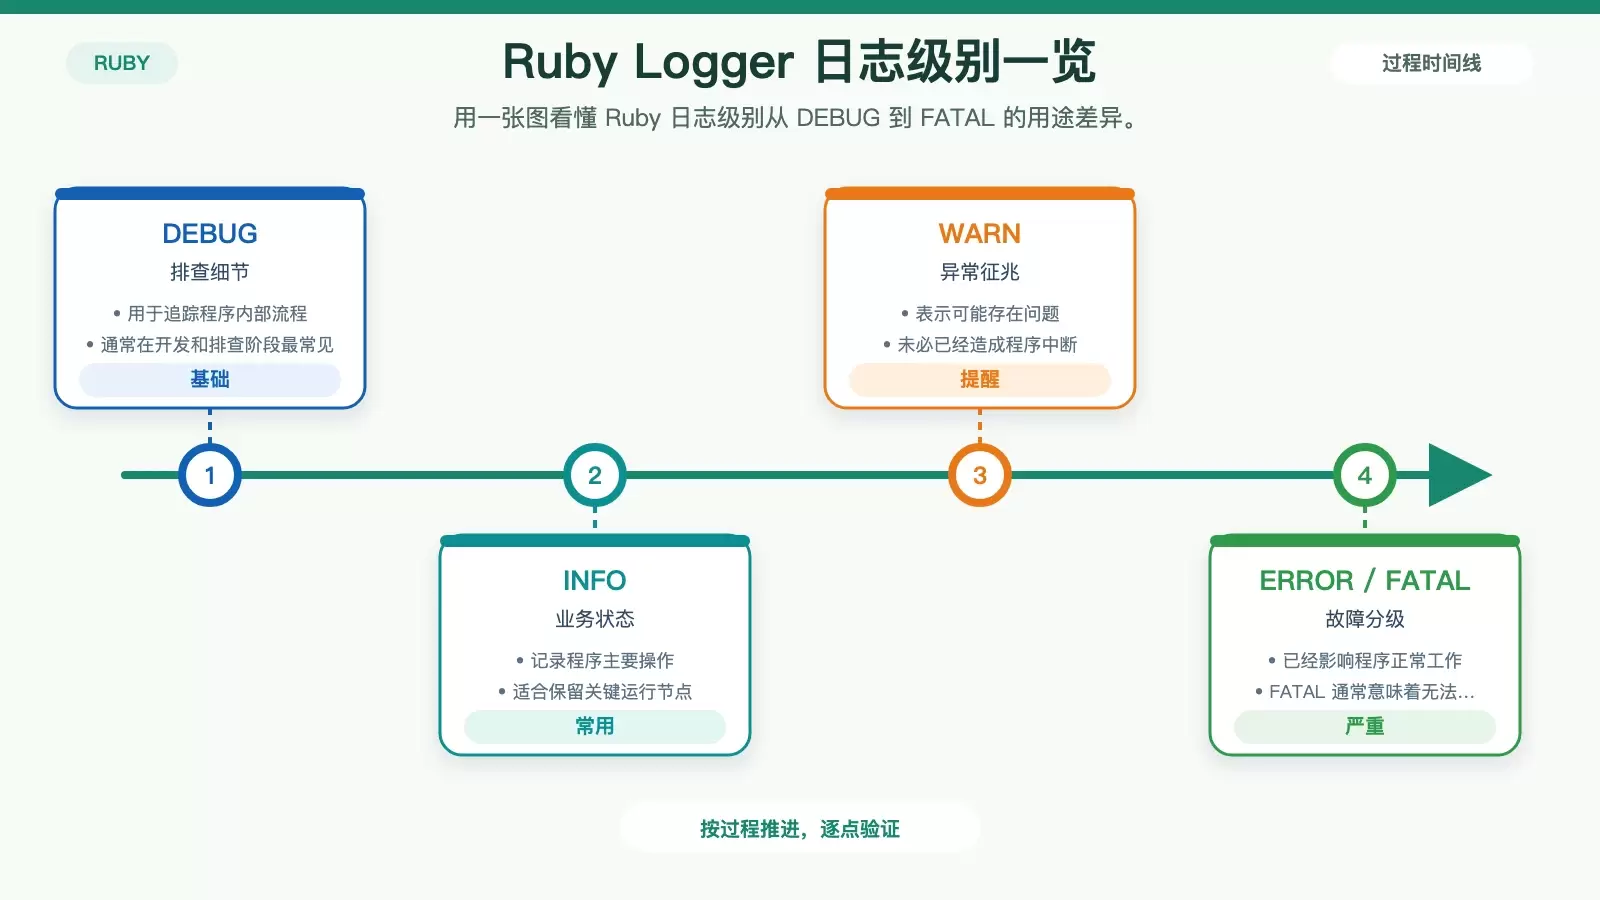
Ruby 标准库自带 Logger,不需要额外安装就可以使用。它支持按级别输出日志,你可以通过不同级别控制信息密度和用途。
常见日志级别怎么区分
- DEBUG:调试信息,用于追踪程序内部的工作流程。
- INFO:一般信息,记录程序的主要操作。
- WARN:警告信息,表示可能存在问题的情况。
- ERROR:错误信息,表示已经影响到程序正常工作的错误。
- FATAL:致命错误,通常意味着程序无法继续运行。
实际使用时,可以把它理解为一套筛选机制:级别越高,通常越偏向必须关注的问题;级别越低,越适合开发和排查阶段补充上下文。
Ruby Logger 的基础用法
如果你只是想先把日志打出来,Logger 的基本流程很简单:引入库、创建实例、设置级别、开始记录。
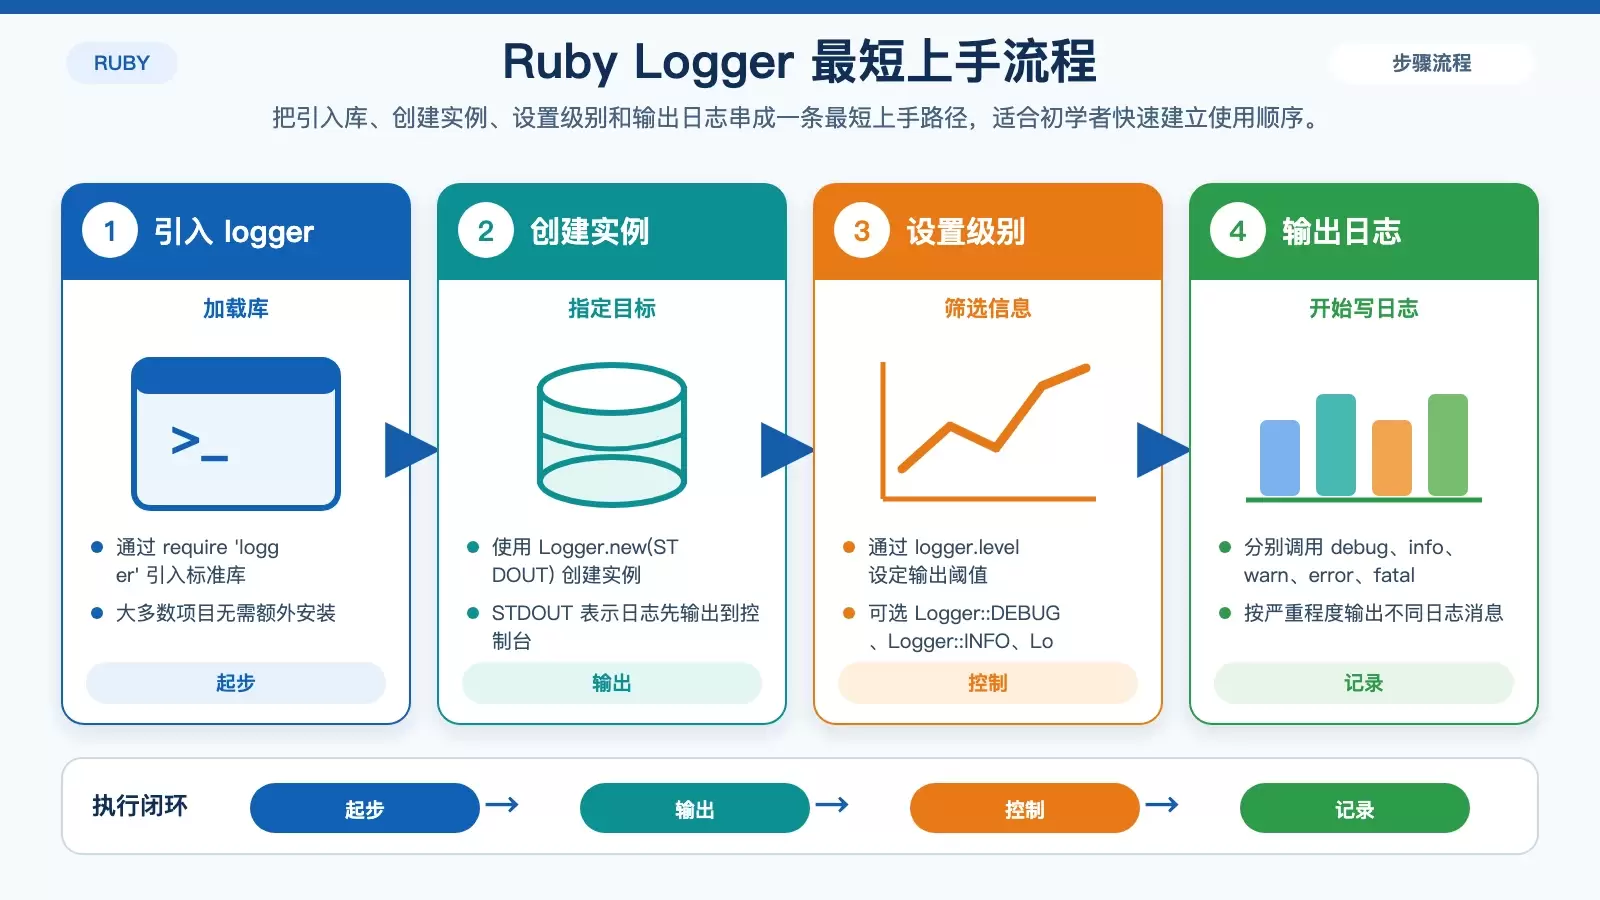
先加载 logger 库
require 'logger'大多数 Ruby 项目里,这一步就够了。
创建 Logger 实例并指定输出位置
logger = Logger.new(STDOUT)这里的 STDOUT 表示标准输出,也就是直接打印到控制台。对于命令行工具、开发环境脚本或临时调试,这是最直接的方式。若要写入文件,也可以把输出目标换成文件路径或文件对象。
设置日志级别
logger.level = Logger::DEBUG # 或者其他级别,如 Logger::INFO, Logger::WARN 等这一步决定了哪些日志会被真正输出。比如设置为 Logger::INFO 后,通常就不会再看到 DEBUG 级别的信息。
按不同级别记录日志
完成实例创建后,就可以直接通过对应方法写日志:
logger.debug("这是调试信息")
logger.info("这是一个信息级别的日志")
logger.warn("这里有一个警告")
logger.error("发生了一个错误")
logger.fatal("致命错误,程序即将退出")
这种写法适合先把程序运行轨迹和错误现场记录下来。后续如果要进一步提升可读性,再考虑格式化和分流输出。
想让日志更好用,可以从这两项开始
Logger 的基础功能足以覆盖不少场景,但如果你开始关注排查效率,通常会先碰到两个问题:默认输出够不够看、日志是否需要同时发往多个目标。
自定义日志格式
默认格式比较简洁,但在多人协作或线上排错时,往往希望把时间、级别和消息组织得更清楚。这时可以自定义格式化器:
formatter = proc do |severity, datetime, progname, msg|
  "#{datetime}: #{severity} #{msg}n"
end

logger.formatter = formatter
这段代码保留了时间戳、日志级别和正文消息。虽然示例很简单,但思路很实用:你可以按团队需要补充更稳定的输出格式,方便后续检索和分析。
同时写到控制台和文件
有些程序既希望在终端即时看到输出,也希望把日志持久化到文件中。原文给出了一个多输出目标示例:
file_log = Logger.new('app.log')
logger.extend(Logger::Severity).add(Logger::Severity::DEBUG, "写入文件的日志")
logger.add(Logger::Severity::DEBUG, "写入控制台的日志")
这里需要特别注意:上述代码更适合作为思路展示,而不是可直接照搬的标准实现。实际项目里,通常需要为每个输出目标分别创建 Logger 实例,或者引入更完整的日志管理方案,否则行为会比较难控制。
日志文件变大后,为什么要考虑轮转
如果日志持续写入文件而不做控制,文件体积会越来越大,最终带来两个问题:占用存储空间,以及影响读写和维护效率。生产环境里,这通常不是“要不要做”的问题,而是“何时接入”的问题。
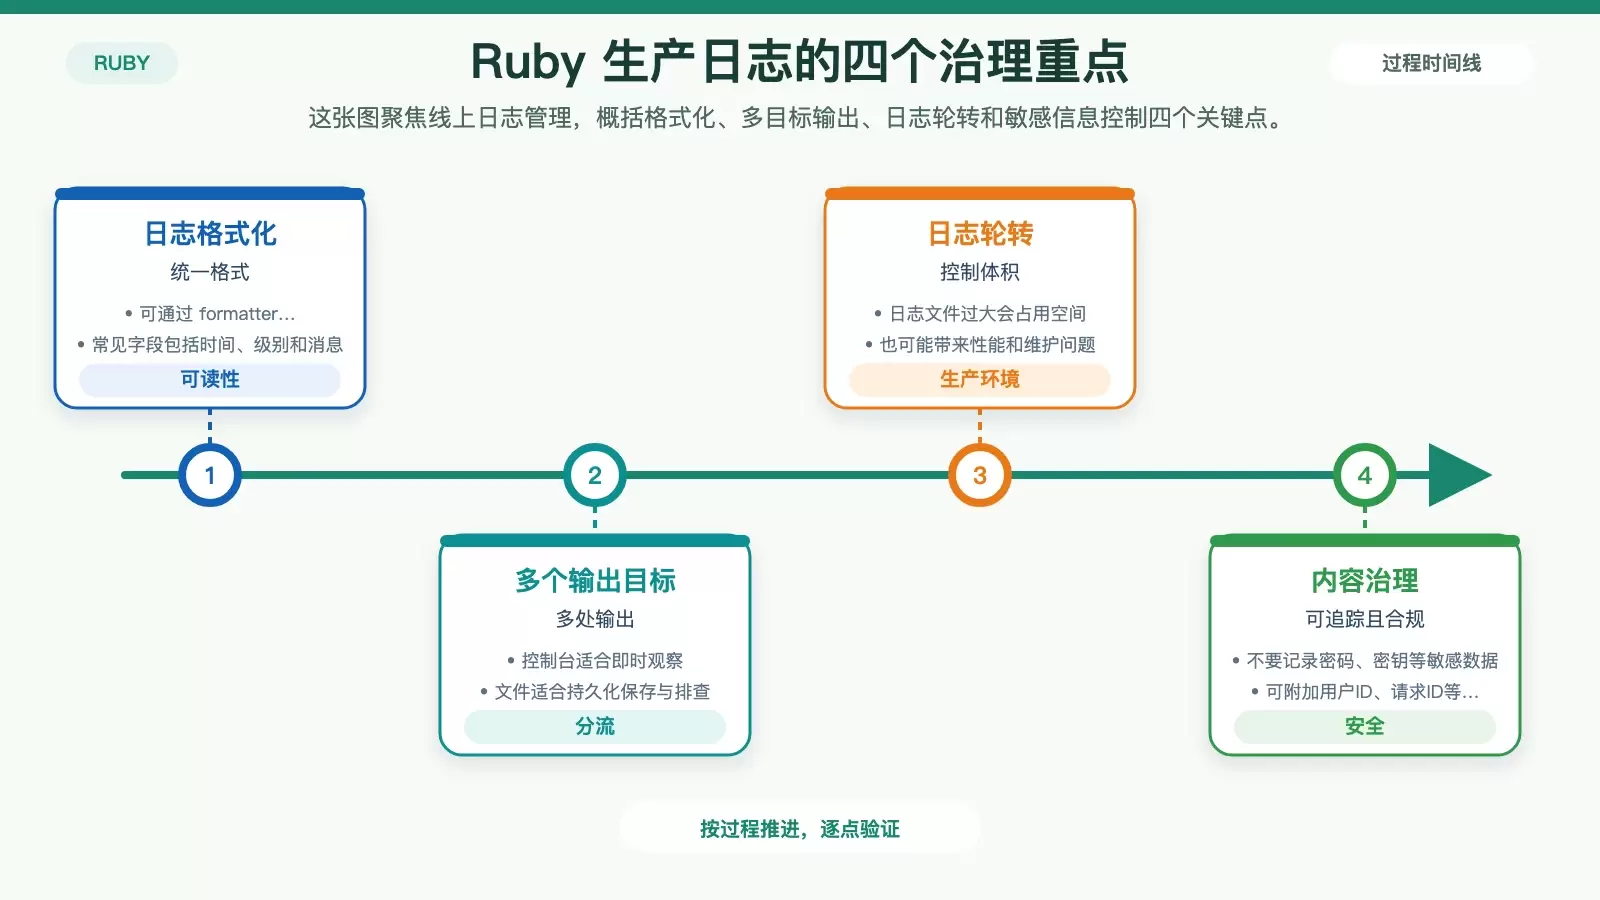
原文指出,Ruby 的 Logger 库本身不直接支持日志轮转,可以借助第三方库实现,例如 log4r。这里没有展开具体配置,但结论很明确:只要你的应用会长期运行并持续产生日志,就应该尽早规划轮转策略,避免把日志文件无限堆大。
Ruby 日志记录的几个实用原则
把日志写出来只是第一步,真正影响维护效率的,是日志内容是否克制、清晰、可追踪。
1. 日志级别要和场景匹配
高频路径里不要无节制记录大量 INFO 或 DEBUG,否则会增加性能开销,也会淹没真正重要的信息。
2. 不要写入敏感信息
密码、密钥等敏感数据不应进入日志。这不仅是安全要求,也能减少后续审计和合规风险。
3. 记录必要的上下文
像用户 ID、请求 ID 这样的上下文信息,对排查链路问题非常有帮助。日志消息本身再清楚,没有上下文也很难定位到具体请求或用户行为。
4. 让日志具备可读性
日志不是写给程序看的,而是写给开发者和运维人员看的。内容越清晰,排障成本越低。即使是简单输出,也应该尽量避免模糊、重复或无意义的文本。
总体来看,Ruby 自带的 Logger 已经能满足大多数基础日志需求。对于入门阶段,先把级别、输出目标和格式控制住,就能快速建立一套可用的日志方案;等进入生产环境,再补上轮转和更细致的管理策略,会更稳妥。









