

MySQL全表扫描与索引树扫描(index)的区别解析
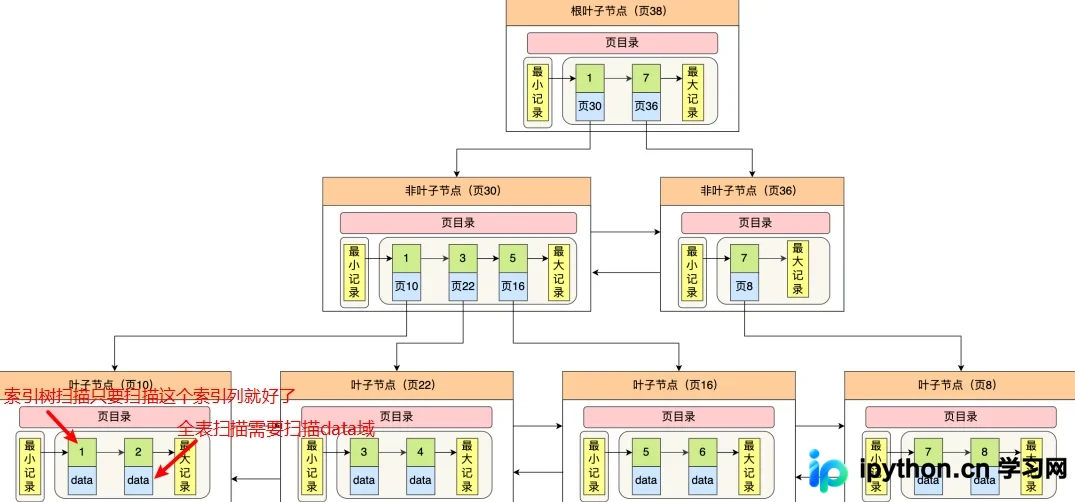
在MySQL中,EXPLAIN输出的type字段为ALL时代表全表扫描,为index时代表索引树扫描。两者底层均遍历聚簇索引B+树,但核心区别在于:索引树扫描若仅查询主键或覆盖列,可通过Using index优化避免回表;而全表扫描涉及非索引列时需读取完整行数据。本文通过实例对比两种场景的开销差异。
2026-10-15
6

在MySQL中,EXPLAIN输出的type字段为ALL时代表全表扫描,为index时代表索引树扫描。两者底层均遍历聚簇索引B+树,但核心区别在于:索引树扫描若仅查询主键或覆盖列,可通过Using index优化避免回表;而全表扫描涉及非索引列时需读取完整行数据。本文通过实例对比两种场景的开销差异。
本文整理了Oracle数据库中30条关键的SQL优化Hint语法,涵盖基于代价与规则的优化选择、全表与索引扫描策略、连接方式(嵌套循环、哈希、排序合并)以及视图合并与并行处理等。通过具体代码示例,解析如何精准控制执行计划以提升查询效率和数据插入速度。
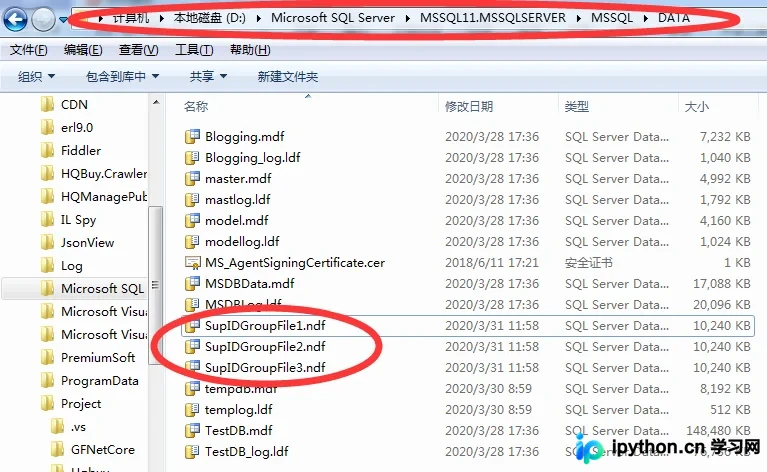
SQL Server表分区通过逻辑隔离数据提升大表读写性能。本文演示如何根据业务场景(如供应商ID)划分边界,依次创建文件组、指定存储路径、建立分区函数与方案,并通过SS图形界面或T-SQL完成表及索引分区。同时涵盖查看分区分布与维护优缺点分析。
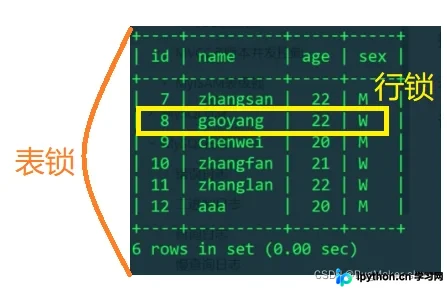
本文详解MySQL事务隔离机制下的锁策略,解析InnoDB存储引擎中表锁与行锁的适用场景。通过并发操作测试,验证排它锁(X锁)与共享锁(S锁)的互斥性,并深入剖析InnoDB行锁基于索引项而非记录实现的核心原理,帮助理解高并发环境下的数据一致性与性能平衡。
本文详解 MySQL 8 相较于 5.7 版本的核心差异。主要更新包括默认字符集升级为 utf8mb4 以原生支持 Emoji;引入隐藏索引便于性能调试;新增 SET PERSIST 持久化配置命令;完善通用表表达式(CTE)简化复杂查询;以及内置窗口函数替代繁琐的用户变量排名。这些改进显著提升了数据库的易用性、可维护性与查询优化能力。
本文深入解析MySQL中字符串字段的索引策略。通过对比全字段索引与前缀索引在B+树存储结构和查询回表过程中的差异,说明如何权衡存储空间与扫描行数。同时探讨覆盖索引在前缀场景下的失效问题,并提供身份证等低区分度字段使用哈希(crc32)和倒序存储的优化方案。
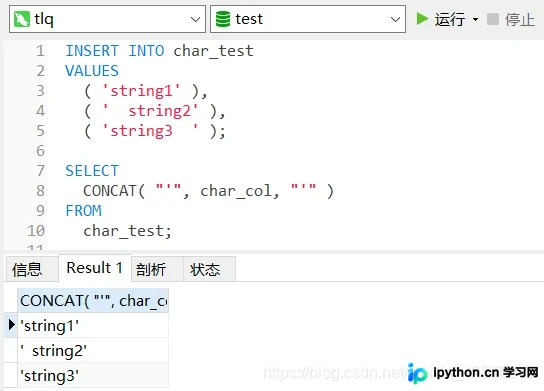
本文深入解析MySQL中CHAR与VARCHAR两种字符串类型的核心差异。CHAR为定长存储,适合短文本及高频更新场景;VARCHAR为变长存储且需额外字节记录长度,节省空间。通过SQL实例对比两者的存储行为,并给出基于数据特征、更新频率及字符集选择的最佳实践建议。
本文深入解析Django数据库性能优化策略,涵盖使用QuerySet.explain()分析执行计划、合理创建索引以平衡查询速度与存储成本、利用select_related和prefetch_related减少N+1查询问题,以及通过bulk_create和bulk_update进行批量数据操作的最佳实践,帮助开发者显著提升应用响应速度。
本文对Python学生信息管理系统进行了深度优化,重点介绍了利用sqlite3游标进行数据库连接及增删改查操作的方法。新增连表查询功能,并调整了二级菜单逻辑以优化退出体验。文章附带完整代码示例,旨在帮助开发者提升系统性能与代码规范性。
本文深入解析Django ORM中常见的数据库查询性能瓶颈,通过对比原始遍历查询与使用select_related、prefetch_related、only及defer方法后的执行次数,展示如何有效减少数据库交互。重点讲解主动联表与非主动联表的区别及适用场景,帮助开发者在保持代码简洁的同时显著提升应用性能。
在 Python 的 SQLAlchemy 框架中,使用负号(如 -Model.field)进行降序排序可能导致严重的性能问题。本文深入分析这一常见陷阱,对比使用负号与调用 .desc() 方法的执行效率,并展示如何通过正确的排序方式提升查询速度。此外,文章还提供了一个利用随机数与最大 ID 结合的高效随机数据抽取方案,帮助开发者避免全表扫描,实现高性能的数据处理。