MySQL DELETE子查询性能优化实战:FROM JOIN改写技巧
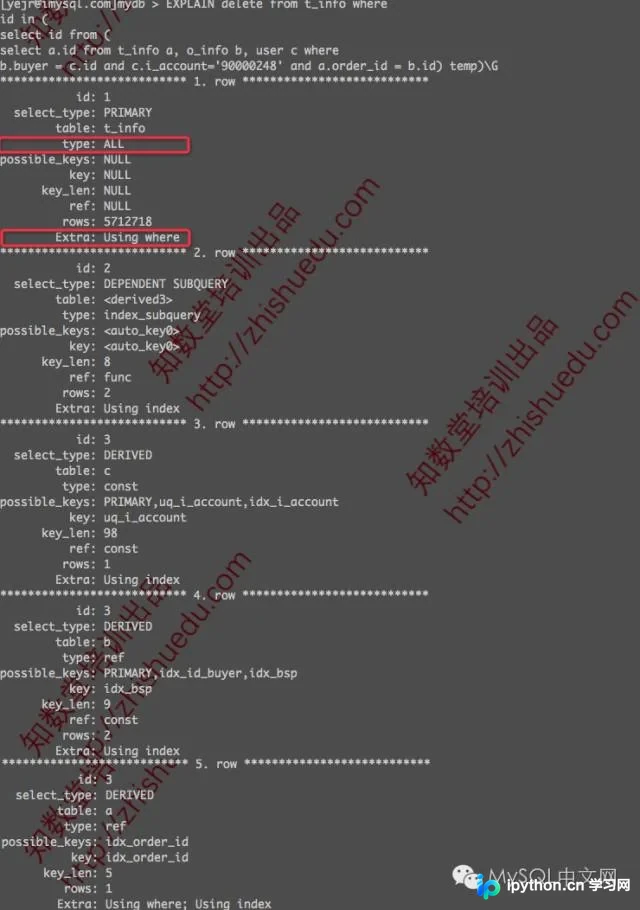
当MySQL的DELETE语句包含子查询导致执行极慢时,通常是因为查询优化器未能有效利用索引进行过滤。本文将通过具体案例对比分析,展示如何将低效的子查询改写为基于多表JOIN的DELETE语句。通过FROM子句关联临时结果集,可让优化器利用主键直接定位数据,避免全表扫描和回表,将耗时从30秒级降低至毫秒级。
2026-10-13
7

当MySQL的DELETE语句包含子查询导致执行极慢时,通常是因为查询优化器未能有效利用索引进行过滤。本文将通过具体案例对比分析,展示如何将低效的子查询改写为基于多表JOIN的DELETE语句。通过FROM子句关联临时结果集,可让优化器利用主键直接定位数据,避免全表扫描和回表,将耗时从30秒级降低至毫秒级。
本文汇总了MySQL中获取表最大ID、自增ID(Auto_increment)及记录总数的多种SQL方法与PHP实现。重点介绍了使用SHOW TABLE STATUS获取自增值和行数的最高效方式,对比了COUNT(*)的性能差异,并提供了完整的代码示例,帮助开发者快速解决常见数据统计需求。
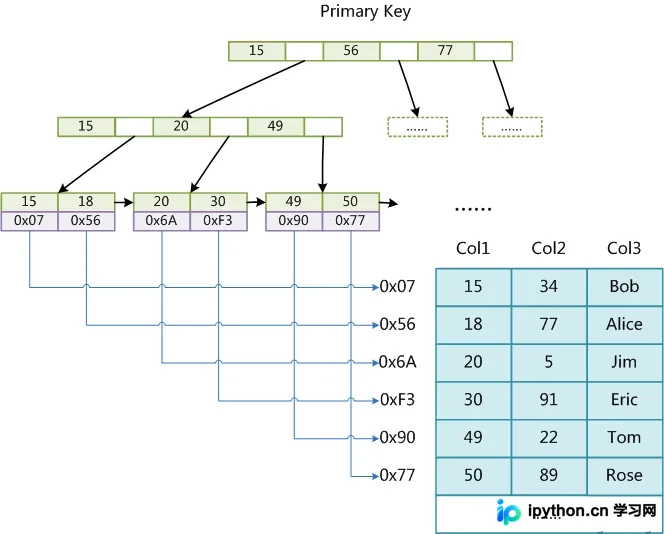
本文深入对比分析MySQL与Lucene的底层索引机制。MySQL基于B+Tree构建聚集与非聚集索引,适合精确匹配与范围查询;而Lucene采用倒排索引结构,通过Term Dictionary、Posting List实现高效的全文检索。文章详细剖析了两种索引在数据结构、内存消耗及联合查询上的核心差异,帮助开发者根据业务需求选择合适的数据存储与检索方案。
针对C#处理MySQL千万级数据的性能瓶颈,本文提出基于MySqlDataReader的原生SQL读取方案和分批合并INSERT的写入策略。通过关闭ORM开销、调整超时参数、利用StringBuilder构建长SQL并控制max_allowed_packet阈值,实现高吞吐量的数据迁移与处理流程。
本文深入解析MySQL中IN与EXISTS查询的执行差异。EXISTS通过逐行驱动子查询并返回布尔值,适合子查询结果集大的场景;IN则先执行子查询生成列表再匹配,适合主表大、子查询结果小的场景。实际选择需结合MySQL版本优化器逻辑与数据分布进行测试,避免盲目优化。
本文详解 MySQL 中 UNION 与 ORDER BY 同时使用的三种实现方式。通过具体示例说明直接混合使用会报错的原因,并分别介绍去除内部 ORDER BY、子查询包裹以及双层嵌套子查询的正确写法,确保查询结果按预期排序。
本文详细演示了在 SQL Server 2005 中,如何将包含大量历史数据的现有表通过分区技术拆分到不同文件组。核心步骤包括创建多个文件组、定义基于数值边界的分区函数,最后修改聚集索引位置触发数据物理重分布。该方法可实现不锁定全表的情况下完成大规模数据归档与性能优化。
在MySQL数据库中,默认的中文字符串排序通常基于Unicode编码而非拼音顺序。若需实现按拼音首字母(如A-Z)排序,可通过将字符集转换为GBK并利用其特定的校对规则(Collation)来实现。本文提供具体的SQL查询语句及原理说明,适用于需要按姓名、地名等中文内容首位字母筛选或展示的场景。
本文整理了14条常用的SQL语句操作技巧,涵盖插入后获取自增ID、性别字段映射、嵌套子查询、多数据库随机记录提取、重复数据查找、左右连接查询、范围筛选、日期计算及表结构复制等高频场景。通过具体代码示例,帮助开发者快速解决日常数据库开发中的常见问题,提升查询效率与代码规范性。
本文对Python学生信息管理系统进行了深度优化,重点介绍了利用sqlite3游标进行数据库连接及增删改查操作的方法。新增连表查询功能,并调整了二级菜单逻辑以优化退出体验。文章附带完整代码示例,旨在帮助开发者提升系统性能与代码规范性。
本文通过EXPLAIN执行计划深入分析MySQL中左连接(LEFT JOIN)和内连接(INNER JOIN)的优化方法。重点讲解驱动表与被驱动表的索引添加位置,揭示“左连接索引加右表”、“内连接小表驱动大表”的核心原则,帮助开发者避免全表扫描,提升SQL查询性能。

在MySQL数据库中,有时需要批量修改表中特定字段的文本内容。通过使用UPDATE语句配合REPLACE函数,可以高效地执行字符串替换操作。本文介绍基本语法、常见场景示例及风险规避方法,确保数据安全有效地完成数据清洗任务。