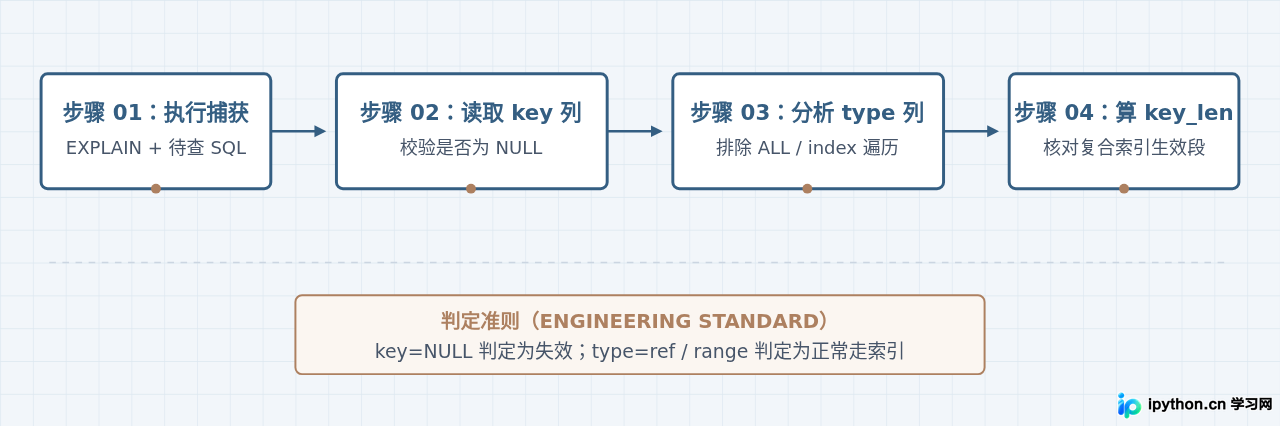
MySQL存储过程游标循环详解:批量汇总成绩数据实战
本文详细介绍在MySQL中使用存储过程进行数据处理的实战技巧,重点讲解基于游标的循环结构。通过学生成绩汇总的完整案例,从建表、初始化数据到编写包含REPEAT循环和异常处理器的存储过程代码,演示如何遍历记录并执行批量插入。同时提供DBA视角的使用建议,明确存储过程适用的数据迁移场景及业务逻辑限制。
2026-10-13
6

本文详细介绍在MySQL中使用存储过程进行数据处理的实战技巧,重点讲解基于游标的循环结构。通过学生成绩汇总的完整案例,从建表、初始化数据到编写包含REPEAT循环和异常处理器的存储过程代码,演示如何遍历记录并执行批量插入。同时提供DBA视角的使用建议,明确存储过程适用的数据迁移场景及业务逻辑限制。
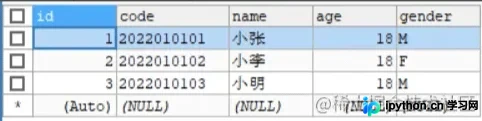
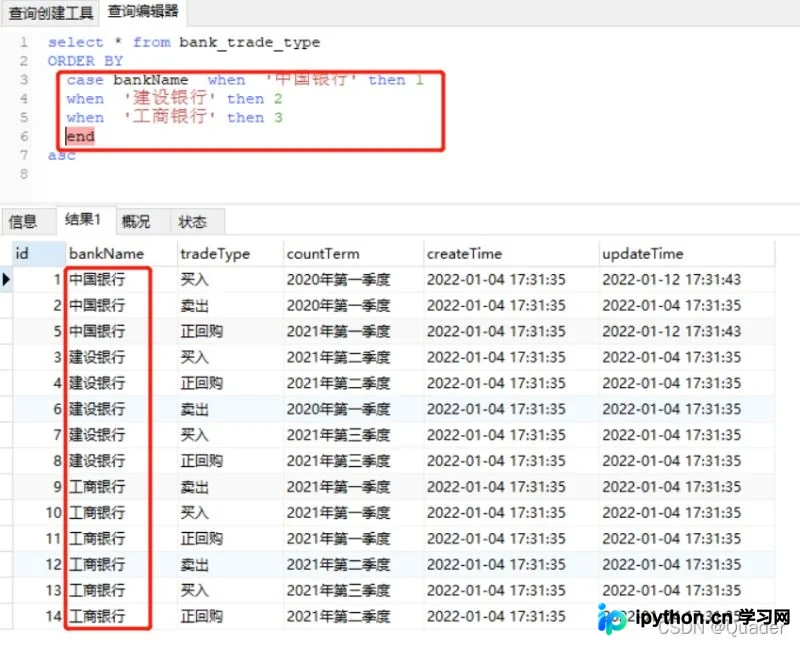
在MySQL查询中,当需要按照非字母或数字的自然顺序(如中国银行、建设银行)进行排序时,常规ORDER BY失效。本文详细解析5种解决方案:使用CASE WHEN转换权重、推荐利用FIELD()函数直接指定、借助LOCATE/INSTR查找位置,以及通过数据字典表关联维护。涵盖SQL代码示例与适用场景,解决复杂业务排序难题。
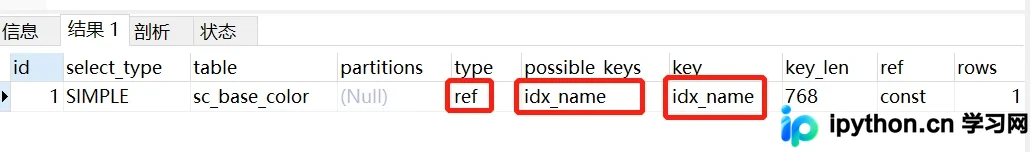
本文通过MySQL 8.0环境下的实测验证了包含NULL值的普通索引和组合索引是否会失效。结果显示,等值查询(=)及部分范围查询通常能使用索引;而IS NULL/IS NOT NULL的索引命中情况受数据分布比例影响。文章同时总结了数据库设计时避免NULL值的潜在风险及替代方案。
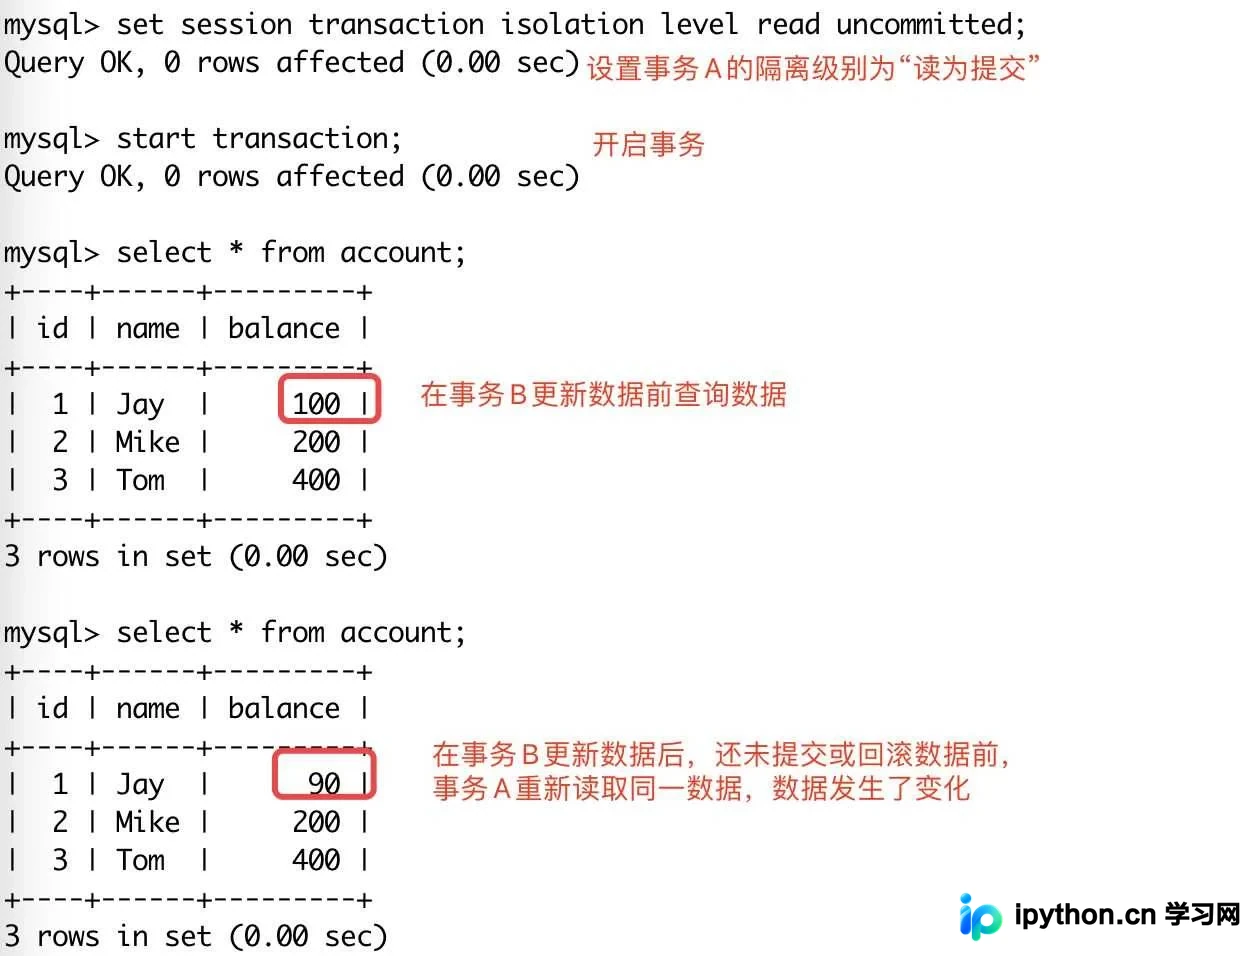
本文深入解析MySQL事务的四种隔离级别(读未提交、读已提交、可重复读、串行化)及其解决的并发问题。通过ACID特性介绍、三种并发异常现象定义,结合具体SQL演示与InnoDB引擎的Next-Key Lock机制,阐明为何在InnoDB中“可重复读”级别能彻底解决幻读问题,为数据库设计与调优提供理论依据。
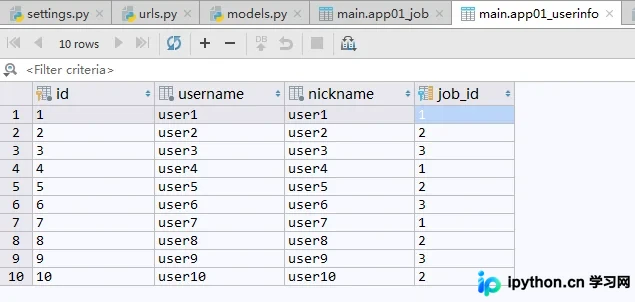
本文深入解析Django ORM中常见的数据库查询性能瓶颈,通过对比原始遍历查询与使用select_related、prefetch_related、only及defer方法后的执行次数,展示如何有效减少数据库交互。重点讲解主动联表与非主动联表的区别及适用场景,帮助开发者在保持代码简洁的同时显著提升应用性能。
本文详细讲解如何在MySQL和Oracle中查询及删除数据库中的重复记录。针对单字段和多字段重复场景,提供了基于GROUP BY、ROWID临时表及子查询的高效SQL写法。重点对比了不同方法的优劣及适用环境,帮助用户快速清理冗余数据并预防重复发生。
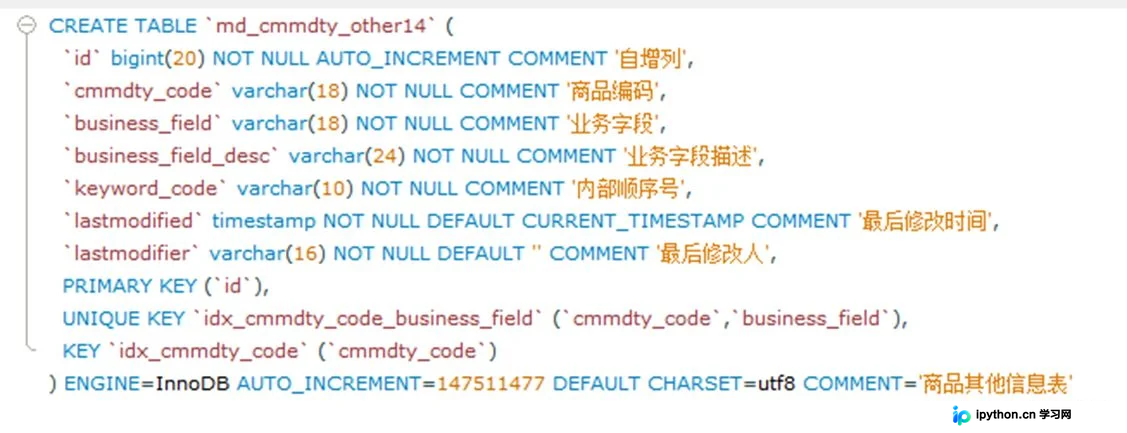
在 MySQL RC 隔离级别下,先删后增操作配合唯一联合索引极易引发死锁。本文通过复现死锁日志和源码分析,指出 RC 级别下唯一键冲突检查会触发间隙锁,导致相邻事务竞争排他锁而形成循环等待。解决方案是废弃先删后增逻辑,采用全量数据的更新与新增合并策略。
本文详细介绍 SQL 中处理重复记录的常用方法。通过 Distinct 实现简单去重,利用 Group By 和 Having 筛选重复项及统计数量。针对需要保留特定记录的复杂场景,提供基于临时表的全量去重方案,以及使用子查询按主键最大值保留唯一记录的精确删除逻辑,帮助高效解决数据库脏数据问题。
本文深入解析 MySQL 中 COUNT(*)、COUNT(1) 和 COUNT(列名) 的执行差异。指出两者在 InnoDB 中等效,但 COUNT(列名) 需进行非空判断且性能较低。详细阐述了 MyISAM 通过表级元数据缓存和 InnoDB 通过最左索引扫描的底层优化逻辑,并结合《阿里巴巴Java开发手册规范》推荐 COUNT(*) 的原因进行说明。
在 Python 的 SQLAlchemy 框架中,使用负号(如 -Model.field)进行降序排序可能导致严重的性能问题。本文深入分析这一常见陷阱,对比使用负号与调用 .desc() 方法的执行效率,并展示如何通过正确的排序方式提升查询速度。此外,文章还提供了一个利用随机数与最大 ID 结合的高效随机数据抽取方案,帮助开发者避免全表扫描,实现高性能的数据处理。