

MySQL关联查询优化:LEFT JOIN与INNER JOIN索引策略详解

MySQL关联查询的性能瓶颈常源于不当的执行顺序和无索引的全表扫描。通过分析 LEFT JOIN 和 INNER JOIN 的执行计划(EXPLAIN),我们可以明确索引的最佳放置位置:左连接时应将索引建立在被驱动表(右表),内连接时则倾向于让小数据量的表作为驱动表。掌握这些规则能显著降低查询成本。
准备测试环境与数据
为了直观展示不同连接方式的差异,我们首先创建两个简单的测试表 type 和 book,并插入若干数据用于演示。表中 card 字段为关联键,但初始状态下均未建立索引。
#分类
CREATE TABLE IF NOT EXISTS `type` (
`id` INT(10) UNSIGNED NOT NULL AUTO_INCREMENT,
`card` INT(10) UNSIGNED NOT NULL,
PRIMARY KEY (`id`)
);
#图书
CREATE TABLE IF NOT EXISTS `book` (
`bookid` INT(10) UNSIGNED NOT NULL AUTO_INCREMENT,
`card` INT(10) UNSIGNED NOT NULL,
PRIMARY KEY (`bookid`)
);
左外连接(LEFT JOIN)优化
左连接的特点是:左表(驱动表)的所有记录都会返回,右表若无匹配则填 NULL。理解其执行逻辑是优化的关键。
第1步:无索引时的执行分析
首先查看在没有索引情况下的执行计划。MySQL 会选择 type 作为驱动表,book 作为被驱动表,并将结果集暂存在 Join Buffer 中进行 Block Nested Loop(BNL)算法处理。
EXPLAIN SELECT SQL_NO_CACHE * FROM `type` LEFT JOIN book
ON type.card = book.card;

观察执行计划可以看出:
type表的type列显示为all,表示进行了全表扫描。book表同样进行了全表扫描。- 由于数据量较小,MySQL 使用了
join buffer进行缓存优化,但这在大数据量下会成为性能杀手。
此时,驱动表每读取一行数据,都需要在被驱动表进行一次全表比对。若 type 有 20 条数据,这个过程将重复 20 次。
第2步:在被驱动表(右表)添加索引
根据优化原则,对于 LEFT JOIN,如果只能添加一个索引,应将其添加在被驱动表上,以加速 lookup 过程。
CREATE INDEX Y ON book(card);
EXPLAIN SELECT SQL_NO_CACHE * FROM `type` LEFT JOIN book
ON type.card = book.card;

再次观察执行计划,虽然驱动表 type 仍然需要遍历所有行(因为必须保证左表所有数据返回),但在针对每一行去 book 表查找匹配项时,走的是 ref(索引查找)而非全表扫描。对于 B+ 树索引,时间复杂度从 O(N) 降为 O(logN),性能显著提升。
第3步:对比仅在驱动表添加索引的情况
如果我们仅在驱动表 type 上建立索引会发生什么?
CREATE INDEX X ON `type`(card);
EXPLAIN SELECT SQL_NO_CACHE * FROM `type` LEFT JOIN book
ON type.card = book.card;

可以看到,虽然 type 表可能走了索引文件扫描,但其核心任务仍是遍历所有记录。真正的瓶颈在于被驱动表 book 依然没有索引,每次匹配仍需全表扫描。这导致整体效率提升有限。
第4步:进一步验证索引位置的影响
为了更清晰看到差异,我们删除 book 表上的索引,重新运行查询并查看查询成本。
DROP INDEX Y ON book;
EXPLAIN SELECT SQL_NO_CACHE * FROM `type` LEFT JOIN book
ON type.card = book.card;

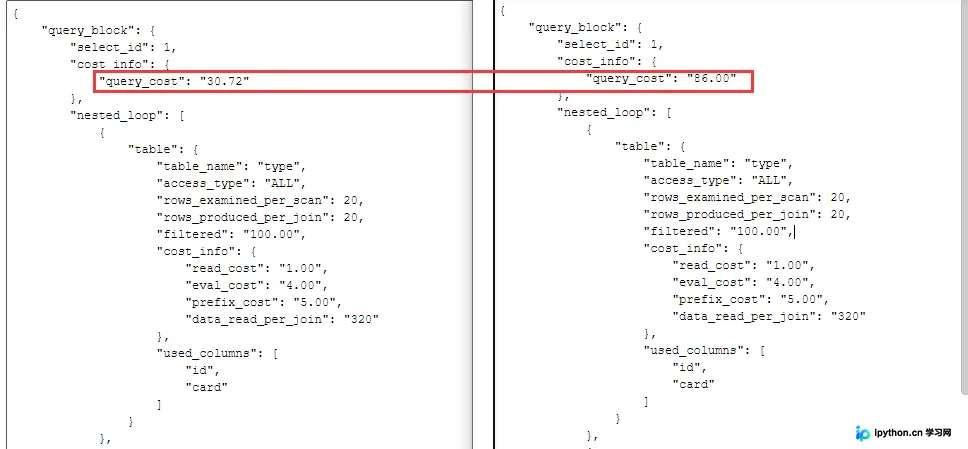
结论: 左连接(LEFT JOIN)时,索引务必加在右表(被驱动表)的连接字段上。同理,如果是右连接(RIGHT JOIN),索引则应加在左表。此外,确保两表连接字段的数据类型一致也是避免隐式转换导致索引失效的重要前提。
内连接(INNER JOIN)优化
内连接只返回两个表中连接字段相匹配的记录。与左连接不同,MySQL 的优化器在内连接中具有更大的自由度来选择谁做驱动表。
第1步:无索引或单边索引的分析
去掉之前所有的索引,查看最基础的执行计划。
DROP INDEX X ON `type`;
EXPLAIN SELECT SQL_NO_CACHE * FROM `type` INNER JOIN book
ON type.card = book.card;

接着,仅给被驱动表 book 添加索引:
CREATE INDEX Y ON book(card);
EXPLAIN SELECT SQL_NO_CACHE * FROM `type` INNER JOIN book
ON type.card = book.card;

再给驱动表 type 添加索引:
CREATE INDEX X ON `type`(card);
EXPLAIN SELECT SQL_NO_CACHE * FROM `type` INNER JOIN book
ON type.card = book.card;

当两表均有索引时,二者都采用了索引查找。值得注意的是,MySQL 优化器可能会自动调整驱动表和被驱动表的顺序,不再严格遵循 SQL 语句书写的左右顺序。
第2步:单边索引时的驱动表选择
假设 book.card 没有索引,而 type.card 有索引。MySQL 会如何选择?
DROP INDEX Y ON book;
EXPLAIN SELECT SQL_NO_CACHE * FROM `type` INNER JOIN book
ON type.card = book.card;
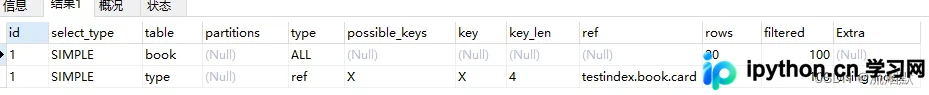
执行计划显示,book 成为了驱动表,type 成为了被驱动表。这表明:在内连接中,如果只有一个表有索引,有索引的表会被选为被驱动表,以便利用索引快速过滤数据。
第3步:数据量不一致时的“小表驱动大表”
假设我们将 type 表的数据增加到 40 条,而 book 表保持 20 条,且两表都有索引。
EXPLAIN SELECT SQL_NO_CACHE * FROM `type` INNER JOIN book
ON type.card = book.card;

在这种情况下,优化器通常会选择数据量较小的表作为驱动表(即“小表驱动大表”)。原因是遍历小表的次数更少,对大表进行索引查找的总开销最低。
结论: 对于 INNER JOIN,在两表连接条件均有索引的情况下,MySQL 倾向于选择行数较少的表作为驱动表。这也是为什么常说内连接遵循“小表驱动大表”的原则。
以上就是 MySQL 关联查询优化的详细内容,更多关于 MySQL 性能调优的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









