Python SQLAlchemy ORM:从Mapping到Declarative的演进
本文深入解析Python SQLAlchemy中ORM映射的两种实现方式。首先介绍传统的mapper函数映射机制,通过定义Table、类及mapper关联实现对象与数据表对应;随后重点讲解Declarative声明式系统,展示如何继承Base类简化映射配置。通过对比两种方式的代码结构,帮助开发者理解ORM底层原理并选择合适方案。
2026-10-13
6

本文深入解析Python SQLAlchemy中ORM映射的两种实现方式。首先介绍传统的mapper函数映射机制,通过定义Table、类及mapper关联实现对象与数据表对应;随后重点讲解Declarative声明式系统,展示如何继承Base类简化映射配置。通过对比两种方式的代码结构,帮助开发者理解ORM底层原理并选择合适方案。
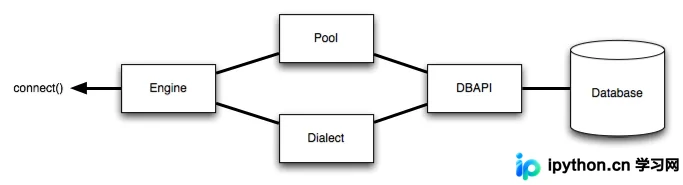
本文深入解析 SQLAlchemy 中 Engine 的核心作用,阐述其如何通过连接池(Pool)和方言(Dialect)驱动数据库交互。重点介绍 create_engine 的初始化流程、延迟连接机制,以及 echo、pool_size、pool_recycle 和 pool_pre_ping 等关键参数的配置方法,帮助开发者优化数据库连接效率与稳定性。
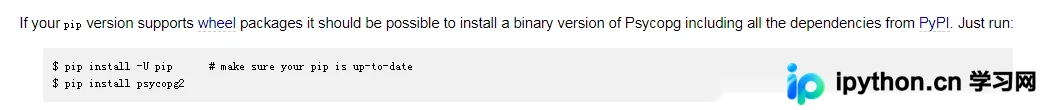
本文详细记录了在Windows 7环境下,针对Python3安装psycopg2时遇到的常见坑点。通过官方文档指引,采用Wheel二进制包方式简化安装流程。重点解决了Anaconda环境下pip命令不可用的环境变量配置问题,并补充了非Anaconda版本Python中pip缺失的修复方案及SQL注入防护机制说明。
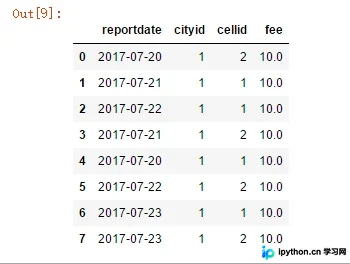
本文介绍如何利用pandas的to_sql方法将DataFrame数据保存至数据库。重点解析chunksize批量处理、if_exists冲突策略及index索引控制等关键参数,结合MySQL连接与数据汇总示例,展示从数据读取、处理到入库的完整流程。
本文详细介绍如何利用 Python 脚本连接 Zabbix 数据库,提取 CPU、内存及 Swap 等关键性能指标,并自动生成 Excel 格式监控报表。通过配置数据库连接参数与查询 Key 列表,实现自动化数据抓取与格式化输出,适用于 Zabbix 3.2 环境下的运维报表需求。
本文针对PyCharm远程部署中常见的两个配置问题进行详解。首先解决服务器端环境变量(如LD_LIBRARY_PATH)无法被PyCharm完整识别导致的模块加载失败问题,通过在.bashrc中配置解决。其次,针对控制台输出及数据库读取时的中文乱码现象,提供修改pycharm.exe.vmoptions添加UTF-8编码参数及统一文件编码的具体操作步骤,确保开发环境一致性。
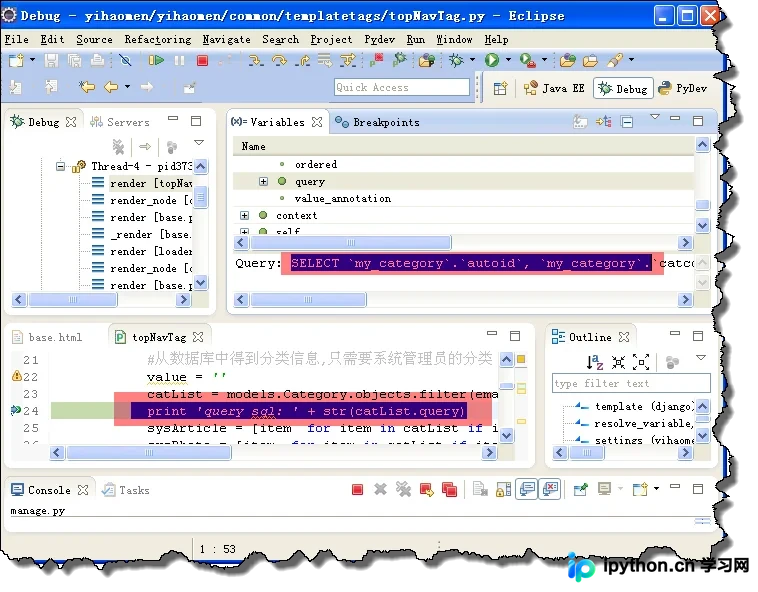
本文详细解析了在Django框架中获取ORM生成的原生SQL语句的五种方法。包括通过数据库日志、Query对象属性、DEBUG模式配置、第三方中间件以及查看connections查询记录等方式。重点推荐了基于中间件的插拔式方案,适用于开发调试阶段,帮助开发者验证查询效率与正确性。
本文详解Django中如何控制Model创建的数据库索引顺序,特别是涉及ForeignKey时的处理技巧。同时介绍联合约束unique_together与联合索引index_together的配置方法,通过具体案例说明联合索引在大数据量查询中的性能优势及SQL执行逻辑。
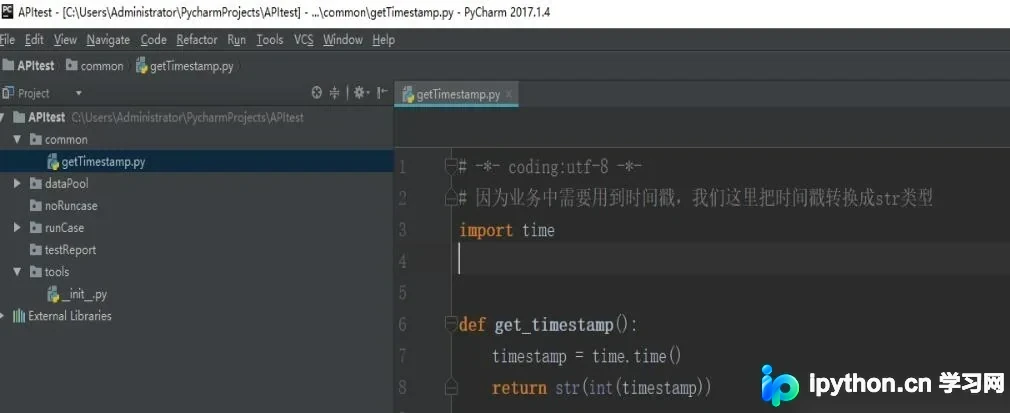
本文详解如何利用 Python 搭建企业级 API 自动化测试框架。通过分层设计思路,将项目划分为数据池、配置、工具及用例层,并重点演示公共方法层中时间戳转换的实现,以及基于 YAML 的数据库多环境配置管理,为 API 自动化提供标准化代码结构参考。
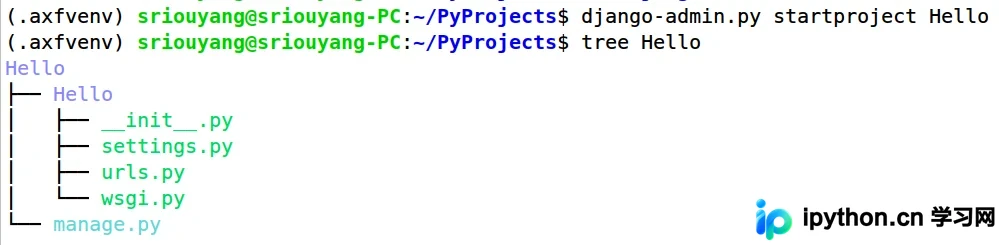
本文详细介绍如何使用Django框架从零开始创建HelloDjango项目。内容涵盖虚拟环境配置、MTV架构各文件作用、子应用创建与注册、数据模型定义、数据库迁移、静态资源配置及路由映射。通过完整代码示例,帮助开发者快速掌握Django核心功能并运行测试。
本文介绍如何使用Python工具sqlacodegen自动生成ORM实体类。通过安装该工具,指定数据表名称和输出文件,可快速生成如Fund.py的映射代码,避免手动编写,提高开发效率。
本文详细讲解如何使用Python通过PyMySQL库与MySQL数据库进行交互。内容涵盖库的安装配置、数据库连接方法、Cursor游标类型(DictCursor与Cursor)的区别及结果集处理,以及execute与executemany的多条数据插入技巧。此外,还演示了如何利用ON DUPLICATE KEY UPDATE语法实现存在即更新、不存在则插入的数据入库策略,并提供完整的基金数据抓取入库代码示例。