Python pip手动安装二进制包解决Visual C++报错
在使用pip安装mysqlclient等扩展包时,常遇到Microsoft Visual C++ 14.0缺失报错。本文详解如何通过下载对应的.whl二进制文件进行手动安装,解析文件名中cp38、win32等参数含义,并给出具体cmd命令行操作步骤,无需安装额外的C++编译工具即可解决依赖问题。
2026-10-14
6

在使用pip安装mysqlclient等扩展包时,常遇到Microsoft Visual C++ 14.0缺失报错。本文详解如何通过下载对应的.whl二进制文件进行手动安装,解析文件名中cp38、win32等参数含义,并给出具体cmd命令行操作步骤,无需安装额外的C++编译工具即可解决依赖问题。
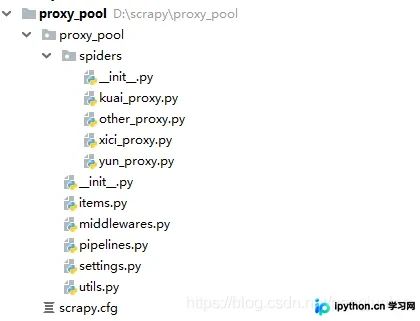
本文详细介绍如何使用Scrapy-Redis框架搭建高效的IP代理池。内容涵盖从快代理等网站批量爬取IP、通过请求验证IP可用性,以及利用Redis存储和管理代理池的完整流程。相比传统requests方案,该方法能显著提升爬取速度并解决高频访问限制问题,适合需要大规模数据采集的场景。
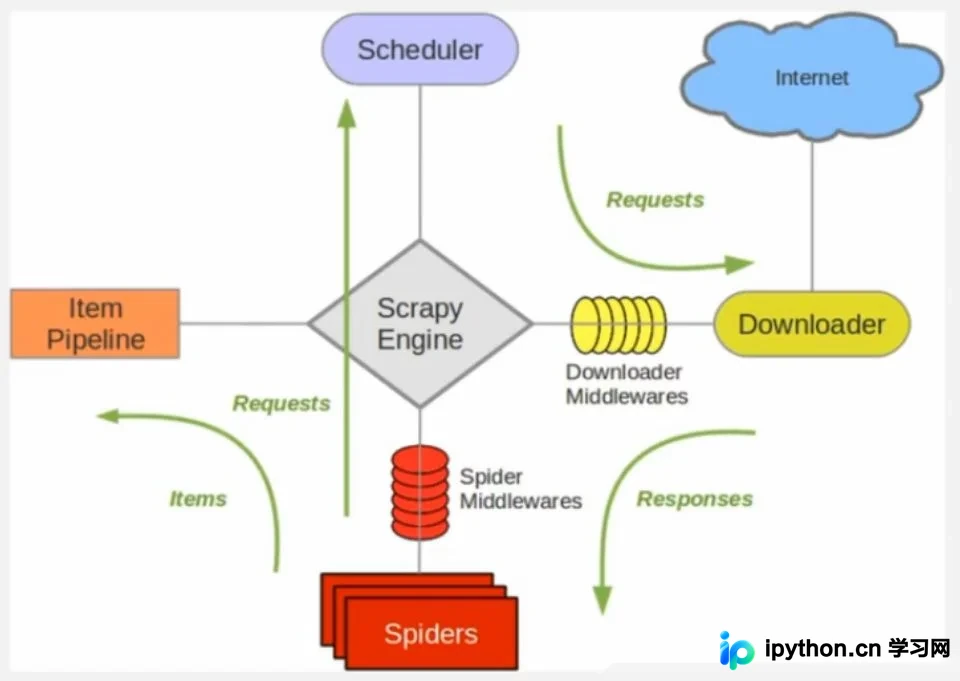
本文深入解析Scrapy-Redis分布式爬虫的核心原理与搭建流程。通过对比Scrapy与Scrapy-Redis的架构图,详细阐述Master端与Slaver端的协作机制,包括URL指纹判重、Request分配及数据存储策略。同时提供从环境配置、依赖安装到代码编写的完整实操指南,帮助开发者高效构建高性能分布式数据采集系统。
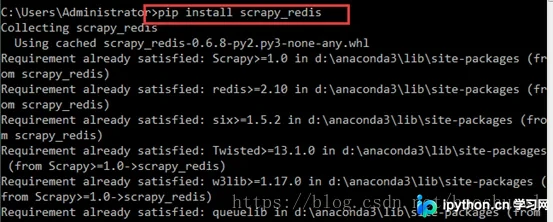
本文详细介绍如何利用scrapy_redis库将Scrapy爬虫升级为分布式架构。内容涵盖环境准备、Settings配置修改、Spider类重写以及Redis数据源注入等关键步骤,帮助开发者实现多台服务器共享URL去重与数据存储,提升爬取效率。
本文详细介绍Python爬虫代理池的搭建流程。针对IP访问频率限制问题,提出通过代理池轮询IP的解决方案。涵盖从代理网站抓取、可用性验证、Redis存储到队列管理的完整代码实现,包含IPProxy类、配置管理及多爬虫基类设计,并提供测试与GitHub源码地址。
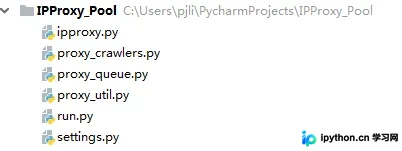
本文详细解析 Scrapy 中 settings.py 的关键配置项。涵盖字符编码设置、Redis 连接参数(含密码与数据库指定)、请求超时与重试机制优化,以及基于 scrapy-redis 的去重组件、调度器和持久化断点续爬功能的配置方法。通过调整 DUPEFILTER_CLASS、SCHEDULER 及 SCHEDULER_QUEUE_CLASS 等参数,实现高效分布式爬虫与数据持久化存储。
本文详细介绍Python中Faker库的安装与基础用法。通过设置locale参数支持多语言环境,涵盖地理、基础信息、网络、加密及时间等类别的随机数据生成方法。最后通过MySQL连接示例,演示如何结合Faker实现数据库表的批量测试数据插入,提升开发测试效率。
本文详细介绍如何使用Python通过pymysql库连接MySQL数据库。内容涵盖环境安装、连接参数配置、利用pandas read_sql及游标cursor两种方式读取数据,以及插入、更新、删除等事务处理与结果获取方法,帮助开发者快速实现数据库交互。
本文介绍如何使用Python脚本统计MySQL数据库每日数据量变化,并在数据波动超过设定阈值时,通过调用指定接口发送告警通知。代码涵盖数据库连接、日期计算、数据查询及HTTP请求发送,适用于自动化运维场景。
本文详细介绍在PyCharm环境下使用Django连接本地MySQL数据库的配置步骤。主要内容包括修改settings.py中的DATABASES配置,通过pip安装pymysql依赖,在__init__.py中注册驱动以解决版本兼容问题,最后执行migrate命令完成数据库迁移。
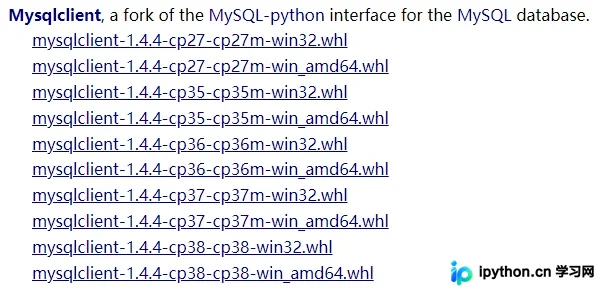
本文详细讲解在 Windows 环境下为 Django 项目安装 mysqlclient 的替代方案,解决 pip 直接安装常见的编译错误。通过下载预编译 wheel 文件并指定版本进行本地安装,成功配置数据库连接。随后演示如何在 Django 中创建应用、定义 Model、注册 Admin、配置 settings.py 以及编写视图和 URL,实现 MySQL 数据的增删改查功能。
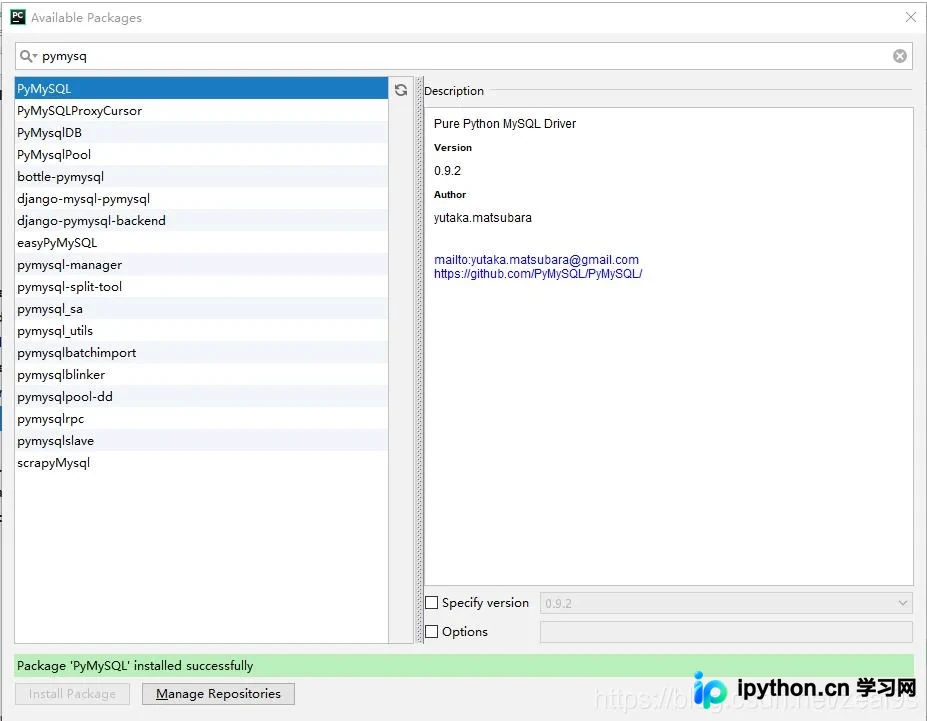
本文详细讲解如何在PyCharm中通过pip安装PyMySQL模块,并针对Python 3.6+版本常见的No module named 'pymysql'报错提供排查方案。重点分析项目解释器配置错误导致site-packages未包含该库的问题,指导用户通过重新创建项目并勾选正确选项来彻底解决模块导入失败的情况。