Python分布式爬虫中消息队列知识点详解
本文详细解析Python分布式爬虫中消息队列的核心作用,通过生活化类比阐释其去重与任务分发机制。重点介绍如何利用Redis队列构建生产端,实现多爬虫节点对URL任务的有序获取与高效处理,避免重复爬取,为构建高性能分布式爬虫系统提供实践参考。
2026-10-14
6

本文详细解析Python分布式爬虫中消息队列的核心作用,通过生活化类比阐释其去重与任务分发机制。重点介绍如何利用Redis队列构建生产端,实现多爬虫节点对URL任务的有序获取与高效处理,避免重复爬取,为构建高性能分布式爬虫系统提供实践参考。
本文提供Python调用Redis的完整示例代码,通过封装MyRedis类实现服务器连接、有序集合添加与计数等常用操作。代码包含详细的参数配置说明,适用于需要快速集成Redis功能的Python项目,帮助开发者掌握基础连接与数据结构交互方法。
本文详解Python Scrapy框架中项目数据的持久化处理方案。针对抓取数据需后期分析的需求,重点介绍如何将默认的文件存储切换至MySQL数据库。通过修改settings.py配置文件,启用SavetoMySQLPipeline并配置数据库连接参数,实现高效的数据存储与管理,避免文件散乱带来的检索难题。
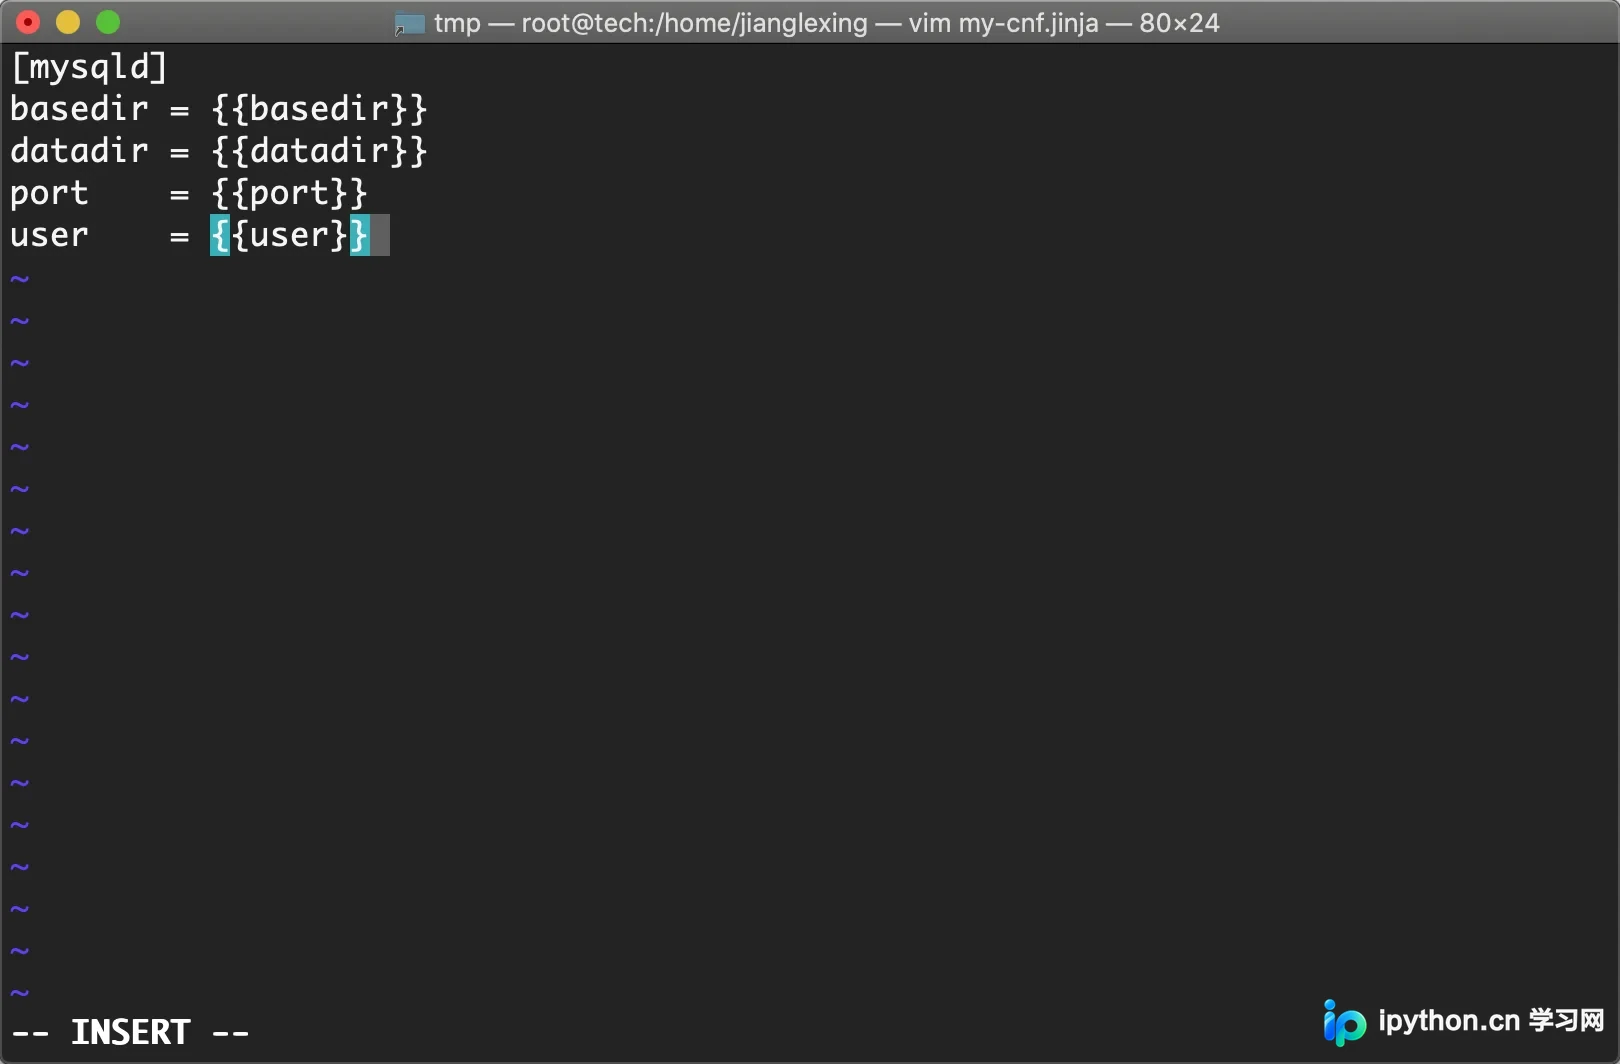
本文介绍如何利用 Python 的 Jinja2 模板引擎动态生成 MySQL 配置文件 my.cnf。通过定义模板变量并传入具体参数,如数据目录、端口和用户等,程序可自动渲染出符合规范的配置文件内容,简化了自动化部署流程。
本文详解Python中将IPv4地址转换为整数的原理,通过struct模块打包字节串并转为整数,实现数据库存储空间的节省。同时对比了传统inet_aton/ntoa函数与兼容IPv6的inet_pton/ntop API,指出在IPv6普及背景下,VARCHAR存储可能更具通用性。
本文详细介绍如何从零开始创建一个结构清晰的Flask项目。内容涵盖依赖安装、项目目录规划、配置文件编写、ORM与迁移工具集成、蓝图创建及注册流程,以及数据模型定义和数据库迁移命令的使用,帮助开发者快速建立可扩展的Web应用基础架构。
本文详解如何使用Python的pymysql库更新数据库中的单个字段。通过连接数据库、定义游标及执行UPDATE语句,实现根据ID动态修改指定字段的值。文章包含完整的代码示例,涵盖输入处理、异常捕获及事务提交回滚机制,帮助开发者掌握数据库字段更新的核心操作。
本文详细解析Django中执行原生MySQL语句的三种主要方式:利用extra方法修改查询集、通过raw方法返回模型实例以及使用数据库游标执行自定义SQL。文章对比了各方法的依赖关系、适用场景及具体代码实现,帮助开发者根据需求选择最合适的数据库操作方案。
本文详解Django项目中配置多个数据库的方法,包括通过DATABASE_ROUTERS实现App与数据库的绑定,以及使用using()指定读写库。同时涵盖Django 1.6至1.7+版本的数据库同步命令,以及针对多库环境的dumpdata导出与loaddata导入操作,确保数据在不同数据库间准确迁移。
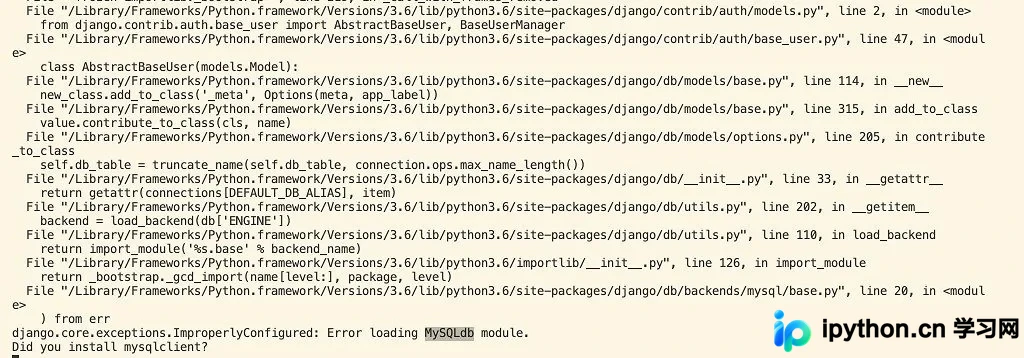
本文解决 Django 2.0 使用 MySQL 数据库时常见的两个启动错误。首先针对找不到 mysqlclient 模块的问题,通过在 __init__.py 中引入 pymysql 并调用 install_as_MySQLdb() 进行兼容处理;其次针对版本检查报错,通过注释 Django 源码中 base.py 文件的版本校验代码来绕过限制,确保项目正常启动。
本文介绍如何使用Python的Tkinter库构建可视化界面,结合PyMySQL库对MySQL数据库进行暴力破解测试。通过输入主机、端口、用户名等参数,利用字典文件逐行读取密码进行连接尝试,成功则返回密码,失败则继续。
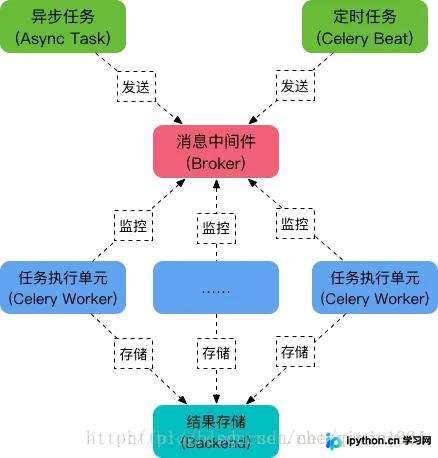
本文详细介绍如何在Django项目中集成Celery以实现异步和定时任务。涵盖Celery架构模块、环境配置(Django、Redis版本建议)、Broker与Worker设置,以及通过django-celery创建和调用异步任务的具体步骤。