

Django Serializers 序列化指定字段的方法
本文介绍在Django中使用内置Serializers进行数据序列化时,如何通过添加fields选项来精确控制返回的字段。通过对比默认行为与指定字段配置,展示如何排除如username和id等不需要的字段,确保API返回数据精简且符合需求。
2026-10-13
6

本文介绍在Django中使用内置Serializers进行数据序列化时,如何通过添加fields选项来精确控制返回的字段。通过对比默认行为与指定字段配置,展示如何排除如username和id等不需要的字段,确保API返回数据精简且符合需求。
本文介绍如何在Python中使用zip函数将二维列表转换为JSON格式。通过zip打包键值对,结合dict与json.dumps实现数据序列化,支持中文输出与缩进排版,适用于数据结构化展示与API接口开发场景。
本文介绍如何使用Python的kafka-python库实现Kafka消息的JSON格式读写。重点解析生产者KafkaProducer中value_serializer参数的配置,通过json.dumps将字典编码为UTF-8字节流;以及消费者KafkaConsumer中value_deserializer参数的设置,利用json.loads解析消息。示例包含完整的连接配置、数据构造及循环发送逻辑,适用于需要结构化数据传输的场景。
本文详解Python中字典与JSON的核心区别,指出JSON强制双引号而字典灵活,并解析传输时需序列化。重点区分json.dumps/loads处理字符串与json.dump/load操作文件的场景,通过代码示例展示字典转JSON及文件读写的具体实现,帮助开发者正确进行数据序列化与持久化。
本文详细介绍Python中处理JSON数据的两种核心方法:解码[[wp:a0]]与编码[[wp:a1]]。通过具体代码示例,展示如何将JSON字符串转换为Python字典对象,以及如何将Python字典序列化为JSON格式字符串,并附带相关在线工具推荐。
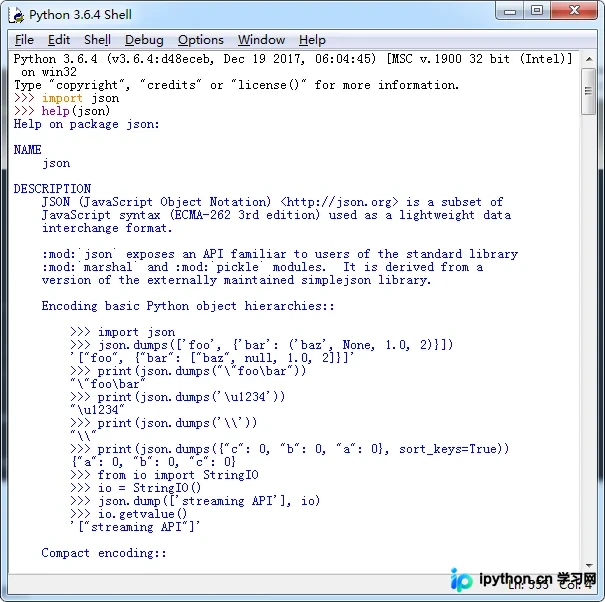
本文深入解析Python中JSON字符串与字典对象的区别。JSON作为轻量级数据交换格式,仅支持字符串键和特定值类型;而Python字典基于哈希表实现,提供O(1)读取速度且支持任意可哈希对象作为键。文章详细对比了两者在键值类型、访问方式、默认值处理及布尔值表示上的差异,并解释了哈希表在Python中的工作原理,帮助开发者根据场景选择合适的数据结构。
本文详细介绍Python中json模块的四个核心函数:dumps、loads、dump和load。通过具体代码示例,解析如何将字典转换为字符串、将字符串解析为字典,以及如何读写JSON文件。内容涵盖常见报错原因及解决方案,帮助开发者掌握数据序列化与反序列化的正确用法。
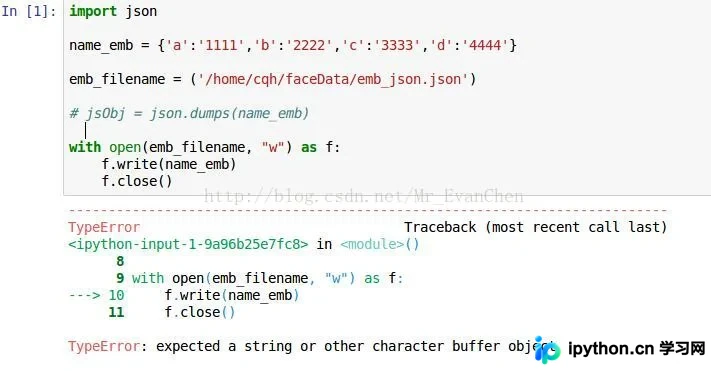
本文介绍了如何使用Python的MySQLdb库连接MySQL数据库,执行SQL查询语句,并将结果集转换为JSON格式返回。通过示例代码展示了从建立连接到关闭连接的完整流程,包括异常处理和数据序列化细节,为开发者提供实用的参考方案。
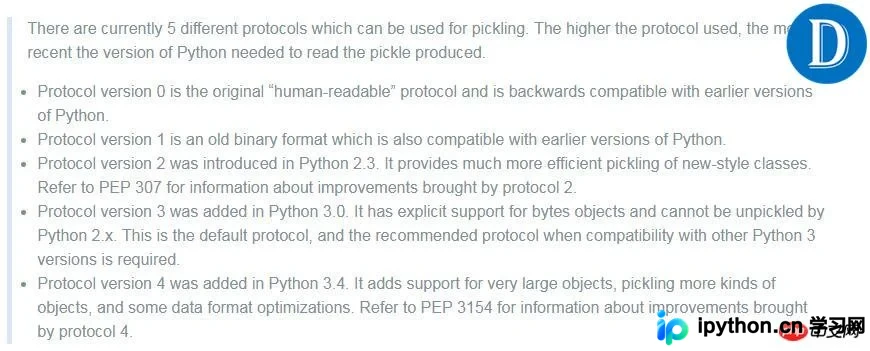
本文深入解析Python标准库Pickle的序列化与反序列化机制。详细讲解pickle.dump、pickle.dumps、pickle.load及pickle.loads等核心API的参数用法,对比Protocol版本差异,并通过完整代码示例展示如何将Python对象持久化存储至.pkl文件及在网络间高效传输。
本文详细介绍Python3中利用json模块进行数据序列化的方法。重点讲解如何将字典转换为JSON字符串,以及在处理中文字符时如何通过指定[[wp:a1]]参数确保编码正确。同时演示列表对象的JSON序列化过程,并提供Android Studio中GsonFormat插件的使用建议,帮助开发者高效处理前后端数据交互。
本文介绍Python中利用pickle模块存储原生对象的方法。相比直接写入文件或滥用eval函数,pickle能直接保存对象结构且无需手动类型转换。文章通过示例演示了dump和load的使用,并指出文件名冲突导致的常见错误,帮助开发者安全高效地处理数据持久化。
本文深入解析Python标准库json模块,详细阐述JSON格式与Python数据类型的对应关系,包括字典、列表、字符串等类型的转换规则。同时对比分析dump、dumps、load、loads四个核心函数的适用场景,帮助开发者掌握数据序列化与反序列化的最佳实践。