Django Serializers 序列化指定字段的方法
本文介绍在Django中使用内置Serializers进行数据序列化时,如何通过添加fields选项来精确控制返回的字段。通过对比默认行为与指定字段配置,展示如何排除如username和id等不需要的字段,确保API返回数据精简且符合需求。
2026-10-13
6

本文介绍在Django中使用内置Serializers进行数据序列化时,如何通过添加fields选项来精确控制返回的字段。通过对比默认行为与指定字段配置,展示如何排除如username和id等不需要的字段,确保API返回数据精简且符合需求。
本文介绍如何在Python中使用zip函数将二维列表转换为JSON格式。通过zip打包键值对,结合dict与json.dumps实现数据序列化,支持中文输出与缩进排版,适用于数据结构化展示与API接口开发场景。
本文详细介绍Python中处理JSON数据的两种核心方法:解码[[wp:a0]]与编码[[wp:a1]]。通过具体代码示例,展示如何将JSON字符串转换为Python字典对象,以及如何将Python字典序列化为JSON格式字符串,并附带相关在线工具推荐。
本文深入解析Python中JSON字符串与字典对象的区别。JSON作为轻量级数据交换格式,仅支持字符串键和特定值类型;而Python字典基于哈希表实现,提供O(1)读取速度且支持任意可哈希对象作为键。文章详细对比了两者在键值类型、访问方式、默认值处理及布尔值表示上的差异,并解释了哈希表在Python中的工作原理,帮助开发者根据场景选择合适的数据结构。
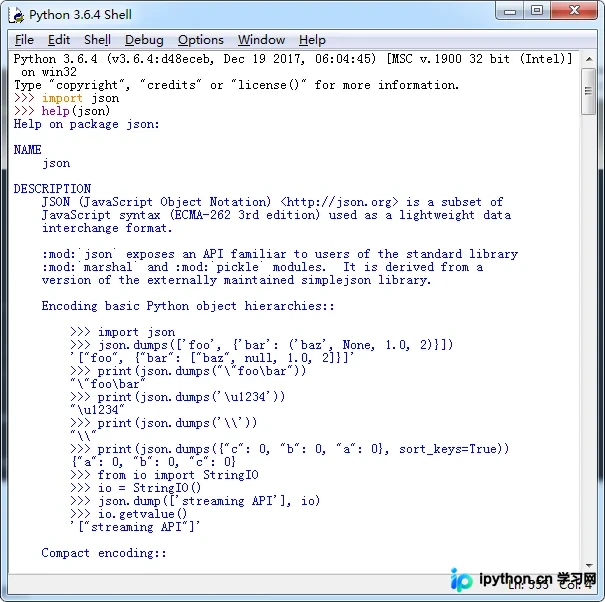
本文详细解析Python中json模块的四个核心函数:dumps、dump、loads和load。dumps将Python对象转为JSON字符串,loads将JSON字符串转为Python对象;dump和load则专门用于文件读写操作。通过代码示例清晰展示内存数据与文件数据的处理差异,帮助开发者正确使用JSON序列化与反序列化功能。
本文详细介绍Python3中pickle模块的使用方法,涵盖dumps、dump、loads、load四个核心功能。解析其支持的数据类型范围,包括原生类型、复合结构及自定义类实例。同时说明各方法的参数要求、协议版本差异,并列举PickleError、PicklingError和UnPicklingError三种异常类型及代码示例。
本文系统梳理Python模块与包的核心概念,深入解析import与from...import的底层执行差异及路径搜索机制。详细讲解如何动态处理跨目录导入,并对比json、pickle、shelve及hashlib等常用标准库的功能特性与使用场景,帮助开发者掌握模块化管理与数据持久化技巧。
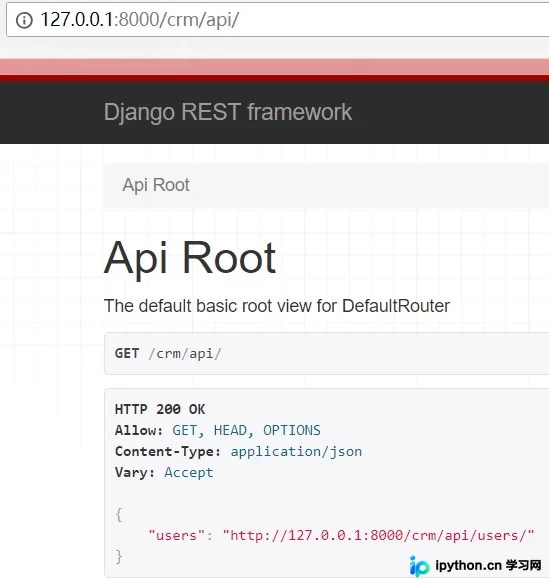
本文详细解析如何利用Django REST Framework构建后端API。内容涵盖从安装依赖、配置权限到创建序列化类、定义视图集及配置URL路由的全流程。通过具体代码示例,展示如何将数据库数据序列化处理并返回给前端,帮助开发者快速掌握Django API的核心开发步骤。
本文深入解析Python中的三种核心数据序列化模块:json、pickle和shelve。详细对比它们的数据支持范围、跨语言兼容性以及文件读写模式差异,重点讲解Python 2与3在编码处理上的不同,并提供dumps/loads与dump/load的具体代码示例,帮助开发者根据场景选择最合适的持久化方案。
本文介绍如何使用Python的kafka-python库实现Kafka消息的JSON格式读写。重点解析生产者KafkaProducer中value_serializer参数的配置,通过json.dumps将字典编码为UTF-8字节流;以及消费者KafkaConsumer中value_deserializer参数的设置,利用json.loads解析消息。示例包含完整的连接配置、数据构造及循环发送逻辑,适用于需要结构化数据传输的场景。
本文详解Python中字典与JSON的核心区别,指出JSON强制双引号而字典灵活,并解析传输时需序列化。重点区分json.dumps/loads处理字符串与json.dump/load操作文件的场景,通过代码示例展示字典转JSON及文件读写的具体实现,帮助开发者正确进行数据序列化与持久化。
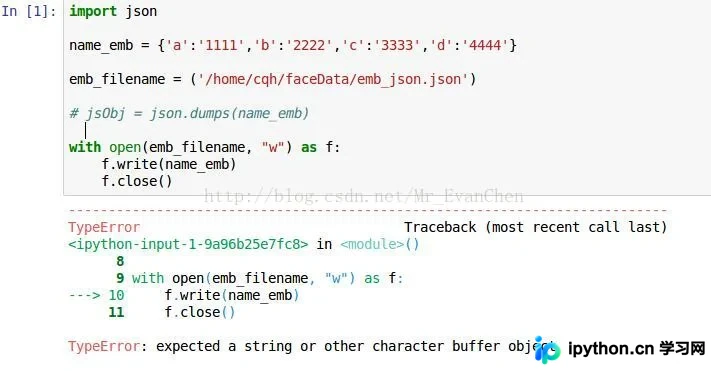
本文详细介绍Python中json模块的四个核心函数:dumps、loads、dump和load。通过具体代码示例,解析如何将字典转换为字符串、将字符串解析为字典,以及如何读写JSON文件。内容涵盖常见报错原因及解决方案,帮助开发者掌握数据序列化与反序列化的正确用法。