

Python数据基础分析与可视化工具使用指南

本文详解如何利用Python完成数据分析核心工作流。通过pandas实现CSV数据导入与字段筛选,借助scipy进行单样本t检验等统计推断,并结合matplotlib与seaborn快速生成盒须图、核密度图与回归图。附带现代语法规范与自定义函数编写技巧,助开发者高效掌握数据探索基础操作。
环境准备与数据加载
数据分析的第一步是获取并识别数据。通常数据以CSV格式存储,需借助pandas库将其加载为DataFrame对象。为保证跨版本兼容,代码已更新为现代Python标准写法:
import pandas as pd

# 读取本地文件
df = pd.read_csv('/Users/al-ahmadgaidasaad/Documents/d.csv')

# 读取网络端CSV资源
data_url = "https://raw.githubusercontent.com/alstat/Analysis-with-Programming/master/2014/Python/Numerical-Descriptions-of-the-Data/data.csv"
df = pd.read_csv(data_url)
第1步:预览结构与提取指定行列
目的:快速检查数据维度、列名及索引,定位并截取特定范围数据用于后续验证。
入口:交互式终端或脚本编辑器。
动作:使用head()与tail()查看首尾记录。Python默认返回5行(区别于R语言的6行)。通过columns和index属性分别提取列名列表与行索引序列。
重要参数:提取子集时推荐使用iloc(按整数位置)或loc(按标签名称),原文中已弃用的.ix会导致警告。
可观察状态:控制台精准输出目标切片,边界无误且无索引越界报错。
# 查看前5行与后5行
print(df.head())
print(df.tail())

# 提取列名与行索引
print(df.columns)
print(df.index)

# 按位置提取第一列前5行
print(df.iloc[:5, 0])

# 提取第11~20行的前3列(等效于按名称提取)
print(df.iloc[10:21, :3])

# 移除中间指定列(例如Apayao与Benguet)
print(df.drop(columns=['Apayao', 'Benguet']).head())
数据转置操作仅需调用T属性即可完成行列互换,便于宽表变长表的初步梳理。
第2步:计算基础统计特征
目的:快速获取数值型变量的分布概貌,辅助判断数据量级与异常值范围。
动作:直接调用describe()方法,系统将自动计算计数、均值、标准差、四分位数及极值。
print(df.describe())
可观察状态:输出表格清晰展示各列的统计摘要,为后续标准化或离群点剔除提供依据。
第3步:执行统计假设检验
目的:验证样本均值是否与预设总体均值存在显著差异。
入口:引入scipy.stats模块。
动作:使用ttest_1samp实现单样本t检验。设定零假设(如总体均值为15000),传入目标列数据即可。
from scipy import stats as ss

# 对单列执行检验
result = ss.ttest_1samp(a=df['Abra'], popmean=15000)
print(result)

# 对全表多列批量检验
print(ss.ttest_1samp(a=df, popmean=15000))
参数说明:返回值包含元组(t_statistic, p_value)。当双侧概率值(p-value)小于显著性水平(通常为0.05)时,拒绝零假设;本例中p值远高于阈值,表明没有充分证据否定预设均值。若输入DataFrame,函数将按列向量化返回两组数组,分别对应t统计量与p值。
第4步:生成高质量数据图表
目的:将抽象统计指标转化为直观图形,提升数据探索效率。
入口:matplotlib.pyplot与seaborn。
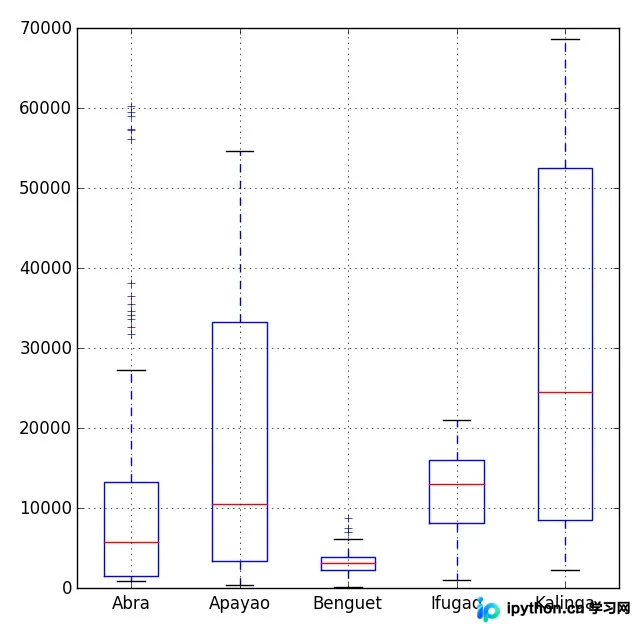
基础盒须图可通过pandas内置接口或matplotlib渲染。早期文档中设置的mpl_style已被移除,现推荐直接使用seaborn的美学引擎:
import matplotlib.pyplot as plt
import seaborn as sns

# 原生主题盒须图
fig, ax = plt.subplots()
ax = df.plot(kind='box', ax=ax)
plt.show()
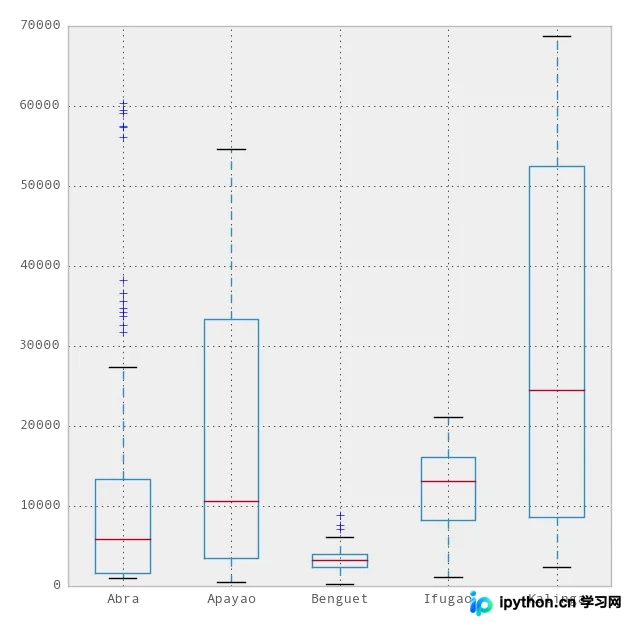
切换至ggplot风格可使背景更清爽,但当前版本更推荐直接使用seaborn高级API:
# 使用seaborn绘制标准盒须图
sns.set_theme()
plt.figure(figsize=(8, 4))
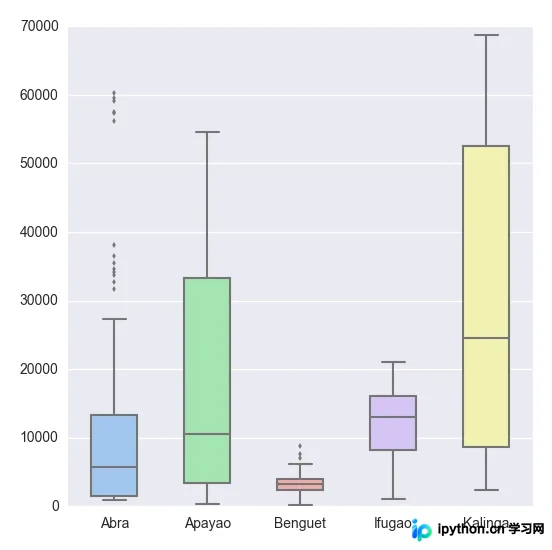
sns.boxplot(data=df, widths=0.5, palette="pastel")
plt.tight_layout()
plt.show()
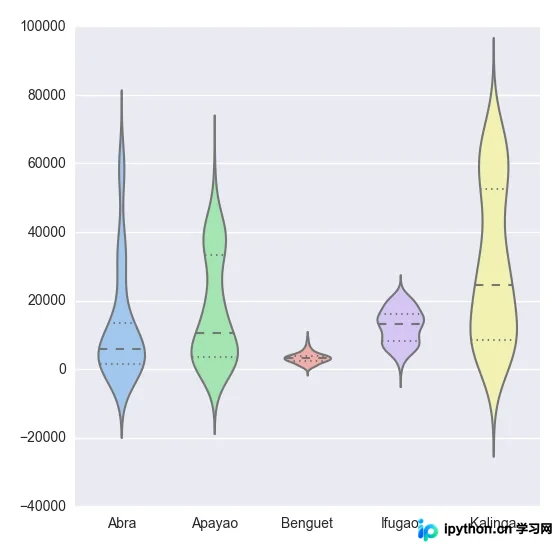
# 小提琴图:展现概率密度分布
plt.figure(figsize=(8, 4))
sns.violinplot(data=df, widths=0.5, palette="pastel")
plt.tight_layout()
plt.show()
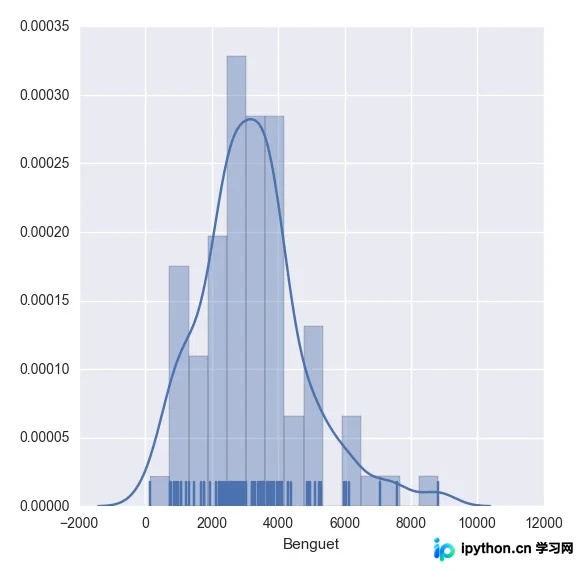
# 分布直方图叠加核密度曲线与 rug 标记
plt.figure(figsize=(7, 4))
sns.set_style("whitegrid")
sns.distplot(df['Benguet'], rug=True, bins=15)
plt.show()
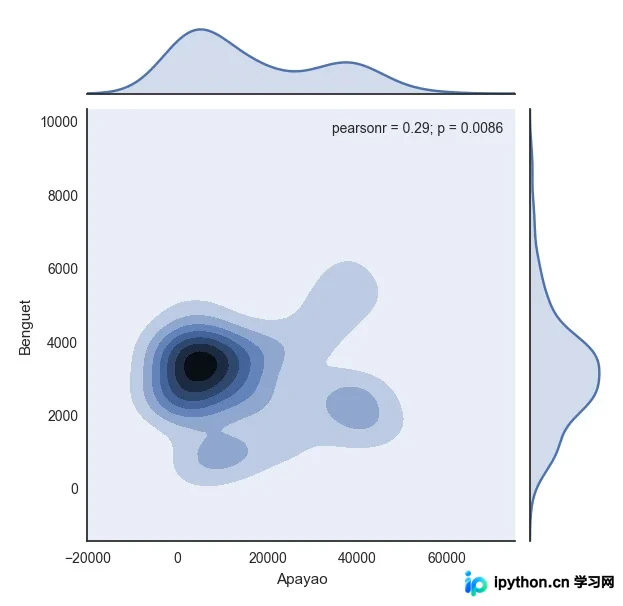
# 双变量联合分布核密度图
with sns.axes_style("white"):
    sns.jointplot(data=df, x=df.columns[1], y=df.columns[2], kind="kde")
    plt.show()
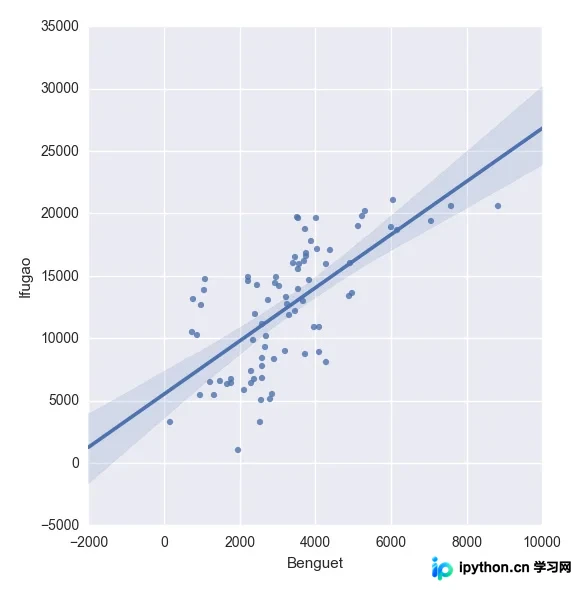
# 线性回归拟合散点图
sns.lmplot(x="Benguet", y="Ifugao", data=df)
plt.show()
第5步:封装自定义分析函数
目的:将重复性统计逻辑模块化,提升代码复用率与执行性能。
动作:使用def关键字定义函数,严格遵循Python缩进规则划分作用域。
import numpy as np
import scipy.stats as ss

def simulate_ci(n=10, mu=3, sigma=np.sqrt(5), p=0.025, rep=100):
    m = np.zeros((rep, 4))
    for i in range(rep):
        norm = np.random.normal(loc=mu, scale=sigma, size=n)
        xbar = np.mean(norm)
        low = xbar - ss.norm.ppf(q=1-p) * (sigma / np.sqrt(n))
        up = xbar + ss.norm.ppf(q=1-p) * (sigma / np.sqrt(n))
        rem = 1 if (mu > low) & (mu < up) else 0
        m[i, :] = [xbar, low, up, rem]

    inside = np.sum(m[:, 3])
    ratio = inside / rep
    desc = f"共有 {inside} 个置信区间包含真实均值 ({mu}),占比 {ratio:.1%}"
    return {"Matrix": m, "Decision": desc}
性能优化:上述循环实现直观但较慢。利用NumPy向量化可大幅提速,无需逐行迭代:
def simulate_ci_fast(n=10, mu=3, sigma=np.sqrt(5), p=0.025, rep=100):
    scaled_crit = ss.norm.ppf(q=1-p) * (sigma / np.sqrt(n))
    # 一次性生成全部随机样本矩阵
    norm = np.random.normal(loc=mu, scale=sigma, size=(rep, n))

    xbar = norm.mean(axis=1)
    low = xbar - scaled_crit
    up = xbar + scaled_crit
    rem = (mu > low) & (mu < up)

    m = np.column_stack([xbar, low, up, rem.astype(int)])
    inside = np.sum(m[:, 3])
    ratio = inside / rep
    desc = f"共有 {inside} 个置信区间包含真实均值 ({mu}),占比 {ratio:.1%}"
    return {"Matrix": m, "Decision": desc}
可观察状态:调用函数后返回字典结构,包含仿真矩阵与结论字符串,便于直接嵌入自动化报告管道。
排错提示与操作完成判断
常见问题排查:
1. 遇到AttributeError: module 'pandas' has no attribute 'read_csv',请确认未将自身脚本命名为pandas.py覆盖官方库。
2. 绘图空白无输出,检查是否在脚本末尾遗漏plt.show(),或在Jupyter环境中未安装matplotlib-inline依赖。
3. 统计检验报维度不匹配,确保传入popmean的标量与数据列长度对齐,或对整表检验时避免混入非数值列。
完成判断:数据成功加载为DataFrame、统计摘要输出完整、假设检验返回有效P值、各类图表窗口正常渲染且函数封装能稳定返回预期字典结构时,即可判定基础数据探索工作流已闭环。
以上就是Python数据分析入门教程:从数据导入、处理到可视化完整指南的详细内容,更多关于Python数据处理实战的数据资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









