

R语言与Python深度对比:数据分析工具选择指南
本文深入对比R语言与Python在数据分析领域的异同。从数据结构、执行速度及功能侧重出发,解析两者在统计分析与通用编程上的优势。同时精选5本权威入门书籍,涵盖实战、金融分析及机器学习,助力开发者根据需求选择合适工具,提升数据科学技能。
2026-10-13
7

本文深入对比R语言与Python在数据分析领域的异同。从数据结构、执行速度及功能侧重出发,解析两者在统计分析与通用编程上的优势。同时精选5本权威入门书籍,涵盖实战、金融分析及机器学习,助力开发者根据需求选择合适工具,提升数据科学技能。
本文深入解析Python中Numpy和Pandas的核心用法。通过对比List、Numpy与Pandas的异同,详细讲解数组创建、向量运算、索引切片及多维数据处理。重点阐述Pandas中Series与DataFrame的结构,涵盖apply函数、axis参数、分组聚合及缺失值处理等关键技能,助力提升数据处理效率。
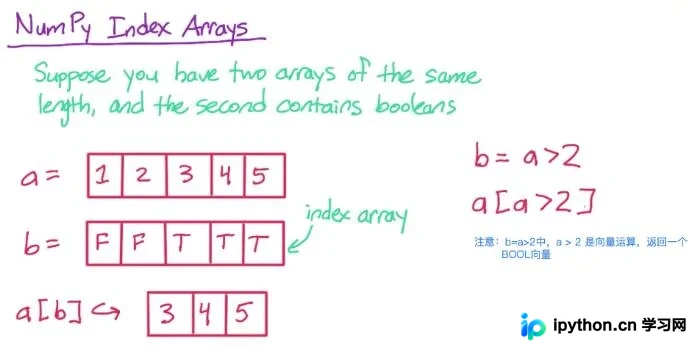
本文详解Python中利用pandas进行数据查询的多种方法。涵盖通过head/tail查看前后数据、利用ix索引选取指定行与列,以及结合布尔索引实现多条件组合查询。重点解析多条件查询中括号与逻辑运算符的正确使用,帮助读者掌握高效的数据子集提取技巧。
本文介绍Python中利用records库将数据库或文本数据导出至Excel文件的实例。作为数据分析师,掌握Python及Linux命令处理复杂数据筛选排序至关重要。records库由Kenneth Reitz开发,支持对接多种关系数据库,并能便捷地将查询结果导出为Excel、CSV、JSON等格式,代码简洁高效。
本文详细介绍如何在Python中使用Pandas库对DataFrame数据进行可视化处理并保存为图片文件。通过获取绘图对象并调用savefig方法,可实现图表的本地存储。同时演示了利用value_counts统计列值分布,并绘制指定标题和尺寸的柱状图,适用于数据分析中的基础图表生成需求。
本文介绍Python中处理非数值类别数据的三种方法:使用LabelEncoder快速转换、通过字典映射手动指定数值,以及利用get_dummies生成虚拟变量。内容涵盖具体代码实现与适用场景,帮助开发者高效完成数据预处理。
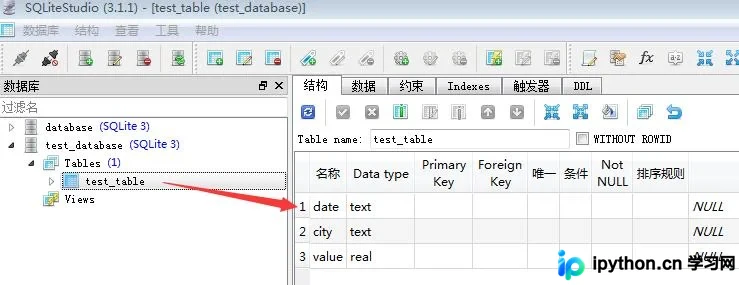
本文详细介绍如何使用Python标准库sqlite3创建和操作SQLite数据库,并通过pandas库高效读取数据。涵盖从建立连接、建表插入数据到使用read_sql_query获取DataFrame的完整流程,解决大数据量处理效率问题,附带可视化工具推荐。
本文介绍如何在本地环境中使用Python高效处理大数据。重点讲解Pandas中Series、DataFrame的初始化、行列增删、数据合并(concat、merge)及分组聚合(GroupBy)操作,并简述NumPy数组基础。涵盖从CSV读取、结构更新到条件过滤的完整流程,适合需要在本地快速处理亿级数据聚合的场景。
本文详细解析在Linux CentOS 7环境下使用Python 2.7及Matplotlib绘制图表时中文显示为方框的问题。通过获取matplotlibrc路径、安装系统字体、修改配置文件及清除缓存等步骤,提供了一套完整的修复方案,确保横坐标等中文标签正常显示。
本文详细解析 SQL Server T-SQL 的高级查询技巧,涵盖基础聚合、嵌套子查询(IN/EXISTS)、集合运算(UNION/INTERSECT)及公用表表达式(CTE)。重点讲解 ROW_NUMBER、RANK 等排序函数在不同场景下的应用,并系统梳理日期、字符串、安全及自定义函数的编写方法,助力高效数据处理。
本文针对Python数据分析常用扩展包(numpy、scipy、pandas、matplotlib)安装过程中遇到的依赖冲突与版本兼容问题,提供详细解决方案。通过介绍非官方预编译库资源站的使用方法及正确的pip安装顺序,帮助开发者解决在Python 2.7环境下因全局解释器锁或平台架构导致的安装报错,确保数据分析环境顺利搭建。
本文介绍如何利用Python的re库进行简单的字符串匹配。通过构建正则表达式模式并编译为对象,调用其方法即可获取匹配结果。文章结合具体代码示例,展示了从导入模块到打印匹配内容的完整流程,适合数据分析与算法工作者参考。