

Python数据分析基础:Numpy与Pandas核心用法详解

本文深入解析Python中Numpy和Pandas的核心用法。通过对比List、Numpy与Pandas的异同,详细讲解数组创建、向量运算、索引切片及多维数据处理。重点阐述Pandas中Series与DataFrame的结构,涵盖apply函数、axis参数、分组聚合及缺失值处理等关键技能,助力提升数据处理效率。
前言
本文旨在详细介绍Python中Numpy和Pandas的实际应用,分享相关经验供读者参考学习。接下来将展开具体内容的介绍。
它们是什么?
NumPy是Python语言的一个扩展程序库。它支持高级且大量的维度数组与矩阵运算,同时提供了丰富的数学函数库以处理数组运算。
Pandas是基于NumPy构建的一种工具,专为解决数据分析任务而设计。Pandas引入了大量库和标准数据模型,提供了高效操作大型数据集所需的工具,并提供了大量快速便捷处理数据的函数和方法。
List、Numpy与Pandas
Numpy与List
相同之处:
- 两者均支持通过下标访问元素,例如a[0]
- 两者均支持切片访问,例如a[1:3]
- 两者均可使用for循环进行遍历
不同之处:
- Numpy中每个元素类型必须相同;而List中可以混合多种类型的元素
- Numpy使用更为便捷,封装了许多函数,例如mean、std、sum、min、max等
- Numpy支持多维数组
- Numpy由C语言实现,操作速度更快
Pandas与Numpy
相同之处:
- 访问元素方式一致,既可使用下标,也可使用切片访问
- 均可使用For循环进行遍历
- 均提供许多便捷函数,例如mean、std、sum、min、max等
- 均支持向量运算
- 均由C实现,运行速度更快
不同之处:Pandas拥有Numpy中不具备的方法,例如describe函数。主要区别在于:Numpy类似于增强版的List,而Pandas则像是列表和字典的结合体,Pandas具备索引功能。
Numpy使用
1、基本操作
import numpy as np
#创建Numpy
p1 = np.array([1, 2, 3])
print p1
print p1.dtype
[1 2 3]
int64
#求平均值
print p1.mean()
2.0
#求标准差
print p1.std()
0.816496580928
#求和、求最大值、求最小值
print p1.sum()
print p1.max()
print p1.min()
6
3
1
#求最大值所在位置
print p1.argmax()
2
2、向量运算
p1 = np.array([1, 2, 3])
p2 = np.array([2, 5, 7])
#向量相加,各个元素相加
print p1 + p2
[ 3 7 10]
#向量乘以1个常数
print p1 * 2
[2 4 6]
#向量相减
print p1 - p2
[-1 -3 -4]
#向量相乘,各个元素之间做运算
print p1 * p2
[ 2 10 21]
#向量与一个常数比较
print p1 > 2
[False False True]
3、索引数组
首先,参考下图以理解相关概念
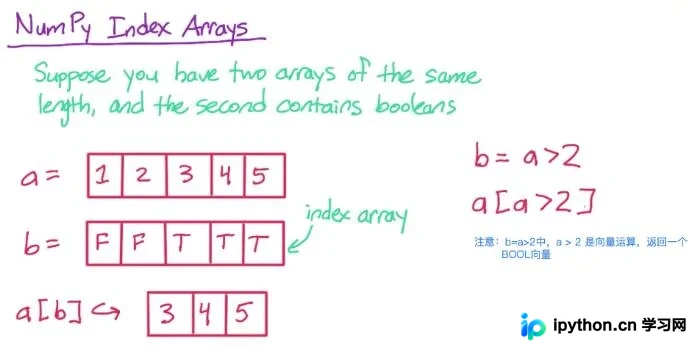
接下来,通过代码实现进行演示
a = np.array([1, 2, 3, 4, 5])
print a
[1 2 3 4 5]
b = a > 2
print b
[False False True True True]
print a[b]
[3 4 5]
在a[b]操作中,仅保留a中对应b位置为True的元素
4、原地与非原地
我们先观察一组运算结果:
a = np.array([1, 2, 3, 4])
b = a
a += np.array([1, 1, 1, 1])
print b
[2 3 4 5]
a = np.array([1, 2, 3, 4])
b = a
a = a + np.array([1, 1, 1, 1])
print b
[1 2 3 4]
从上述结果可以看出,+=改变了原数组,而+没有。原因在于:
- +=:属于原地计算,不创建新数组,直接在原始数组中修改元素
- +:属于非原地计算,会创建新数组,不修改原始数组中的元素
5、Numpy中的切片与List的切片
l1 = [1, 2, 3, 5]
l2 = l1[0:2]
l2[0] = 5
print l2
print l1
[5, 2]
[1, 2, 3, 5]
p1 = np.array([1, 2, 3, 5])
p2 = p1[0:2]
p2[0] = 5
print p1
print p2
[5 2 3 5]
[5 2]
由上可知,在List中修改切片内的元素不会影响原数组;而在Numpy中修改切片内的元素,原数组也会随之改变。这是因为:Numpy的切片机制不创建新数组,修改切片即修改原始数组数据。这种机制使Numpy比原生数组操作更快,但编程时需注意此特性。
6、二维数组的操作
p1 = np.array([[1, 2, 3], [7, 8, 9], [2, 4, 5]])
#获取其中一维数组
print p1[0]
[1 2 3]
#获取其中一个元素,注意它可以是p1[0, 1],也可以p1[0][1]
print p1[0, 1]
print p1[0][1]
2
2
#求和是求所有元素的和
print p1.sum()
41
[10 14 17]
当设置axis参数时,若设置为0,则计算每一列的结果,返回一个一维数组;若设置为1,则计算每一行的结果,同样返回一维数组。对于二维数组,Numpy中许多函数均可设置axis参数。
#获取每一列的结果
print p1.sum(axis=0)
[10 14 17]
#获取每一行的结果
print p1.sum(axis=1)
[ 6 24 11]
#mean函数也可以设置axis
print p1.mean(axis=0)
[ 3.33333333 4.66666667 5.66666667]
Pandas使用
Pandas包含两种结构,分别是Series和DataFrame。其中Series拥有Numpy的所有功能,可视为简单的一维数组;而DataFrame是将多个Series按列合并而成的二维数据结构,每一列单独取出即为一个Series。
我们主要梳理Numpy中不具备的功能:
1、简单基本使用
import pandas as pd
pd1 = pd.Series([1, 2, 3])
print pd1
0 1
1 2
2 3
dtype: int64
#也可以求和和标准偏差
print pd1.sum()
print pd1.std()
6
1.0
2、索引
(1)Series中的索引
p1 = pd.Series(
 [1, 2, 3],
 index = ['a', 'b', 'c']
)
print p1
a 1
b 2
c 3
dtype: int64
print p1['a']
(2)DataFrame数组
p1 = pd.DataFrame({
 'name': ['Jack', 'Lucy', 'Coke'],
 'age': [18, 19, 21]
})
print p1
 age name
0 18 Jack
1 19 Lucy
2 21 Coke
#获取name一列
print p1['name']
0 Jack
1 Lucy
2 Coke
Name: name, dtype: object
#获取姓名的第一个
print p1['name'][0]
Jack
#使用p1[0]不能获取第一行,但是可以使用iloc
print p1.iloc[0]
age 18
name Jack
Name: 0, dtype: object
总结:
- 获取一列使用p1[‘name']这种索引方式
- 获取一行使用p1.iloc[0]
3、apply使用
apply可用于操作Pandas中的元素,当库内没有对应方法时,可通过apply进行封装
def func(value):
 return value * 3
pd1 = pd.Series([1, 2, 5])
print pd1.apply(func)
0  3
1  6
2 15
dtype: int64
同样可以在DataFrame上使用:
pd2 = pd.DataFrame({
 'name': ['Jack', 'Lucy', 'Coke'],
 'age': [18, 19, 21]
})
print pd2.apply(func)
 age   name
0 54 JackJackJack
1 57 LucyLucyLucy
2 63 CokeCokeCoke
4、axis参数
Pandas设置axis时,与Numpy略有区别:
- 当设置axis为'columns'时,是计算每一行的值
- 当设置axis为'index'时,是计算每一列的值
pd2 = pd.DataFrame({
 'weight': [120, 130, 150],
 'age': [18, 19, 21]
})
0 138
1 149
2 171
dtype: int64
#计算每一行的值
print pd2.sum(axis='columns')
0 138
1 149
2 171
dtype: int64
#计算每一列的值
print pd2.sum(axis='index')
age  58
weight 400
dtype: int64
5、分组
pd2 = pd.DataFrame({
 'name': ['Jack', 'Lucy', 'Coke', 'Pol', 'Tude'],
 'age': [18, 19, 21, 21, 19]
})
#以年龄分组
print pd2.groupby('age').groups
{18: Int64Index([0], dtype='int64'), 19: Int64Index([1, 4], dtype='int64'), 21: Int64Index([2, 3], dtype='int64')}
6、向量运算
需要注意的是,索引数组相加时,对应的索引会进行相加
pd1 = pd.Series(
 [1, 2, 3],
 index = ['a', 'b', 'c']
)
pd2 = pd.Series(
 [1, 2, 3],
 index = ['a', 'c', 'd']
)
print pd1 + pd2
a 2.0
b NaN
c 5.0
d NaN
dtype: float64
若出现NAN值,且期望NAN不出现,如何处理?使用add函数,并设置fill_value参数
print pd1.add(pd2, fill_value=0)
a 2.0
b 2.0
c 5.0
d 3.0
dtype: float64
同样,它可应用于Pandas的dataFrame中,但需注意列与行都要对应起来。
总结
本周学习了优达学城上分析基础的课程,使用的是Numpy与Pandas。对于Numpy,以前在Tensorflow中用过,但理解不深,此次学习后才发现其简单之处,算是有了一定收获。
好了,以上就是这篇文章的全部内容,希望本文的内容对大家的学习或者工作具有一定的参考学习价值。如果有疑问大家可以留言交流,谢谢大家对本站的支持。
参考
Pandas 使用指南(上) 基本数据结构
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









