

Python实现Excel和CSV中VLOOKUP功能:从数据清洗到合并的完整指南
本文详解如何利用Python的Pandas库在Excel和CSV文件中实现类似VLOOKUP的数据关联功能。内容涵盖删除指定行、获取最大行数、上下拼接表格以及使用merge函数进行左连接合并。通过具体代码示例,展示如何高效处理三国人物数据,解决大数据量下的性能问题,并提供从数据清洗到最终合并的完整操作流程。
2026-10-12
6

本文详解如何利用Python的Pandas库在Excel和CSV文件中实现类似VLOOKUP的数据关联功能。内容涵盖删除指定行、获取最大行数、上下拼接表格以及使用merge函数进行左连接合并。通过具体代码示例,展示如何高效处理三国人物数据,解决大数据量下的性能问题,并提供从数据清洗到最终合并的完整操作流程。
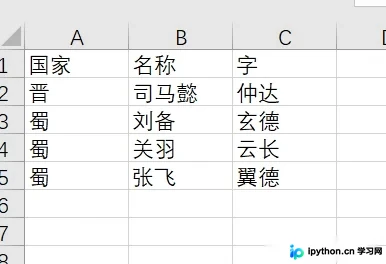
本文系统梳理Pandas在数据分析中的核心应用,涵盖数据导入导出、重复值与缺失值处理、字符串清洗、数据筛选与抽样、多表合并、时间序列解析及标准化等关键步骤。通过具体代码示例,帮助开发者快速掌握高效处理表格型数据的方法,提升数据预处理效率。
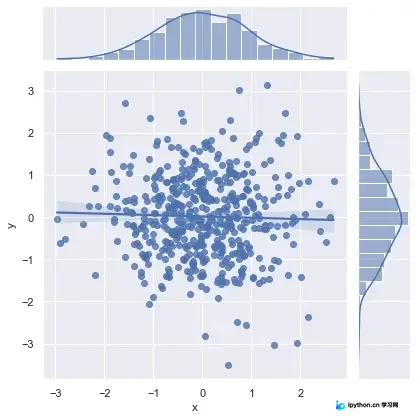
本文详解Seaborn库中jointplot函数在双变量联合分布可视化中的应用。通过设置kind参数,可生成散点图、回归拟合图、残差图、核密度图及蜂巢图。重点解析各图表类型的适用场景、参数配置及图形解读方法,帮助开发者快速掌握连续数值型数据的关联分析与分布特征展示技巧。
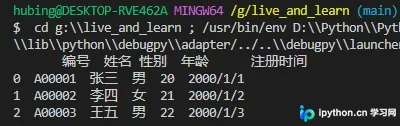
本文介绍如何使用Python的pandas库导入CSV文件。涵盖默认导入、指定分隔符(sep)、限制读取行数(nrows)以及处理编码格式(encoding)等关键参数。同时提供解决中文列标题对齐问题的set_option方法,帮助开发者高效处理不同格式的CSV数据。
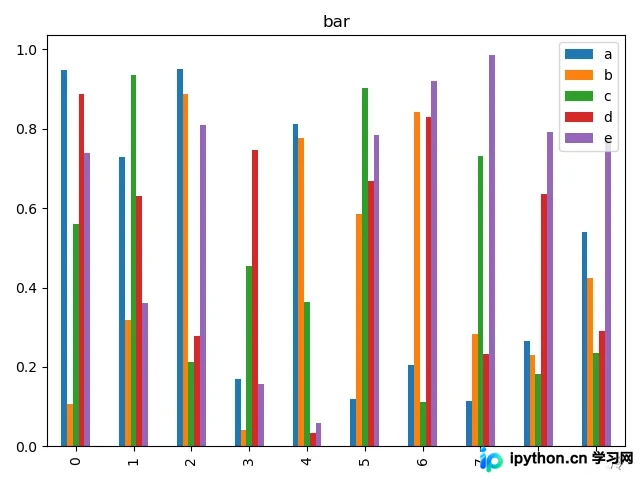
本文深入解析Pandas内置的多种数据可视化函数,涵盖条形图、折线图、面积图、箱线图、直方图、饼图及散点图等核心类型。通过具体代码示例,展示如何调用line、bar、box、hist等接口,并详解透明度、子图布局及六边形分箱等高级参数的应用,帮助开发者高效实现数据分布特征的直观呈现。
本文详细介绍如何利用Python的pandas库读取Excel文件中的多表单数据,包括按行、列或指定范围提取数据,并将数据转换为字典格式。同时,结合matplotlib库演示如何绘制简单的折线图与散点图,涵盖坐标轴设置、颜色映射、轮廓控制及自动保存图表等关键参数配置,帮助开发者快速实现数据可视化。
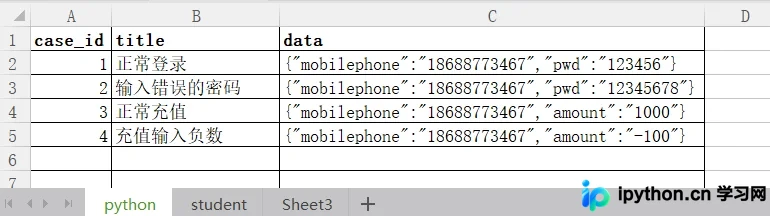
本文详解Python中pandas库的pivot_table函数,通过index、values、columns及aggfunc四大核心参数,演示如何对Excel数据进行动态分组、汇总与计算。涵盖均值、求和等多种统计方式,帮助开发者高效完成数据清洗与分析任务。
本文介绍如何利用Python pandas库的groupby函数,结合apply和lambda表达式,从分组数据中筛选出每组最大值与最小值所在的行。通过具体代码示例,演示如何处理多级索引并导出结果至Excel,解决直接使用groupby无法直接获取极值行的问题。
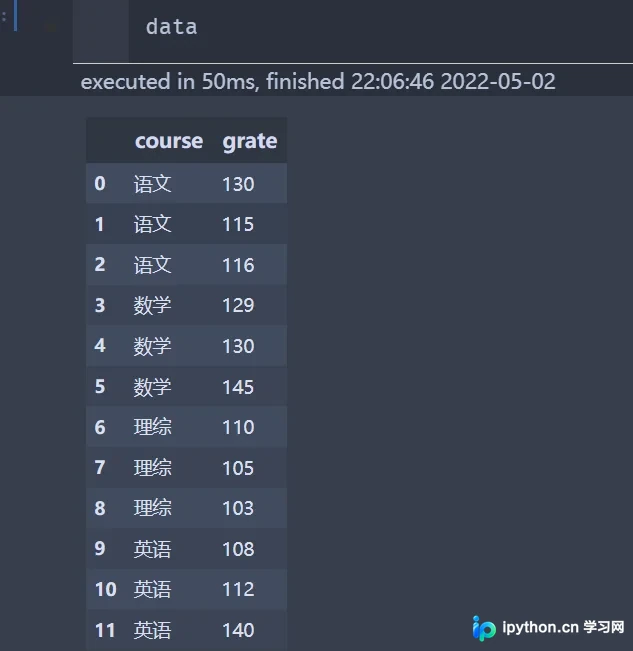
本文详细介绍Pandas库中df.fillna()函数的使用方法,涵盖固定值填充、前后向填充(ffill/bfill)及基于统计量的填充策略。通过具体代码示例解析value、method、inplace等关键参数的应用,并对比df.replace()替代方案,帮助开发者高效处理数据中的缺失值。
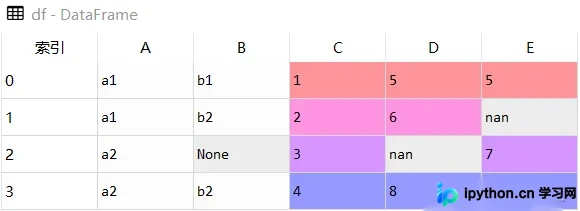
本文介绍Pandas中df.shape属性的使用方法,用于获取Dataframe的行数和列数。df.shape返回一个元组,第一个元素为行数,第二个为列数。通过示例代码展示如何提取具体行列数值,并说明Series对象的shape特性。
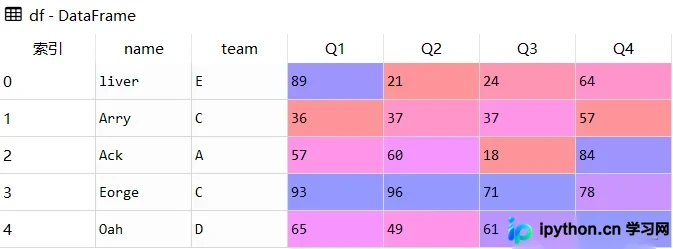
本文详解如何使用Python实现邮件自动下载功能。通过对比SMTP、POP3和IMAP协议,重点讲解基于IMAP协议的邮件登录与解析。代码示例展示了如何提取邮件主题、下载附件至指定路径,并解析HTML正文保存为文本文件,同时提及利用Pandas处理表格附件,提供完整的类封装与运行逻辑。
本文详解pandas中处理重复数据的两个核心方法:duplicated()与drop_duplicates()。通过DataFrame、Series及Index三种对象的示例,解析subset与keep参数的具体行为,并演示如何根据品牌或全部列识别重复项,以及如何直接删除重复数据以完成数据清洗。