

Pandas Series 与 Numpy Array 的核心共性解析
本文深入探讨Pandas Series与Numpy Array在功能实现上的高度一致性。两者均支持通过中括号进行元素索引与切片操作,具备相同的遍历语法,并内置求最大最小值等统计函数。此外,Series支持向量运算,且底层基于C语言实现,运算效率显著优于原生Python列表。
2026-10-13
6

本文深入探讨Pandas Series与Numpy Array在功能实现上的高度一致性。两者均支持通过中括号进行元素索引与切片操作,具备相同的遍历语法,并内置求最大最小值等统计函数。此外,Series支持向量运算,且底层基于C语言实现,运算效率显著优于原生Python列表。
本文深入解析Pandas中Series和DataFrame的索引机制,涵盖基于下标与关键字的索引方式、整数索引的特殊处理、布尔Series过滤及Index对象应用。重点对比loc与iloc的行为差异,通过代码示例展示列索引、行切片及布尔筛选的具体操作,帮助开发者掌握高效的数据访问技巧。
本文总结了Python自动化测试中处理Excel文件的三种常用方法:openpyxl、xlrd及pandas。文章详细对比了各库的安装方式、读写特性及局限性,重点提供了针对多Sheet操作Bug修复的openpyxl封装代码,以及xlrd配合xlutils处理.xls文件的读写方案,并简要展示了pandas在数据读取中的应用,旨在为测试人员提供可直接复用的工具类代码。
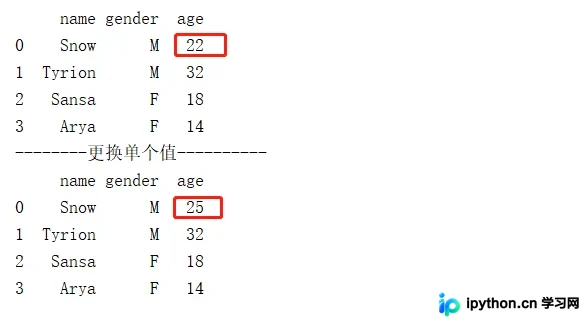
本文介绍如何使用Pandas库修改DataFrame中的特定值,包括使用loc、iloc、at和iat方法。同时详细讲解如何在DataFrame末尾或指定位置新增列,以及如何通过append方法添加新行,提供完整代码示例和注意事项。
本文详细介绍如何利用Python的Pandas库实现类似Excel的强大排序功能。通过df.sort_values()方法,演示如何对单列或多列数据进行升序或降序排列,并深入讲解当存在相同值时如何处理索引排序,以及如何通过列表参数实现不同列混合排序(如身高降序、武力升序)。
本文详细介绍如何使用 Python Pandas 将数据写入 Excel 文件。涵盖两种核心场景:使用 to_excel() 直接保存单个 DataFrame,以及利用 ExcelWriter 配合循环将多个数据写入同一工作簿的不同 Sheet。同时提供 xlrd、xlwt 和 openpyxl 库的安装建议,解决常见依赖问题。
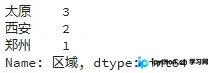
本文详解pandas库中value_counts()函数的使用方法。涵盖Series单个列的频次统计、默认降序与升序排列、normalize参数计算占比,以及DataFrame多列批量统计。重点解析ascending和normalize参数的具体应用及空值处理机制,帮助开发者高效进行数据分布分析。
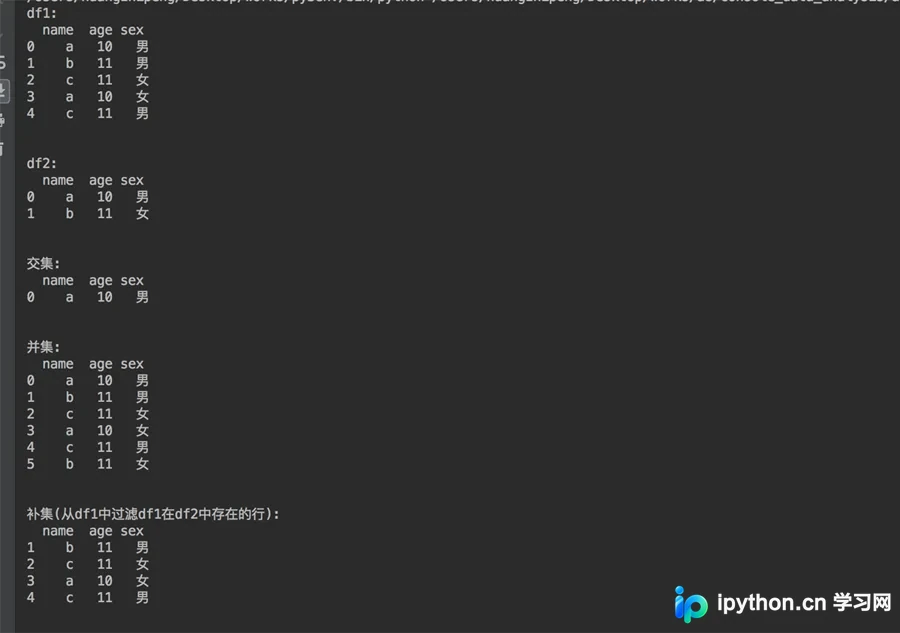
本文介绍在 columns 相同的 DataFrame 中进行集合运算的方法。利用 pd.merge 配合 on 参数可获取交集,设置 how='outer' 获取并集。对于补集(从 df1 中剔除 df2 存在的行),通过 append 合并后使用 drop_duplicates 保留唯一值实现。
本文详细介绍Python数据分析库Pandas的核心数据结构,包括Series、DataFrame和Panel的定义与区别,重点讲解DataFrame作为二维表格型数据容器的应用。同时提供Pandas的安装命令及模块导入的标准写法,帮助开发者快速上手处理金融时间序列及多维数据集。
本文通过UCI循环发电厂数据集,演示如何使用pandas读取数据,并利用scikit-learn进行线性回归建模。内容涵盖数据预处理、特征选择、训练集与测试集划分、模型拟合、系数获取,以及通过MSE和RMSE评估模型性能,最后结合交叉验证与可视化分析优化模型效果。
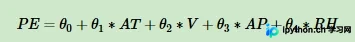
本文详细介绍Python中pandas库创建DataFrame的多种方法,包括从字典和列表构建数据框、指定列名与顺序、修改列名以及生成随机整数数据。同时演示如何使用时间序列作为索引,并简要提及类SQL操作功能,帮助开发者快速掌握DataFrame的基础构建技巧。
本文系统讲解pandas中DataFrame数据选取的三种层次:行列、区域及单元格。详细解析df[]、df.loc[]、df.iloc[]、df.ix[]、df.at[]及df.iat[]的语法特性与适用场景,通过代码示例展示整数切片、标签索引、布尔数组及Callable对象的使用差异,帮助开发者精准掌握数据定位技巧。