Python pandas外部数据导入与常用处理方法详解
本文详细介绍Python中pandas库如何高效导入Excel、CSV及SQL数据库文件,涵盖read_excel、read_csv及read_sql等核心函数的参数配置。同时系统讲解shape、info、astype、isnull、dropna、fillna、drop_duplicates等常用数据清洗与处理方法,帮助开发者快速掌握数据预处理技巧。
2026-10-13
6

本文详细介绍Python中pandas库如何高效导入Excel、CSV及SQL数据库文件,涵盖read_excel、read_csv及read_sql等核心函数的参数配置。同时系统讲解shape、info、astype、isnull、dropna、fillna、drop_duplicates等常用数据清洗与处理方法,帮助开发者快速掌握数据预处理技巧。
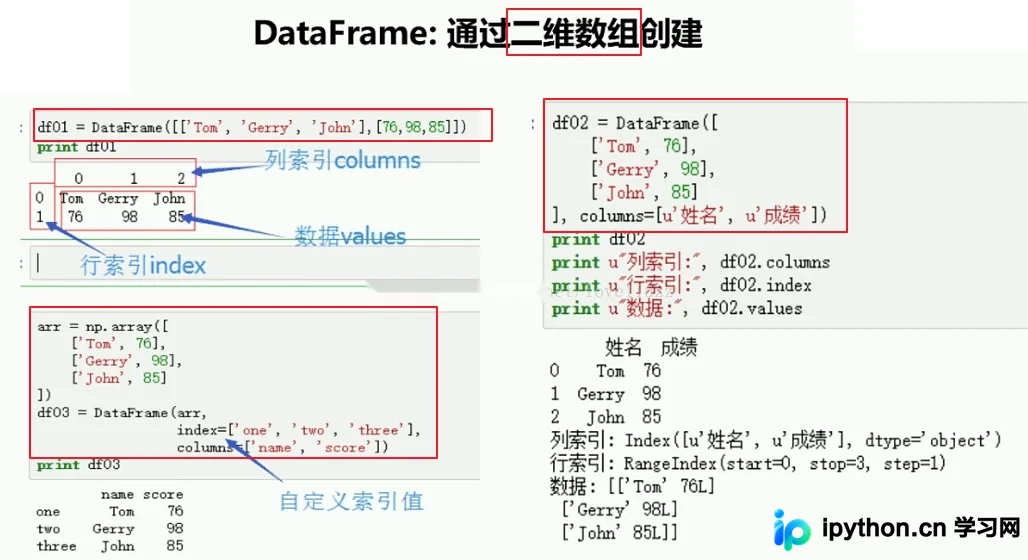
本文详细介绍Python3.5中Pandas模块DataFrame的用法。涵盖通过二维数组和字典创建DataFrame的方法,演示如何获取单列、单行数据,以及如何修改数据值。此外,还讲解了从CSV文件读取数据、更改列索引、筛选特定行列以及删除NaN值行的基本功能,适合Python初学者参考。
本文详细介绍Python3.5中Pandas模块Series的核心用法。涵盖通过numpy数组、字典及直接赋值创建Series的方法,演示索引与数据类型的自定义设置。深入解析Series值的获取、算术运算、缺失值检测(isnull/notnull)以及基于索引的自动对齐机制,并提供完整代码示例与运行结果分析,帮助开发者掌握Series数据结构的基础操作。
本文介绍10个Python中pandas库的高效使用技巧,涵盖数据读取、类型选择、深拷贝、映射转换、apply性能优化、值计数、缺失值处理、ID筛选、分箱及CSV导出等核心场景,帮助开发者提升数据处理效率。
本文详细介绍如何在Python中结合使用pandas和xlsxwriter库来处理.xlsx文件。通过pandas实现读取指定行数、特定行列数据、获取行列索引及将数据转换为字典;利用xlsxwriter创建新工作簿、写入单元格、行和列数据。涵盖从读取现有Excel到生成新Excel的完整操作流程,适用于需要自动化处理Excel数据场景的开发人员。
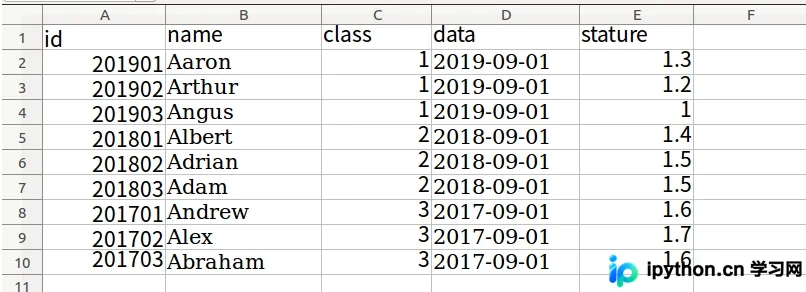
本文详解在pandas DataFrame中如何高效筛选和删除指定行。通过isin()方法传入列表或字典可实现精确匹配,同时介绍针对包含特定字符串行的处理技巧,帮助开发者快速完成数据清洗与过滤操作。
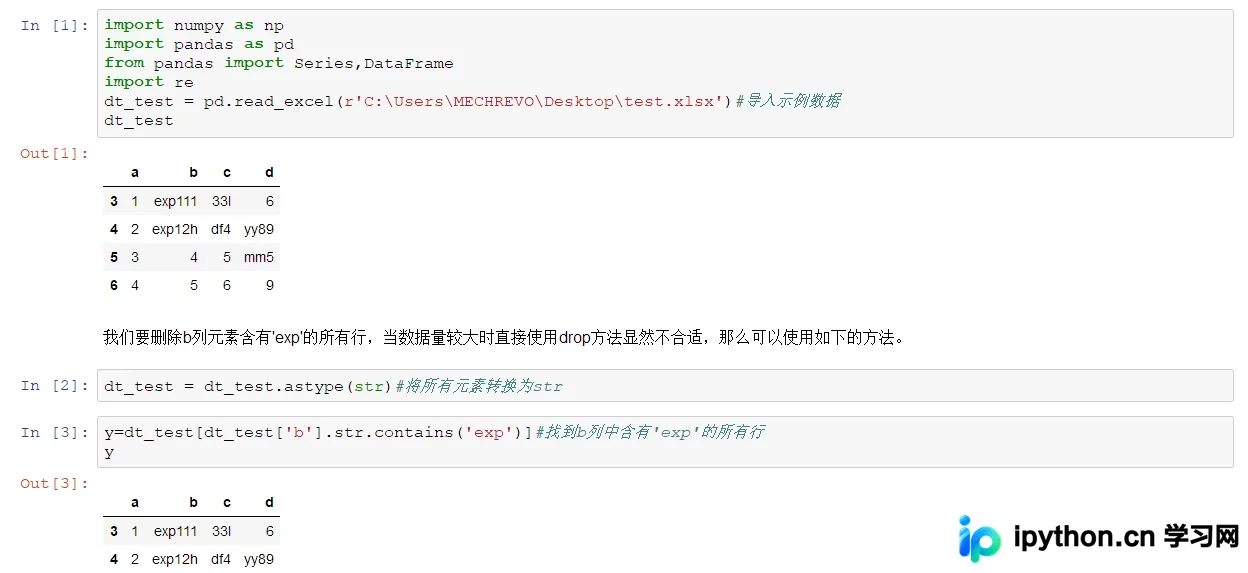
本文介绍在pandas中如何高效删除DataFrame中包含特定字符串的行。通过示例演示利用str.contains()结合逻辑取反或query()方法,快速筛选并剔除含有固定字符的数据行,适用于数据预处理与清洗场景。
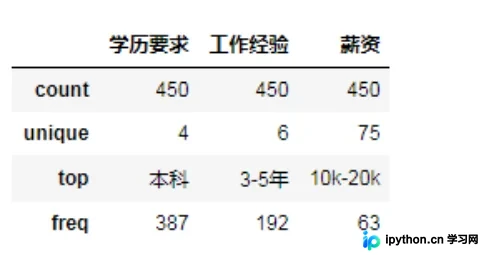
本文详细介绍利用Python3对拉勾网招聘数据进行可视化分析的全过程。从数据清洗、薪资区间预处理到使用jieba进行中文分词,最终通过环状图、柱状图及词云图展示学历、经验与职位要求的分布特征,为数据分析师岗位提供直观的数据洞察。
本文介绍如何使用Python的Pandas库从数据集中提取特定时间段内的记录。通过示例展示了将字符串时间转换为datetime类型,并利用布尔索引进行范围过滤的具体步骤。文章包含完整的代码实现及输出结果分析,适用于需要处理时间序列数据的场景。
本文详细介绍了Python Pandas库中Series和DataFrame的排序操作。通过具体代码实例,演示了如何利用sort_index方法对Series按索引或值进行排序,以及对DataFrame按行索引、列索引及指定列值进行多条件排序,帮助开发者掌握数据预处理中的关键排序技巧。
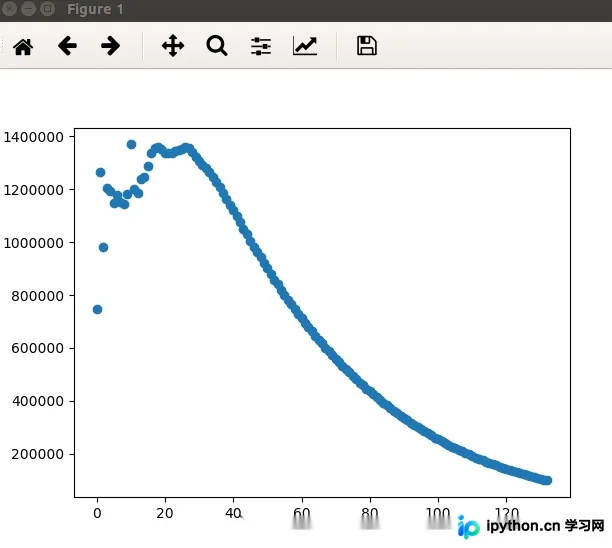
本文详细介绍如何使用 Python 的 matplotlib 库中的 scatter 方法绘制散点图。内容涵盖从最简单的数据可视化到基于多特征数据集的高级图表绘制,包括颜色、大小、标记形状等关键参数的配置,并深入解析 scatter 函数的签名与具体参数含义,帮助读者掌握数据可视化技巧。
本文探讨 Python 作为热门编程语言的多种变现途径。内容涵盖教育培训、网络爬虫数据采集、大数据分析处理、Web 网页开发以及跨语言软件集成开发等六大核心领域。旨在为学习者提供清晰的职业规划参考,解析不同技术方向的实际应用价值与市场需求。