

Python Pandas处理缺失值NaN:检测、删除与填充详解
本文详解Python Pandas中缺失值NaN的处理方法。涵盖使用isnull()检测空值,通过dropna()按条件删除含缺失值的行或列,以及利用fillna()进行统一值、字典映射、统计量或前后向填充。包含具体代码示例与参数说明,帮助高效清洗数据。
2026-10-12
6

本文详解Python Pandas中缺失值NaN的处理方法。涵盖使用isnull()检测空值,通过dropna()按条件删除含缺失值的行或列,以及利用fillna()进行统一值、字典映射、统计量或前后向填充。包含具体代码示例与参数说明,帮助高效清洗数据。
本文系统介绍Python中Numpy库的核心功能,涵盖数组基础属性查询、多维数组创建与数学运算、axis轴参数理解以及线性代数计算。通过具体代码示例,解析如何高效处理数据初始化、矩阵变换及方程求解,为数据分析提供基础工具支持。
本文基于Python的Pandas库,对北京2006至2019年高考录取分数线进行统计分析。通过数据爬取与本地文件读取,利用groupby、max、min及mean等方法,计算文理科最高最低分、一本与二本分数线差值及历年平均分。结合Matplotlib进行可视化展示,为考生填报志愿提供数据支持。
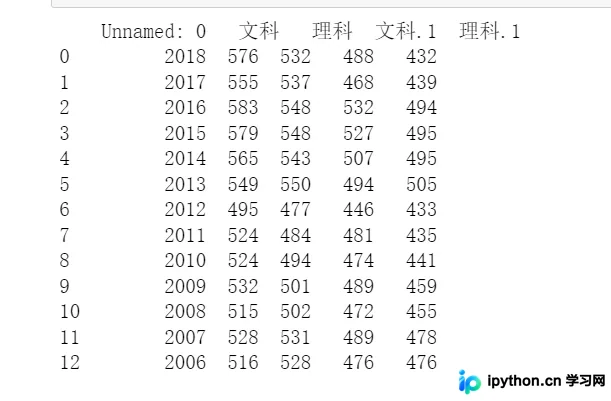
本文详细说明如何使用 Python 的 matplotlib 库绘制分组堆叠条形图。通过加载 Excel 数据,结合多次调用 plt.bar() 并配置 bottom 偏移量与柱体间距,实现多组数据的对比展示。附带完整代码、关键参数说明及图表导出方法,解决常规教程仅展示单组堆叠的不足。
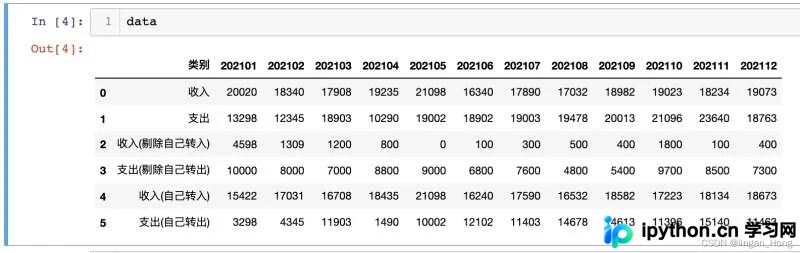
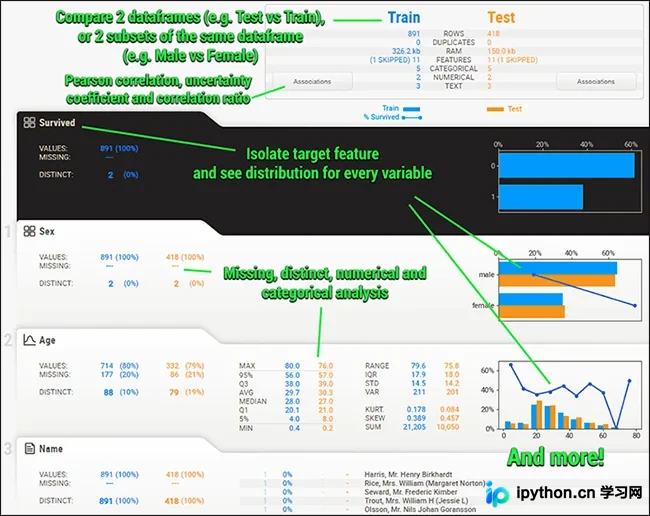
Sweetviz 是 Python 中用于快速生成高精度可视化报告的开源库。通过简单的三行代码,即可对 Pandas DataFrame 进行自动检测、分析与对比,生成包含众数、极值及相关性分析的 HTML 报告。本文详解 analyze、compare 及 compare_intra 函数的用法,并介绍 show_html 与 show_notebook 的参数配置,帮助开发者高效完成探索性数据分析。
本文介绍使用Python编写的一个身份证信息校验小项目。通过读取Excel区域代码文件,利用Pandas库解析18位身份证中的地区、出生日期及性别信息。重点详解了基于ISO 7064:1983.MOD 11-2标准的校验码算法,包括权值计算、取余映射及真伪判断逻辑,提供完整可运行代码供学习参考。
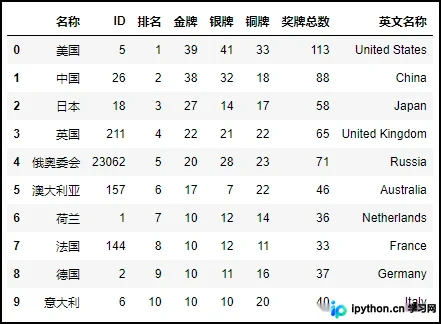
本文详解如何利用Python库Pyecharts制作可视化大屏。内容涵盖使用requests和pandas获取并清洗2020东京奥运会数据,通过Map、Bar、Pie绘制各类图表,并利用Page组件结合chart_config.json实现拖拽式自定义布局,最终生成静态HTML大屏文件。
本文详细讲解在Python中如何为数据添加标签、根据条件判断标签值以及从HTML结构中获取特定标签内容。通过Pandas的merge与apply方法实现复杂逻辑打标,并结合lxml库利用XPath表达式精准提取网页元素属性,适用于数据分析和网络爬虫场景。
本文深入解析 pandas DataFrame 赋值时的 Index 对齐机制,解释为何 Index 不匹配会导致 NaN。通过对比三种 Index 场景,阐明 df[condition] 赋值的潜在风险,并给出使用 loc 和 iloc 进行安全、规范赋值的最佳实践。
在使用pandas进行数据聚类时,单特征与双特征聚类对列类型的影响不同,可能导致后续merge操作报类型错误。本文分析了该现象的原因,并提供了一个基于阈值的数据聚类实现方案,帮助处理按数值大小归类数据集的需求。
本文详细介绍 Python Pandas 库中 DataFrame 的核心操作方法。涵盖基础属性获取(如 index、shape)、数据访问(loc、iloc)、多行多列切片、条件筛选、列的新增与删除,以及数据修改。通过具体代码示例,帮助开发者快速掌握 DataFrame 的高效数据处理技巧。
本文介绍在pandas中如何调整DataFrame的列顺序、添加新列以及修改列名。通过直接指定列名列表实现重排,利用直接赋值或assign方法添加单列或多列,并使用rename接口修改列名。