

Python程序打包exe报错的几种解决方法
将Python脚本打包为exe时,常因环境版本不匹配、路径含特殊字符或依赖库方法弃用导致报错。本文介绍从版本校验、路径清理到日志分析与代码修正的标准排查流程,帮助快速解决打包失败问题。
2026-10-12
6

将Python脚本打包为exe时,常因环境版本不匹配、路径含特殊字符或依赖库方法弃用导致报错。本文介绍从版本校验、路径清理到日志分析与代码修正的标准排查流程,帮助快速解决打包失败问题。
在pandas中处理DataFrame时,布尔索引是最常用的行过滤方式。本文系统梳理单列条件、多条件组合及字符串匹配的写法,结合电影数据集演示完整筛选流程,并提示运算优先级与缺失值处理的易错点,帮助快速准确提取目标数据。
针对生物信息学或网络分析中常见的双向重复记录(即节点A与B的互作被拆分为AB与BA两行),直接调用内置去重方法无法生效。本文详解如何利用字符串字典序构建临时归一化标识,配合apply函数与subset参数精准过滤冗余行,并安全移除辅助列的标准操作流程。
避免陷入资料收集狂热与低效视频跟看误区,本文梳理Python与Linux系统的高效学习流程。通过选用稳定的CentOS环境、搭配结构化在线教材进行主动实操,并结合职业规划聚焦数据分析或Web开发方向,帮助初学者建立清晰的技能提升路线。
本文详细介绍Python内置random模块的核心功能,涵盖生成指定范围浮点数与整数、随机选取列表元素以及原地打乱序列等操作。通过完整的代码示例与运行结果对照,帮助开发者快速掌握随机数生成的标准写法与注意事项,适用于数据分析初始化、游戏逻辑或日常脚本编写。
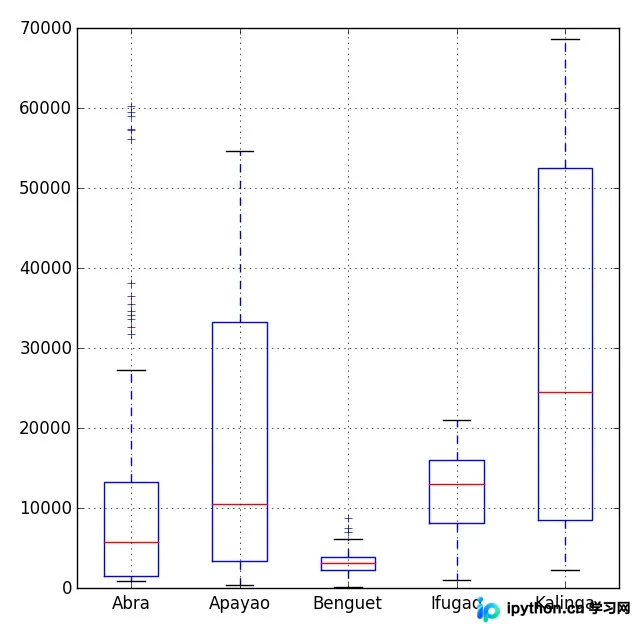
本文详解如何利用Python完成数据分析核心工作流。通过pandas实现CSV数据导入与字段筛选,借助scipy进行单样本t检验等统计推断,并结合matplotlib与seaborn快速生成盒须图、核密度图与回归图。附带现代语法规范与自定义函数编写技巧,助开发者高效掌握数据探索基础操作。
本文系统梳理 Python 标准库 re 模块的常用操作,涵盖字符串替换与拆分、精准匹配验证、分组内容提取及迭代遍历等高频场景。通过演示直接使用模块函数与预编译正则对象的差异,帮助开发者掌握高效、安全的文本处理方案。
针对字符串中夹杂的数字序列及其间隔的逗号,本文演示如何利用Python正则表达式精准定位并移除数字间的分隔符。通过梳理匹配规则与设计迭代替换逻辑,提供可直接运行的代码示例与结果验证方法,帮助开发者高效完成特定格式的数据清洗任务。
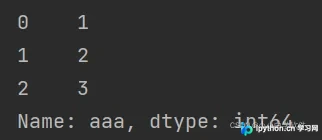
本文详细解析Python中pandas库的pd.Series()函数核心用法。演示如何通过元组、列表、NumPy数组、字典及标量快速构建一维序列,并深度拆解index索引映射、name对象命名与dtype类型强制转换等关键参数配置技巧,帮助开发者高效完成结构化数据的初始化与内存优化。
在使用Pandas处理表格数据时,经常需要核对多列内容的异同。本文通过具体示例演示如何在Python中对比DataFrame的两列数据并生成比对结果。介绍自定义函数逐行判定与直接利用运算符进行向量化计算两种高效方案,附带完整代码与输出结果对照,帮助开发者快速完成数据校验与特征工程中的列匹配任务。
本文详细讲解 Pandas 中 DataFrame 与 Series 的数据排序方法,涵盖基于元素值的 sort_values() 与基于索引标签的 sort_index()。通过 ascending、na_position、inplace 及 axis 等核心参数配置,实现单列/多列升降序排列、缺失值控制及原地更新操作,附带类型冲突排错指南,适用于 Python 数据分析流程中的表结构整理。
在Python数据分析中,频繁需要遍历pandas.DataFrame提取或处理数据。本文系统讲解for循环迭代DataFrame的正确姿势,涵盖逐行、逐列、指定列取值方法,剖析iterrows与itertuples的返回特性及性能差异,并明确指出迭代修改变量不生效的原理,最后给出基于向量化计算的高效替代方案。