Python使用Pandas按条件批量删除表格无效数据
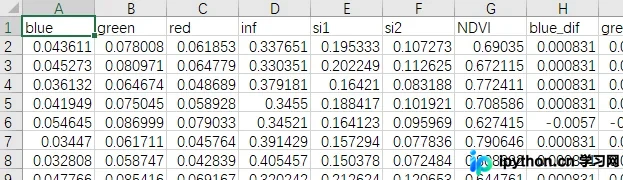
针对包含多列特征的表格数据,本文演示如何使用Python的pandas库,根据指定数值区间自动剔除不符合条件的行。通过布尔索引组合多列筛选条件,高效完成数据清洗并输出新文件,适用于模型训练前的大量样本过滤场景。
2026-10-11
6

针对包含多列特征的表格数据,本文演示如何使用Python的pandas库,根据指定数值区间自动剔除不符合条件的行。通过布尔索引组合多列筛选条件,高效完成数据清洗并输出新文件,适用于模型训练前的大量样本过滤场景。
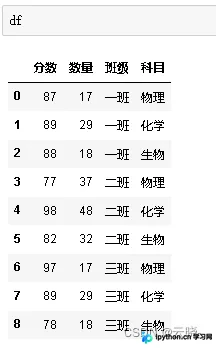
掌握Pandas中DataFrame.replace()函数的核心参数与多种替换场景。本文通过单值、字典映射、列表对应及正则表达式四个实操步骤,演示如何高效清洗数据并规避原地修改的风险,助力Python数据分析流程更稳定。
本文详解Python Pandas中数据分组统计、聚合运算及透视表的实现方法。涵盖groupby的分割、应用与组合流程,演示单列与多列分组统计、缺失值填充技巧。深入解析agg函数的标准与自定义聚合,以及pivot_table和crosstab在数据透视与频率统计中的应用,提供完整代码示例。
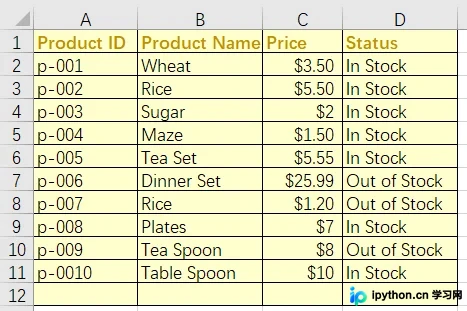
本文详细介绍在Python中将老旧的.xls文件格式转换为现代.xlsx格式的4种常用方法。通过pandas、win32com、xls2xlsx及pyexcel模块,分别演示安装步骤、核心代码与适用场景。读者可根据是否依赖Windows系统、是否需要保留单元格格式等实际需求,选择最合适的脚本方案快速完成批量转换。
在数据处理中快速定位目标记录的具体位置是分析的前置步骤。本文介绍如何通过已知列名、未知列名及全表搜索三种场景,结合布尔索引与 .index 属性精准提取行号,并演示将标签索引转换为实际物理行号的完整代码流程,帮助开发者高效完成数据筛选与定位。
本文介绍使用Python pandas库处理包含重复行和空列的Excel文件。通过设置header=None读取数据,利用notna()生成布尔列表,并对比三种获取False索引的方法:list.index()配合count、遍历判断及enumerate。最终演示如何删除空列、提取首行作为新列名并保存结果,解决数据清洗中的常见难题。
本文详细讲解在Python中进行数据统计分析的核心流程。通过NumPy与SciPy库实现描述性统计、t检验、卡方检验及方差分析,结合Matplotlib完成线性回归拟合与数据可视化。代码可直接运行,附带关键参数说明,帮助快速掌握从数据预处理到结论输出的标准操作。
本文详解Pandas修改特定值的四种核心方法。通过对比Series的map与DataFrame的apply映射机制,演示带参函数与多列运算;结合loc按条件精准替换,以及fillna智能填充缺失值。附带完整代码示例与参数说明,助您高效完成表格数据清洗与字段转换。
本文详细解析 Python 中 &= 运算符的双重运行机制,涵盖按位与赋值与集合交集更新两种场景。通过整数奇偶判断、类型验证及数据结构清洗的完整代码示例,展示如何在不依赖第三方库的情况下高效清理含空值的字典列表,并提供多集合链式求交的技巧,帮助开发者在底层逻辑优化与日常编码中灵活运用该语法。
使用 Python 批量合并多个 Excel 工作表或按固定行数拆分大型表格是日常数据处理的常见需求。本文通过 pandas 与 xlrd/xlwt 库提供两段可直接运行的核心代码,演示如何实现多文件纵向拼接生成新 xlsx 文件,以及如何将超长 xls 表格按指定行数切割并保留原表头。
本文详细介绍如何使用Python的Pandas库读取Excel或CSV表格,通过设定各列数据的数值区间进行条件过滤。演示多条件独立筛选与批量合并筛选的代码实现,快速剔除不符合范围的异常样本行,保留核心数据并导出为新文件。
将Python脚本打包为exe时,常因环境版本不匹配、路径含特殊字符或依赖库方法弃用导致报错。本文介绍从版本校验、路径清理到日志分析与代码修正的标准排查流程,帮助快速解决打包失败问题。